第2章 程序设计语言基础知识
题库 9 · 章节 70 · 共 50 题
1. 关于Python,下列说法正确的是_____ 。
- A. 用try捕获异常,有except,无需执行finally
- B. 可以使用raise关键字来手动抛出异常
- C. except Exception可以捕获所有异常
- D. 可以用switch...case语句表示选择结构
答案:B
解析:
finally关键字在Python中用于定义一个代码块,该代码块在try-except结构中无论是否发生异常,或者在try块中执行了return、break、continue等控制流语句,都会被执行。 当程序出现错误,python会自动引发异常,也可以通过raise显示地引发异常。一旦执行了raise语句,raise后面的语句将不能执行。 在python中,except Exception可以捕获除了 SystemExit 、 KeyboardInterrupt 和 GeneratorExit 之外的所有异常。 如果想捕获这三个异常,将 Exception 改成 BaseException 即可。 python中没有switch...case语句,有结构化模式匹配match...case。
难度 2 · 作答 2553 次 · 正确率 52.4%
2. 执行以下Python语句之后,列表y为_____ 。 x=[1,2,3] y=x+[4,5,6]
- A. 出错
- B. [1,2,3,4,5,6]
- C. [5,7,9]
- D. [1,2,3,[4,5,6]]
答案:B
解析:
在 Python 中,x + [4, 5, 6] 会将两个列表连接起来,得到一个新的列表并赋值给 y ,即[1, 2, 3, 4, 5, 6]。
难度 2 · 作答 2442 次 · 正确率 68.2%
3. 执行以下 Python 语句之后,列表x为_____ 。 x= [1,2,3] x.append([4,5])
- A. [1,2,3,4,5]
- B. [1,2,3]
- C. [4,5]
- D. [1,2,3,[4,5]]
答案:D
解析:
append()函数可以向列表末尾添加元素。
难度 2 · 作答 2463 次 · 正确率 67.4%
4. 在C/C++程序中,对于函数中定义的非静态局部变量,其存储空间在_____分配。
- A. 栈区
- B. 静态数据区
- C. 文本区
- D. 自由堆区
答案:A
解析:
局部变量保存在动态数据区的栈中,只有在所在函数被调用时才动态地为变量分配存储单元。全局变量位于静态数据区中。静态变量属于静态存储方式,其存储空间为内存中的静态数据区。 全局变量 -----> 静态区 静态变量 -----> 静态区 非静态局部变量、形参、返回值 -----> 栈区 动态申请的变量 -----> 堆区 代码 -----> 代码区 常量字符串 -----> 文字常量区
难度 2 · 作答 2264 次 · 正确率 75.0%
5. 程序运行过程中常使用参数在函数(过程)间传递信息,引用调用传递的是实参的______。
- A. 地址
- B. 类型
- C. 名称
- D. 值
答案:A
解析:
程序运行时,对函数的调用一般有两种形式:传值调用和引用调用。 传值调用:形参取的是实参的值,形参的改变不会导致调用点所传的实参的值发生改变。 引用调用:形参取的是实参的地址,即相当于实参存储单元的地址引用,因此,其值的改变同时就改变了实参的值。
难度 2 · 作答 2395 次 · 正确率 87.6%
6. 弱类型语言(动态类型语言)是指不需要进行变量/对象类型声明的语言。______属于弱类型语言。
- A. Java
- B. C/C++
- C. Python
- D. C#
答案:C
解析:
弱/强类型指的是语言类型系统的类型检査的严格程度,动态类型和静态类型则指变量与类型的绑定方法。静态类型是指编译器在编译源程序期间执行的类型检查,动态类型是指编译器(虚拟机)在程序运行时执行的类型检查。简单地说,在声明了一个变量之后,不能改变其类型的语言,是静态语言;能够随时改变其类型的语言,是动态语言。弱类型相对于强类型来说,类型检查更不严格,比如说允许变量类型的隐式转换、允许强制类型转换等。
难度 2 · 作答 2190 次 · 正确率 83.7%
7. 可用于编写独立程序和快速脚本的语言是______。
- A. Python
- B. Prolog
- C. Java
- D. C#
答案:A
解析:
本题考查程序语言基础知识。 脚本语言又被称为扩建的语言,或者动态语言,是一种编程语言,通常以文本(如ASCII)保存,只在被调用时进行解释或编译。Python是一种脚本语言。
难度 2 · 作答 2320 次 · 正确率 88.0%
8. 以下程序设计语言中,______更适合用来进行动态网页处理。
- A. HTML
- B. LISP
- C. PHP
- D. JAVA/C++
答案:C
解析:
本题考查程序语言基础知识。 网页文件本身是一种文本文件,通过在其中添加标记符,可以告诉浏览器如何显示其中的内容。HTML是超文本标记语言,超文本是指页面内可以包含图片、链接,甚至音乐、程序等非文字元素。 PHP(超文本预处理器)是一种通用开源脚本语言,它将程序嵌入到HTML文档中去执行,从而产生动态网页。
难度 2 · 作答 2396 次 · 正确率 56.2%
9. 以下关于C/C++语言指针变量的叙述中,正确的是______。
- A. 指针变量可以是全局变量也可以是局部变量
- B. 必须为指针变量与指针所指向的变量分配相同大小的存储空间
- C. 对指针变量进行算术运算是没有意义的
- D. 指针变量必须由动态产生的数据对象来赋值
答案:A
解析:
本题考查程序语言基础知识。 变量是内存单元的抽象,用于在程序中表示数据。当变量存储的是内存单元地址时,称为指针变量,或者说指针变量指向了另一个变量。指针变量可以定义在函数或复合语句内,也可以定义在所有的函数之外,即可以是全局变量,也可以是局部变量。需要区分指针变量与指针所指向的变量,无论指针变量指向何种变量,其存储空间大小都是一样的。当指针变量指向数组中的一个元素时,对指针变量进行算术运算可以使其指向同一个数组中的其他元素。
难度 2 · 作答 2270 次 · 正确率 71.2%
10. 以下关于变量和常量的叙述中,错误的是______。
- A. 变量的取值在程序运行过程中可以改变,常量则不行
- B. 变量具有类型属性,常量则没有
- C. 变量具有对应的存储单元,常量则没有
- D. 可以对变量赋值,不能对常量赋值
答案:B
解析:
本题考查程序设计语言基础知识。 变量是计算机内存单元的抽象,在程序中表示数据,具有名称、类型、值、地址、作用域、存储类别等属性,其值在运行过程中由指令进行修改。常量也用于在程序中表示数据,但常量在程序运行过程中不能修改,常量也具有类型,如整型常量、浮点型常量、字符串常量等,也称为字面量或文字。常量在程序运行时会被直接使用,而不需要分配存储单元。在程序编译时,常量的值就已经确定了,编译器会直接将常量的值嵌入到程序中。因此,常量不会占用运行时的存储空间。
难度 2 · 作答 2239 次 · 正确率 63.6%
11. 计算机函数t()、f()的定义如下所示,若调用函数t时传递给x的值为5,并且调用函数f()时,第一个参数采用传值(call by value)方式,第二个参数采用传引用(call by reference)方式,则函数t()的返回值为______。 t(int x) f(int r,int &s) int a; a=3x+1; f(x,a); return a-x; int x; x=2s+1;s=x+r; r=x-1; return;
- A. 33
- B. 22
- C. 11
- D. 负数
答案:A
解析:
本题考查程序语言函数调用的参数传递基础知识。 传值调用形参改变不会改变原实参的值,传址调用形参改变会改变原实参的值。当程序执行到函数t中,调用f(x,a)时,x=5,a=16。当程序在f(x,a)中执行完成之后,对r的值的改变,并不会影响原实参值,但对s的修改会改变调用的原实参值,在f(x,a)中执行完成之后s的值变为38,所以对应原实参值a也变为38,而原实参x的值没有改变,仍然是5。最后返回值是:a-x,即38-5=33。
难度 2 · 作答 1979 次 · 正确率 72.3%
12. 以下若C程序的表达式中引用了未赋初值的变量,则______。
- A. 编译时一定会报告错误信息,该程序不能运行
- B. 可以通过编译并运行,但运行时一定会报告异常
- C. 可以通过编译,但链接时一定会报告错误信息而不能运行
- D. 可以通过编译并运行,但运行结果不一定是期望的结果
答案:D
解析:
本题考查程序语言基础知识。 在C程序中,若在某个表达式中引用了未赋初值的变量,那么程序是可以通过编译并运行的,因为程序中并没有语法方面的错误,只是运行的结果可能与我们期望的结果不一致。
难度 2 · 作答 2402 次 · 正确率 61.2%
13. 以下关于汇编语言程序的叙述中,错误的是_____。
- A. 汇编程序的功能是将汇编语言源程序翻译为相应的目标程序
- B. 用汇编语言编写的程序可以直接被计算机硬件执行
- C. 汇编语言是低级程序设计语言
- D. 汇编语言与计算机硬件体系结构密切相关
答案:B
解析:
可以直接被计算机硬件执行的是二进制语言。
难度 2 · 作答 2167 次 · 正确率 64.1%
14. 在某C/C++程序中,整型变量a的值为0且应用在表达式"c=b/a"中,则最可能发生的情形是______。
- A. 编译时报告有语法错误
- B. 编译时报告有逻辑错误
- C. 运行时报告有语法错误
- D. 运行时产生异常
答案:D
解析:
本题考查程序语言基础知识。 对程序中含有变量的表达式求值发生在运行时,若除数为0进行除运算在运行时报告异常。
难度 2 · 作答 2092 次 · 正确率 60.5%
15. 算术表达式b*(a+c)-d的后缀式是 _ 。(+、-、*表示算术的加、减、乘运算,运算符的优先级和结合性遵循惯例)
- A. ba+cd*-
- B. bacd+*-
- C. bac+d*-
- D. bac+*d-
答案:D
解析:
后缀式简单求法:按运算的优先顺序依次将运算符写在运算对象的后面,例如,把写成a+b写成ab+。 对于算术表达式b*(a+c)-d,先处理括号内的 a + c ,得到 ac +。然后乘以 b ,得到 bac + *。最后减去 d ,得到 bac + * d -。
难度 2 · 作答 2019 次 · 正确率 82.0%
16. 算数表达式a+(b-c)*d的后缀式是______(-、+、*表示算数的减、加、乘运算,运算符的优先级和结合性遵循惯例)。
- A. bc-d*a+
- B. abc-d*+
- C. ab+c-d*
- D. abcd-*
答案:B
解析:
本题考查编译程序基本原理基础知识。
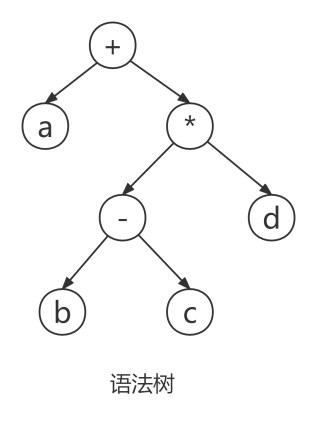
本题要求算术表达式的后缀式,解决该类问题的方法是将算术表达式构造成一棵二叉树,然后对二叉树进行后序遍历得到后缀式。题目中的算术表达式可以构造为如右图所示的语法树。
对二叉树进行后序遍历的结果为  。
难度 2 · 作答 2143 次 · 正确率 72.2%
17. 表达式采用逆波兰式表示时,利用______进行求值。
- A. 栈
- B. 队列
- C. 符号表
- D. 散列表
答案:A
解析:
本题考查程序语言后缀表达式基础知识。 后缀式(逆波兰式)是波兰逻辑学家卢卡西维奇发明的一种表示表达式的方法。这种表示方式把运算符写在运算对象的后面,例如,把a+b写成ab+,所以也称为后缀式。 借助栈可以方便地对后缀式进行求值。方法为:先创建一个初始为空的栈,用来存放运算数。对后缀表达式求值时,从左至右扫描表达式,若遇到运算数,就将其入栈,若遇到运算符,就从栈顶弹出需要的运算数并进行运算,然后将结果压入栈顶,如此重复,直到表达式结束。若表达式无错误,则最后的运算结果就存放在栈顶并且是栈中唯一的元素。
难度 2 · 作答 2122 次 · 正确率 69.2%
18. 在对程序语言进行翻译的过程中,常采用一些与之等价的中间代码表示形式。常用的中间代码表示不包括______。
- A. 树
- B. 后缀式
- C. 四元式
- D. 正则式
答案:D
解析:
本题考查编译程序基本原理基础知识。 高级程序语言编写的程序要想在计算机上执行,就需要翻译,常见的翻译方式有编译和解释两种。在编译的方式下,经常用一些与之等价的中间代码表示形式,而常用的中间代码有树、后缀式、四元式。
难度 2 · 作答 2209 次 · 正确率 53.5%
19. 将高级语言程序翻译为机器语言的过程中,常引入中间代码,其好处是______。
- A. 有利于反编译处理
- B. 有利于进行与机器无关的优化
- C. 尽早发现语法错误
- D. 可以简化语法和语义分析
答案:B
解析:
本题考查程序语言编译基础知识。 "中间代码"是一种简单且含义明确的记号系统,可以有若干种形式,它们的共同特征是与具体的机器无关,此时所做的优化一般建立在对程序的控制流和数据流分析的基础之上,与具体的机器无关。
难度 2 · 作答 2083 次 · 正确率 55.9%
20. 已知某高级语言源程序A经编译后得到机器C上的目标程序B,则______。
- A. 对B进行反编译,不能还原出源程序A
- B. 对B进行反汇编,不能得到与源程序A等价的汇编程序代码
- C. 对B进行反编译,得到的是源程序A的变量声明和算法流程
- D. 对A和B进行交叉编译,可以产生在机器C上运行的动态链接库
答案:A
解析:
本题考查程序语言方面编译基础知识。 编译是将高级语言源程序翻译成机器语言程序(汇编形式或机器代码形式),反编译是编译的逆过程。反编译通常不能把可执行文件还原成高级语言源代码,只能转换成功能上等价的汇编程序。
难度 2 · 作答 2211 次 · 正确率 44.7%
21. 以下关于通过解释器运行程序的叙述中,错误的是_____。
- A. 可以由解释器直接分析并执行高级语言源程序代码
- B. 与直接运行编译后的机器码相比,通过解释器运行程序的速度更慢
- C. 解释器运行程序比运行编译和链接方式产生的机器代码效率更高
- D. 可以先将高级语言程序转换为字节码,再由解释器运行字节码
答案:C
解析:
解释器逐行解释执行源代码,每次执行都要进行解释,效率相对较低。而编译和链接生成的机器代码可以直接被CPU执行,执行效率通常比解释器高。 A选项,解释器可以直接分析并执行高级语言源程序代码,这是解释器的基本功能。 B选项,由于解释器每次执行都要解释代码,相比直接运行编译后的机器码,速度通常更慢。 D选项,例如Java语言,先将高级语言程序转换为字节码,再由解释器运行字节码,这是常见的方式。
难度 2 · 作答 2033 次 · 正确率 56.5%
22. 计算机运以下关于高级程序设计语言翻译的叙述中,正确的是______。
- A. 可以先进行语法分析,再进行词法分析
- B. 在语法分析阶段可以发现程序中的所有错误
- C. 语义分析阶段的工作与目标机器的体系结构密切相关
- D. 目标代码生成阶段的工作与目标机器的体系结构密切相关
答案:D
解析:
本题考查程序语言处理的基础知识。 将高级语言程序翻译为机器语言程序的过程中,需要依次进行词法分析、语法分析、语义分析、中间代码生成、代码优化和目标代码生成等阶段,其中,中间代码生成和代码优化可以省略。 程序中的错误分为语法错误和语义错误,语法分析阶段不能发现语义错误。 语义分析阶段主要处理语法正确的语言结构的含义信息,可以与目标机器的体系结构无关。目标代码生成阶段的工作与目标机器的体系结构是密切相关的。
难度 2 · 作答 2057 次 · 正确率 69.6%
23. 如果将高级语言源程序翻译成目标程序的是______。
- A. 解释程序
- B. 编译程序
- C. 链接程序
- D. 汇编程序
答案:B
解析:
本题考查程序语言基础知识。 计算机只能理解和执行由0、1序列构成的机器语言,因此高级程序语言需要翻译,担负这一任务的程序称为"语言处理程序"。由于应用的不同,语言之间的翻译也是多种多样的。语言处理程序主要分为汇编程序、编译程序和解释程序三种基本类型。 解释程序也称为解释器,它可以直接解释执行源程序,或者将源程序翻译成某种中间表示形式后再加以执行;而编译程序(编译器)则首先将源程序翻译成目标语言程序,然后在计算机上运行目标程序。汇编程序的功能是将汇编语言所编写的源程序翻译成机器指令程序。 链接程序将各目标程序连接形成为可执行程序。
难度 2 · 作答 1956 次 · 正确率 70.4%
24. 在对高级语言源程序进行编译的过程中,为源程序中变量所分配的存储单元的地址属于______。
- A. 逻辑地址
- B. 物理地址
- C. 接口地址
- D. 线性地址
答案:A
解析:
本题考查编译程序基本原理基础知识。 编译过程中为变量分配存储单元所用的地址是逻辑地址,程序运行时再映射为物理地址。
难度 2 · 作答 2116 次 · 正确率 77.0%
25. (复合题 1/2)(1)正确的选项是?
共用题干: 编译过程中,对高级语言程序语句的翻译主要考虑声明语句和可执行语句。对声明语句,主要是将所需要的信息正确地填入合理组织的 (1) 中;对可执行语句,则是 (2) 。
- A. 符号表
- B. 栈
- C. 队列
- D. 树
答案:A
解析:
本题考查程序语言翻译基础知识。 符号表的作用是记录源程序中各个符号的必要信息,以辅助语义的正确性检查和代码生成,在编译过程中需要对符号表进行快速有效地查找、插入、修改和删除等操作。符号表的建立可以始于词法分析阶段,也可以放到语法分析和语义分析阶段,但符号表的使用有时会延续到目标代码的运行阶段。 编译过程中,在确认源程序的语法和语义之后,就可对其进行翻译,同时改变源程序的内部表示。对于声明语句,需要记录所遇到的符号的信息,因此应进行符号表的填查工作。对于可执行语句,需要翻译成中间代码或目标代码。
难度 2 · 作答 2307 次 · 正确率 68.6%
26. (复合题 2/2)(2)正确的选项是?
共用题干: 编译过程中,对高级语言程序语句的翻译主要考虑声明语句和可执行语句。对声明语句,主要是将所需要的信息正确地填入合理组织的 (1) 中;对可执行语句,则是 (2) 。
- A. 翻译成机器代码并加以执行
- B. 转换成语法树
- C. 翻译成中间代码或目标代码
- D. 转换成有限自动机
答案:C
解析:
本题考查程序语言翻译基础知识。 符号表的作用是记录源程序中各个符号的必要信息,以辅助语义的正确性检查和代码生成,在编译过程中需要对符号表进行快速有效地查找、插入、修改和删除等操作。符号表的建立可以始于词法分析阶段,也可以放到语法分析和语义分析阶段,但符号表的使用有时会延续到目标代码的运行阶段。 编译过程中,在确认源程序的语法和语义之后,就可对其进行翻译,同时改变源程序的内部表示。对于声明语句,需要记录所遇到的符号的信息,因此应进行符号表的填查工作。对于可执行语句,需要翻译成中间代码或目标代码。
难度 2 · 作答 2280 次 · 正确率 68.3%
27. 对高级语言源程序进行编译或解释的过程可以分为多个阶段,解释方式不包含______阶段。
- A. 词法分析
- B. 语法分析
- C. 语义分析
- D. 目标代码生成
答案:D
解析:
本题考查程序语言编译与解释的区别基础知识。 用某种高级语言或汇编语言编写的程序称为源程序,源程序不能直接在计算机上执行。汇编语言源程序需要用一个汇编程序将其翻译成目标程序后才能执行。高级语言源程序则需要对应的解释程序或编译程序对其进行翻译,然后在机器上运行。 解释程序也称为解释器,它或者直接解释执行源程序,或者将源程序翻译成某种中间代码后再加以执行;而编译程序(编译器)则是将源程序翻译成目标语言程序,然后在计算机上运行目标程序。这两种语言处理程序的根本区别是:在编译方式下,机器上运行的是与源程序等价的目标程序,源程序和编译程序都不再参与目标程序的执行过程;而在解释方式下,解释程序和源程序(或其某种等价表示)要参与到程序的运行过程中,运行程序的控制权在解释程序。简单来说,在解释方式下,翻译源程序时不生成独立的目标程序,而编译器则将源程序翻译成独立保存的目标程序。
难度 2 · 作答 1954 次 · 正确率 85.9%
28. 以下关于实现高级程序设计语言的编译和解释方式的叙述中,正确的是______。
- A. 在编译方式下产生源程序的目标程序,在解释方式下不产生
- B. 在解释方式下产生源程序的目标程序,在编译方式下不产生
- C. 编译和解释方式都产生源程序的目标程序,差别是优化效率不同
- D. 编译和解释方式都不产生源程序的目标程序,差别在是否优化
答案:A
解析:
本题考查程序语言编译与解释的区别基础知识。 用某种高级语言或汇编语言编写的程序称为源程序,源程序不能直接在计算机上执行。如果源程序是用汇编语言编写的,则需要一个称为汇编程序的翻译程序将其翻译成 目标程序后才能执行。如果源程序是用某种高级语言编写的,则需要对应的解释程序或编译程序对其进行翻译,然后在机器上运行。 解释程序也称为解释器,它可以直接解释执行源程序,或者将源程序翻译成某种中间表示形式后再加以执行;而编译程序(编译器)则首先将源程序翻译成目标语言程序,然后在计算机上运行目标程序。这两种语言处理程序的根本区别是:在编译方式下,机器上运行的是与源程序等价的目标程序,源程序和编译程序都不再参与目标程序的执行过程;而在解释方式下,解释程序和源程序(或其某种等价表示)要参与到程序的运行过程中,运行程序的控制权在解释程序。解释器翻译源程序时不产生独立的目标程序,而编译器则需将源程序翻译成独立的目标程序。
难度 2 · 作答 1913 次 · 正确率 71.9%
29. 大多数程序设计语言的语法规则用______描述即可。
- A. 正规文法
- B. 上下文无关文法
- C. 上下文有关文法
- D. 短语结构文法
答案:B
解析:
本题考查程序语言文法基础知识。 乔姆斯基文法体系共分为短语结构文法、上下文有关文法、上下文有关文法和正规文法4类。 短语结构文法或无限制文法也称为0型文法,其描述能力相当于图灵机,可使用任何的语法描述形式。 上下文有关文法也称为1型文法,其描述能力相当于线性有界自动机,语法形式为:xSy->xAy。也就是说,S(非终结符号)推导出A(非终结符号与终结符号的混合串)是和上下文x,y相关的,即S只有在上下文x,y的环境中才能推导出A。 上下文无关文法也称为2型文法,其描述能力相当于下推自动机,语法形式如下:S->A,即S可以无条件的推导出A,与上下文无关。 正规文法也称为3型文法,等价于正则表达式,其描述能力相当于有穷自动机,语法形式如下:S->Aa,其中最后一个a必须为非终结符。 大多数程序语言的语法现象可用上下文无关文法描述。
难度 2 · 作答 1963 次 · 正确率 68.5%
30. 己知文法G:S→A0|B1,A→S1|1,B→S0|0其中S是开始符号。从S出发可以推导出______。
- A. 所有由0构成的字符串
- B. 所有由1构成的字符串
- C. 某些0和1个数相等的字符串
- D. 所有0和1个数不同的字符串
答案:C
解析:
本题考查程序语言文法基础知识。 用文法表示语言的语法规则时,推导是产生语言句子的基本方式。以题目中的文法为例,推导出1010的过程为S=>AO=>S10=>A010=>1010,推导出0110的过程为 S=>AO=>S10=>B110=>0110,对于0000、1111、1100、0011等则推导不出。因为由S先推导出A0后,再去推导A则必然产生一个与0相邻(在0的左边)的1,而由S先推导出B1,则下一步必然要推导出一个与1相邻(在1的左边)的0。这保证了当1出现时,马上就会出现0,或者反之,且0和1的距离很近。分析更多的例子发现,仅有"某些0和1个数相等的字符串"是正确的。
难度 2 · 作答 1855 次 · 正确率 76.1%
31. 已知文法G:S->A0|B1,A->S1|1,B->S0|0,其中S是开始符号,从S出发可以推导出______。
- A. 所有由0构成的字符串
- B. 所有由1构成的字符串
- C. 某些0和1个数相等的字符串
- D. 所有0和1个数不同的字符串
答案:C
解析:
本题考查程序语言文法基础知识。 对于文法可以推导出的字符串分析,考试一般可以对文法举例,然后总结规律。以本题的文法为例,可以产生的字符串包括:(1)10推导过程:S->A0,A->1。(2)01推导过程:S->B1,B->0。(3)1010 推导过程:S->A0,A->S1,S->A0,A->1。至此,可以了解到,选项A、B、D的描述都是不正确的。
难度 2 · 作答 1790 次 · 正确率 88.0%
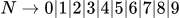
32. 简单算术表达式的结构可以用下面的上下文无关文法进行描述(E为开始符号),______是符合该文法的句子。 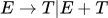
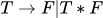

- A.

- B.

- C.

- D.

答案:B
解析:
本题考查程序语言文法基础知识。 可以文法起始符号推导出的句子就是符合该文法的。 推导是从文法的开始符号出发,用产生式右部的文法符号进行替换的过程。用最左推导方式推出2+-34的过程如下: E=>E+T=>T+T=>F+T=>2+T=>2+TF=>2+FF=>2+-FF=>2+-3F=>2+-34 由于文法中没有二元的"-"运算,所以推导不出2--34、24-3,文法中也没有括号,所以推导不出(2+3)*4。
难度 2 · 作答 1870 次 · 正确率 55.0%
33. 某机器字长为语言 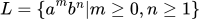 的正规表达式是______。
- A.

- B.

- C.

- D.

答案:B
解析:
本题考查程序语言正规式基础知识。
表示的字符串特点是:若干个a之后跟若干个b,a和b都至少出现1次。
表示的字符串特点是:若干个a之后跟若干个b,a可以不出现,b至少出现1次
表示的字符串特点是:若干个a之后跟若干个b,a至少出现1次,b可以不出现
表示的字符串特点是:若干个a之后跟若干个b,a和b都可以不出现。
语言 中,若干个a之后跟若干个b,a可以不出现,b至少出现一次。
难度 2 · 作答 2038 次 · 正确率 69.3%
34. 以下关于语言 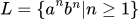 的叙述中,正确的是______。
- A. 可用正规式" "描述,但不能通过有限自动机识别
- B. 可用正规式"
 "表示,但可用有限自动机识别
- C. 不能用正规式表示,但可用有限自动机识别
- D. 不能用正规式表示,也不能通过有限自动机识别
答案:D
解析:
本题考查程序语言有限自动机和正规式基础知识。
中的字符串特点是a的个数与b的个数相同,且所有的a都在b之前,该集合不是正规集,不能用正规式表示。
正规集可用正规式描述,用有限自动机识别。正规式只能表示给定结构的固定次数的重复或没有指定次数的重复。在本题中,指定了重复的次数n,但n又是不固定的,所以也不能用正规式表示。
有限自动机识别的语言是正规语言。对于每个非确定的有限自动机,都有一个与其等价的正规式。若不能用正规式表达,也就不能用非确定的有限自动机识别。
难度 2 · 作答 2035 次 · 正确率 27.7%
35. (复合题 1/2)(1)正确的选项是?
共用题干: 正规集(ab|c)(1|2|3),可以识别的字符种类有 (1) 个,下列 (2) 可被匹配。
- A. 1
- B. 2
- C. 3
- D. 6
答案:D
解析:
正规集(ab|c)(1|2|3)表示的集合为{ab1,ab2,ab3,c1,c2,c3}。
难度 2 · 作答 2029 次 · 正确率 72.4%
36. (复合题 2/2)(2)正确的选项是?
共用题干: 正规集(ab|c)(1|2|3),可以识别的字符种类有 (1) 个,下列 (2) 可被匹配。
- A. ab2
- B. abc
- C. a2
- D. 123
答案:A
解析:
正规集(ab|c)(1|2|3)表示的集合为{ab1,ab2,ab3,c1,c2,c3}。
难度 2 · 作答 1970 次 · 正确率 92.6%
37. 对高级语言程序进行编译的过程中,有限自动机(NFA或DFA)是进行______的适当工具。
- A. 词法分析
- B. 语法分析
- C. 语义分析
- D. 出错处理
答案:A
解析:
本题考查程序语言编译的基础知识。 语言中具有独立含义的最小语法单位是符号(单词),如标识符、无符号常数和界限符等。词法分析的任务是把构成源程序的字符串转换成单词符号序列。有限自动机是一种识别装置的抽象概念,它能准确地识别正规集。有限自动机分为两类:确定的有限自动机(DFA)和不确定的有限自动机(NFA)。
难度 2 · 作答 2092 次 · 正确率 46.0%
38. 以下关于下图所示的有限自动机中,0是初始状态,3是终止状态,该自动机可以识别______。 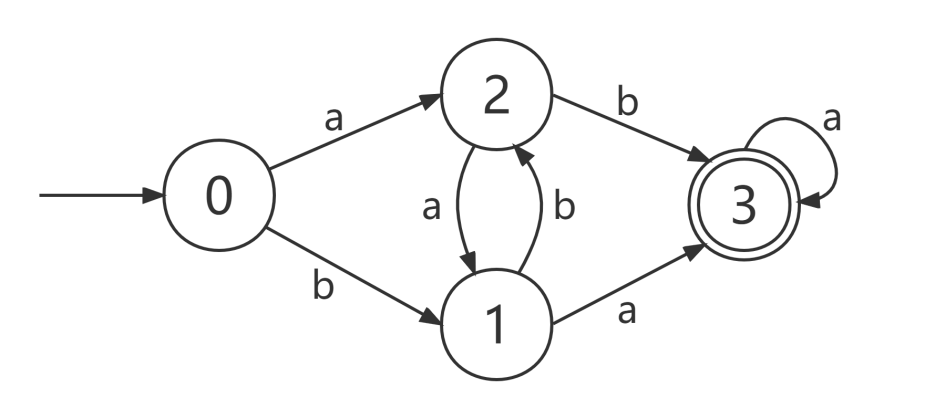
- A. abab
- B. aaaa
- C. bbbb
- D. abba
答案:B
解析:
本题考查程序语言翻译的基础知识。 有限自动机可识别一个字符串的含义是,从有限自动机的初态出发,存在一条到达终态的路径,其上的标记可构成该字符串。若从初态到终态不存在能构成指定字符串的路径,则称该字符串不能被该自动机识别。 对于"abab",其识别路径为状态0→状态2→状态3→状态3,虽然到达终态,但是没有识别出最后的字符"b"。 对于"bbbb",其识别路径为状态0→状态1→状态2→状态3,虽然到达终态,但是没有识别出最后的字符"b"。 对于"abba",其识别路径为状态0→状态2→状态3,虽然到达终态,但是没有识别出"ba"。 对于"aaaa",其识别路径为状态0→状态2→状态1→状态3→状态3,存在从初态到终态的路径标记形成"aaaa",所以可识别。
难度 2 · 作答 1761 次 · 正确率 91.9%
39. 下图所示为一个有限自动机(其中,A是初态、C是终态),该自动机所识别的字符串的特点是______。 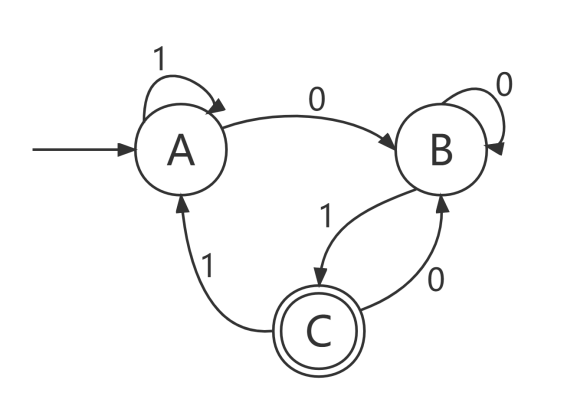
- A. 必须以11结尾的0、1串
- B. 必须以00结尾的0、1串
- C. 必须以01结尾的0、1串
- D. 必须以10结尾的0、1串
答案:C
解析:
本题考查有限自动机和正规式基础知识。 被有限自动机所识别是指从初态开始到终态结束,所输入的字符串能够按顺序地执行下去,若到某个状态不能往下走得到下一个字符,则认为不能识别。 从有限自动机的初态到终态的路径上的标记形成其可识别的字符串。对于题中的自动机,从A出发到达C结束的所有路径中必然包含BC这条弧(标记为1),同时到达B的弧上都标记了0,所以其识别的字符串必须以01结尾。
难度 2 · 作答 1828 次 · 正确率 83.3%
40. (202505)已知list1=[1,2,3,4,5],则list2=[a**2 for a in list1 if a%2==0]列表推导式的结果为 。
- A. [1,2,3,4,5]
- B. [2,3,4,5]
- C. [2,4]
- D. [4,16]
答案:D
解析:
Python推导式是一种独特的数据处理方式,可以从一个数据序列构建另一个新的数据序列的结构体,适用于生成列表、字典、集合和生成器。列表推导式是以列表为载体,以推导的方式将数据生成并放在列表中。推导即规则,它支持for循环和筛选模式(if判断模式)。 首先,我们来看一下列表推导式的结构: a**2是我们要对满足条件的元素执行的操作,即平方。 for a in list1 表示我们要遍历 list1 中的每一个元素。 if a%2==0 是我们的筛选条件,即只选择那些能被2整除的元素(即偶数)。 接下来,我们逐个检查 list1 中的元素: 1不是偶数,所以不被选中。 2是偶数,所以被选中并平方得到 4。 3不是偶数,所以不被选中。 4是偶数,所以被选中并平方得到 16。 5不是偶数,所以不被选中。 因此,经过筛选和平方操作后,list2应该包含 [4, 16],答案选D。
难度 1 · 作答 1396 次 · 正确率 70.1%
41. (202505)执行以下Python语句之后,输出是 。 list1=[1,2,3] list1.append(4) print(list1)
- A. [1,2,3,4[]]
- B. [1,2,3,4]
- C. [4]
- D. [[1,2,3],[4]]
答案:B
解析:
append()函数可以向列表末尾添加元素。
难度 1 · 作答 1193 次 · 正确率 83.7%
42. (202505)以下说法正确的是 。
- A. Python字典的键值可以为任意数据类型
- B. 字符串str可以切片,不能使用下标改变元素
- C. 列表、元组都是不可变数据类型
- D. Set的元素是无序且唯一的,可以使用下标选择元素
答案:B
解析:
A选项,错误。字典的键必须为不可变类型(如字符串、数字、元组),而值可以是任意类型。若键使用列表等可变类型会导致TypeError。 B选项,正确。字符串支持切片(如s[1:3])和索引访问(如s[0]),Python中字符串是不可变类型,无法通过索引修改(如s[0]='a'会报错)。 C选项,错误。列表是可变类型(可增删改元素),元组是不可变类型(创建后无法修改)。 D选项,错误。集合(set)是无序且不重复的数据结构,不支持索引操作,因此不能通过下标来访问元素。
难度 1 · 作答 1433 次 · 正确率 44.7%
43. (202505)下列哪个说法是在传值调用中的应用 。
- A. 将实参的值传递给形参
- B. 将形参的值传递给实参
- C. 实参地址传递给形参
- D. 形参地址传递给实参
答案:A
解析:
函数调用的两种方式: ● 传值调用:将实参的值传递给形参,形参的改变不会导致实参的改变。实参可以是合法的变量、常量或表达式。 ● 引用调用:即传地址调用,将实参的地址传递给形参,即相当于实参存储单元的地址引用,因此形参的值改变的同时,实参的值也跟着改变。实参不能为常量,只能是合法的变量和表达式。
难度 1 · 作答 1210 次 · 正确率 70.5%
44. (202505)编译器将频繁使用的变量(如循环计数器)优化到 中,可以提升访问速度。
- A. 寄存器
- B. 静态存储区
- C. 堆
- D. 栈
答案:A
解析:
编译器优化的核心目标之一是减少内存访问,而寄存器直接集成在CPU中无需通过内存总线访问,其访问速度远高于内存(包括堆、栈等)。 B.静态存储区:存放全局变量和静态变量,生命周期长但访问速度低于寄存器 C.堆:用于动态内存分配(如malloc),访问速度慢且需手动管理。 D.栈:存放函数局部变量,访问速度虽快于堆但仍慢于寄存器,且变量生命周期受限于函数调用。
难度 1 · 作答 1267 次 · 正确率 63.1%
45. (202511)在对高级程序设计语言源程序编译过程中, 是链接源程序中的声明与引用,用以辅助处理变量的声明和引用的一致性。
- A. 符号表
- B. 语法树
- C. 中间代码
- D. 目标代码
答案:A
解析:
符号表的作用是记录源程序中各个符号的必要信息,以辅助语义的正确性检查和代码生成,在编译过程中需要对符号表进行快速有效地查找、插入、修改和删除等操作。符号表的建立可以始于词法分析阶段,也可以放到语法分析和语义分析阶段,但符号表的使用有时会延续到目标代码的运行阶段。 符号表在编译过程中负责登记源程序中出现的所有标识符(变量、函数、类型等)的属性信息,并在后续的语义分析、代码生成阶段通过查找表完成“声明-引用”的一致性检查、作用域解析和地址分配。
难度 1 · 作答 630 次 · 正确率 72.9%
46. (202511)系统调用和普通函数调用的本质区别是 。
- A. 两者运行特权级别相同,均在用户态执行
- B. 系统调用由编译器实现,函数调用由操作系统内核提供
- C. 函数调用通过栈将实参传递给被调用方,系统调用需通过寄存器/内核接口传参
- D. 系统调用无需切换内核态,执行效率高于函数调用
答案:C
解析:
系统调用是用户程序请求操作系统内核提供服务的标准接口。由于操作系统将硬件资源和关键操作(如文件读写、进程创建、网络通信等)保护在内核态(Kernel Mode),用户程序(运行在用户态UserMode)不能直接访问这些资源。因此,必须通过系统调用来“委托”内核代为执行。 普通函数调用是指程序内部或库中定义的函数之间的调用,完全在用户态下完成,不涉及操作系统内核。
难度 1 · 作答 463 次 · 正确率 74.5%
47. (202511)print([x for x in filter(lambda x:x%2,range(5))])的结果是 。
- A. [1,3]
- B. [1,3,5]
- C. [0,2,4]
- D. [2,4]
答案:A
解析:
lambda函数是一种匿名函数,通常用于那些简单的、一次性的函数,这样可以避免定义一个完整的函数。例如,如果你只是想对一个列表的每个元素进行平方操作,你可以使用Lambda函数,而不需要定义一个单独的函数。既然Lambda作为函数,当然允许你将函数作为参数传递给其他函数,这样你就可以在需要的时候创建简单的、匿名的函数。 filter()是Python内置的高阶函数用于过滤序列,其接收两个参数:一个函数和一个可迭代对象,作用是将传入的函数依次作用于可迭代对象的每个元素,然后根据返回值是True还是False决定保留还是丢弃该元素。 在本题中,x的值为0,1,2,3,4, 当x=0时,x%2=0,即False,丢弃; 当x=1时,x%2=1,即True,保留; 当x=2时,x%2=0,即False,丢弃; 当x=3时,x%2=1,即True,保留; 当x=4时,x%2=0,即False,丢弃, 因此结果为[1,3]。
难度 1 · 作答 579 次 · 正确率 35.1%
48. (202511)在Python中,以下创建字典语法正确的是 。
- A. {a:1,b:1}
- B. {'a':1,'b':1}
- C. {'a'=1,'b'=1}
- D. {a=1,b=1}
答案:B
解析:
考查基本的Python语法。在Python中,创建字典的正确语法是使用花括号{},里面的键值对之间用冒号分隔,键如果是字符串必须用引号括起来。
难度 1 · 作答 533 次 · 正确率 65.1%
49. 2026上半年 若某C/C++程序中有表达式"start"+2.71828,则 。
- A. 编译通过,运行时报错
- B. 编译时报错,属于静态语义错误
- C. 编译时报错,属于语法错误
- D. 编译或运行时都不报告错误或警告
答案:B
解析:
"start" 在C/C++中是一个字符串字面量,类型为 const char*(字符指针)。2.71828 是一个 double 类型的浮点数。所以 "start" + 2.71828 实际上是:
const char* + double → 指针 + 浮点数 → 非法。
C/C++中指针算术只允许加减整数(int、long 等),不能加浮点数。编译器会报错。
本题中 "start" + 2.71828:
在语法上合法:表达式 + 表达式 完全符合加法表达式的文法规则
在语义上非法:const char*和double之间不能做加法运算,类型不匹配
因此属于静态语义错误,在编译阶段(语义分析阶段)被检测出来。
难度 1 · 作答 181 次 · 正确率 37.6%
50. 2026上半年 编译器的语义分析常采用语法制导翻译的方法,处理包含变量的表达式的主要目标是 。
- A. 计算表达式的值
- B. 构造表达式的分析树
- C. 生成中间代码
- D. 填写符号表
答案:C
解析:
语法制导翻译是在语法分析的基础上,为每条文法产生式附加语义动作(语义规则),在识别语法结构的同时完成语义处理。
对于包含变量的表达式,语义分析通过语法制导翻译的主要目标是生成中间代码(如三地址码、四元式等)。例如,对于表达式 a + b * c:
语义分析通过语法制导翻译生成:
T1 = b * c ← 三地址码(中间代码)
T2 = a + T1
难度 1 · 作答 205 次 · 正确率 43.9%