第3章 数据结构
题库 9 · 章节 71 · 共 55 题
1. 关于链表操作中,说法正确的是_____。
- A. 新增一个头节点需要遍历链表
- B. 新增一个尾节点需要遍历链表
- C. 删除最后一个节点需要遍历链表
- D. 删除第一个节点需要遍历链表
答案:C
解析:
新增一个头节点通常只需要在链表的开始处插入一个新节点,并将它的 next 指针指向原链表的头节点(如果原链表非空的话)。 新增一个尾节点通常意味着需要找到链表的最后一个节点,并将新节点的 next 指针设置为null(或空值),同时更新最后一个节点的 next 指针以指向新节点,但是,如果链表有一个指向尾部的指针(比如双向链表或某些特定设计的单链表),那么就不需要遍历整个链表来找到尾节点。 为了删除链表的最后一个节点,我们需要找到倒数第二个节点,并将其 next 指针设置为null,所以需要遍历链表来找到删除节点的前一个节点。删除第一个节点通常只需要将头节点指向第二个节点(如果链表非空的话),这个过程并不需要遍历整个链表。
难度 2 · 作答 2315 次 · 正确率 61.0%
2. 线性表采用链表存储结构的特点中不包括_____。
- A. 所需空间大小与表长成正比
- B. 可随机访问表中的任一元素
- C. 插入和删除操作不需要移动元素
- D. 无须事先估计存储空间大小
答案:B
解析:
链式存储是指用结点来存储数据元素,结点的空间可以是连续的,也可以是不连续的,因此存储数据元素的同时必须存储元素之间的逻辑关系。结点空间只有在需要的时候才申请,无须事先分配。 优点:插入和删除操作不需要移动元素,操作方便。 缺点:增加了存储空间开销,不能随机访问任一结点。
难度 2 · 作答 2206 次 · 正确率 66.6%
3. 对于线性表,相比顺序存储,采用链表存储的缺点是______。
- A. 数据元素之间的关系需要占用存储空间,导致存储密度不高
- B. 表中结点必须占用地址连续的存储单元,存储密度不高
- C. 插入新元素时需要遍历整个链表,运算的时间效率不高
- D. 删除元素时需要遍历整个链表,运算的时间效率不高
答案:A
解析:
本题考查线性表基础知识。 链表存储的缺点为数据元素之间的关系需要占用存储空间,导致存储密度不高。
难度 2 · 作答 2097 次 · 正确率 69.6%
4. 若对线性表最常用的操作是访问任意指定序号的元素,并在表尾加入和删除元素,则适宜采用______存储。
- A. 顺序表
- B. 单链表
- C. 双向链表
- D. 哈希表
答案:A
解析:
本题考查线性表基础知识。 线性表的顺序存储方式可以随机存取表中元素,同时在表尾加入和删除元素比在表头等处操作效率高。
难度 2 · 作答 1979 次 · 正确率 72.9%
5. 若对一个链表最常用的操作是在末尾插入结点和删除尾结点,则采用仅设尾指针的单向循环链表(不含头结点)时,______。
- A. 插入和删除操作的时间复杂度都为O(1)
- B. 插入和删除操作的时间复杂度都为O(n)
- C. 插入操作的时间复杂度为O(1),删除操作的时间复杂度为O(n)
- D. 插入操作的时间复杂度为O(n),删除操作的时间复杂度为O(1)
答案:C
解析:
本题考查线性表基础知识。
设尾指针的单向循环链表(不含头结点)如下图所示:
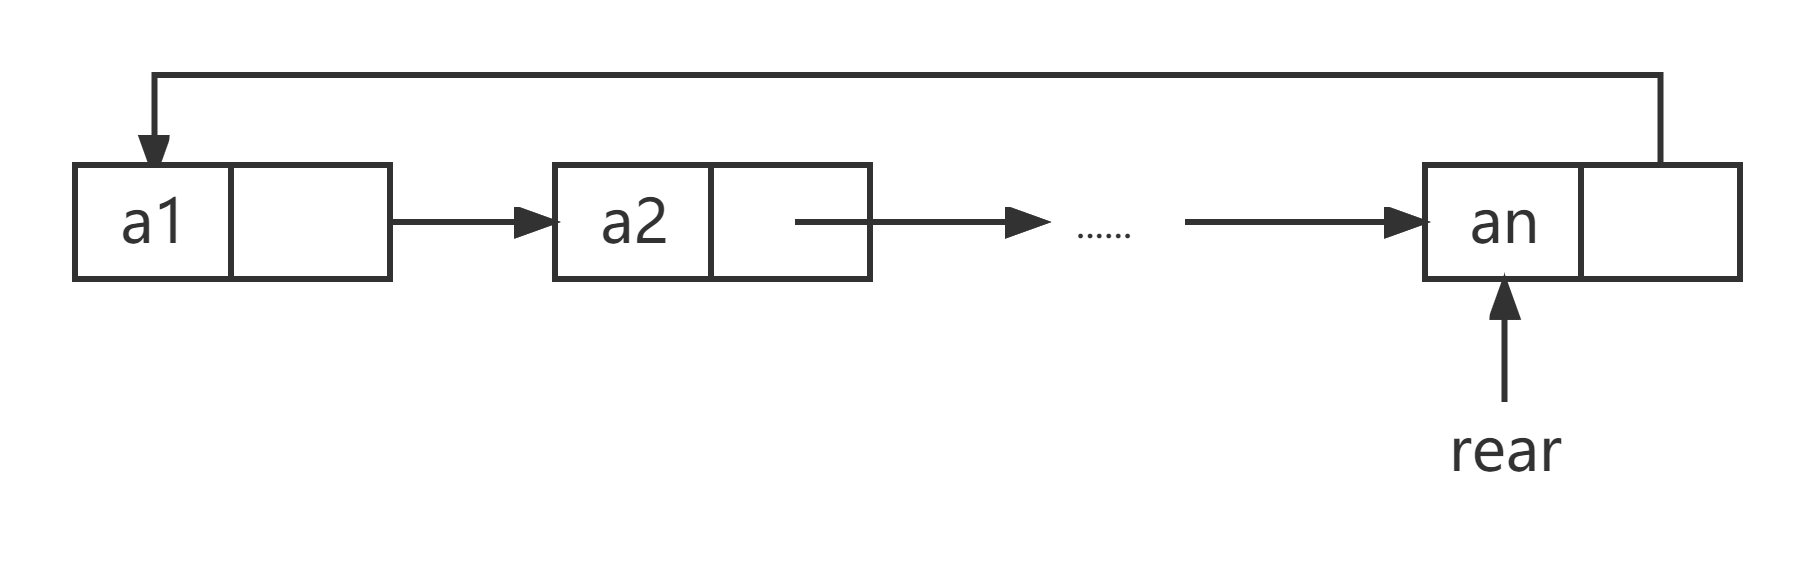 设结点的指针域为next,新结点的指针为s,则在尾指针所指结点后插入结点的操作为:
s->next =t->next; t->next = s;t = s;
也就是插入操作的时间复杂度为
 。
要删除尾指针所指结点,必须通过遍历操作找到尾结点的前驱结点,其操作序列如下:
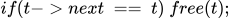

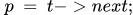
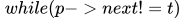
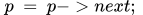
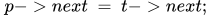


 也就是说,删除操作的时间复杂度为O(n)。
难度 2 · 作答 1864 次 · 正确率 56.5%
6. 在具有  个结点的有序单链表中插入一个新结点并保持有序的运算的时间复杂度为______。
- A.
- B.

- C.

- D.

答案:C
解析:
本题考查线性表基础知识。 在具有n个结点的有序单链表中插入一个新结点时,插入操作本身仅需要修改两个指针,时间主要消耗在顺序地比对需插入的元素与表中元素的大小,从而确定其插入位置。若要插入的元素小于表中的最小元素,则插入该元素时与表中的一个元素进行比较,若要插入的元素大于表中的最大元素,则需要与表中的n个元素全部比较一遍。
难度 2 · 作答 2044 次 · 正确率 61.3%
7. 下面关于栈和队列的叙述,错误的是______。
- A. 栈和队列都是操作受限的线性表
- B. 队列采用单循环链表存储时,只需设置队尾指针就可使入队和出队操作的时间复杂度都为O(1)
- C. 若队列的数据规模 n 可以确定,则采用顺序存储结构比链式存储结构效率更高
- D. 利用两个栈可以模拟一个队列的操作,反之亦可
答案:D
解析:
本题考查栈和队列基础知识。
栈和队列都是操作受限的线性表:栈仅在表尾插入和删除元素;队列仅在表头删除元素、在表尾插入元素。
采用单循环链表表示队列的示意图如下图所示:
①入队时,新元素在an之后,若新元素节点指针为s,则在一般情况下入队操作序列表示为s->next-rear->next;rear->next=s;rear=s;
②出队时,将队头元素ai从队列中删除,一般情况下出队操作序列表示为:
q=rear->next; //q指向队头元素所在节点
rear->next=q->next;
free(q);
入队时初始队列为空、出队后队列变为空要进行特殊处理。
入队操作和出队操作均与队列长度无关,因此其时间复杂度都为O(1)。
队列是先入先出的线性表,栈是后进先出的线性表。一个线性序列经过队列结构后只能得到与原序列相同的元素序列,而经过一个栈结构后则可以得到多种元素序列。用两个栈可以模拟一个队列的入队和出队操作。
难度 2 · 作答 2037 次 · 正确率 58.1%
8. 若元素的入栈元素队列是1、2、3、4、5,若允许出栈操作可在任意可能的时刻进行,则下面的序列中,不可能出现的出栈序列是______。
- A. 3、4、2、5、1
- B. 2、5、4、1、3
- C. 2、3、1、5、4
- D. 3、5、4、2、1
答案:B
解析:
本题考查栈的特点。 栈的特点是先进后出,按照以下步骤可以很快找到答案: (1)选择出栈序列的第一个元素 a,入栈序列中在 a 之前的元素必须按照逆序出现在出栈序列中,如果不按照逆序出栈,则此出栈序列不合法,否则执行下一步。 (2)从入栈序列和出栈序列中将元素 a删除,如果删除 a 后出栈序列为空,则说明此出栈序列合法,否则回到上一步继续执行。 在本题中,B选项的第一个出栈元素为2,在2之前入栈的元素的为1,由于只有一个元素,故无论如何将会逆序出栈在序列中剔除2,则入栈序列为1、3、4、5,出栈序列变为5、4、1、3。分析元素5,在新的入栈序列中,5之前的元素入栈序列为1、3、4,而出栈序列为4、1、3,不满足逆序出栈的条件,所以选项B是不可能出现的出栈序列。
难度 2 · 作答 1756 次 · 正确率 86.5%
9. 若元素a,b,c,d,e,f依次进栈,允许进栈、退栈操作交替进行。但不允许连续三次进行退栈工作,则不可能得到的出栈序列是______。
- A. dcebfa
- B. cbdaef
- C. bcaefd
- D. afedcb
答案:D
解析:
本题考查栈的特点。 栈按照后进先出的原则操作数据。 选项A可以按照a入栈、b入栈、c入栈、d入栈、d出栈、c出栈、e入栈、e出栈、e出栈、b出栈、f入栈、f出栈、a出栈的方式得到。只有连续2次出栈操作,符合试题要求。 选项B可以按照a入栈、b入栈、c入栈、c出栈、b出栈、b出栈、d入栈、d出栈、a出栈、e入栈、e出栈、f入栈、f出栈的方式得到。只有连续2次出栈操作,符合试题要求。 选项C可以按照a入栈、b入栈、b出栈、c入栈、c出栈、a出栈、d入栈、e入栈、e入栈、e出栈、f入栈、f出栈、d出栈的方式得到。只有连续2次出栈操作,符合试题要求。 选项D可以按照a入栈、a出栈、b入栈、c入栈、d入栈、e入栈、f入栈、f入栈、f出栈、e出栈、d出栈、c出栈、b出栈的方式得到,但这个顺序不符合题目中不允许连续三次进行退栈的要求。
难度 2 · 作答 1851 次 · 正确率 74.6%
10. 若循环队列以数组 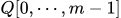 作为其存储结构,变量rear表示循环队列中队尾元素的实际位置,其移动按
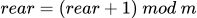 进行,变量length表示当前循环队列中的元素个数,则循环队列的队首元素的实际位置是______。
- A.
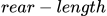
- B.
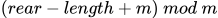
- C.
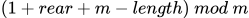
- D.

答案:C
解析:
本题考查循环队列的特点。
其中这种题目在考场上最好的解决方法是找一个实际的例子,往里面一套便知道了。下面解释一下原理。因为  表示的是队列尾元素的实际位置(注意,不是队尾指针)。而且题中有"移动按
 进行",这说明:队列存放元素的顺序为
 。所以在理想情况下
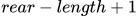 能算出队首元素的位置,即当
 时,
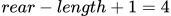 ,
 就是正确的队首元素实际位置。但 有一种情况无法处理,即当
 时,无法算出。
所以在
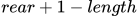 的基础上加上
 再与 求模,以此方法来计算。
难度 2 · 作答 1878 次 · 正确率 62.2%
11. 某双端队列如下图所示,要求元素进出队列必须在同一端口,即从A端进入的元素必须从A端出,从B端进入的元素必须从B端出,则对于四个元素的序列e1、e2、e3、e4,若要求前两个元素e1、e2从A端按次序全部进入队列,后两个元素e3、e4从B端按次序全部进入队列,则可能得到的出队序列是______。 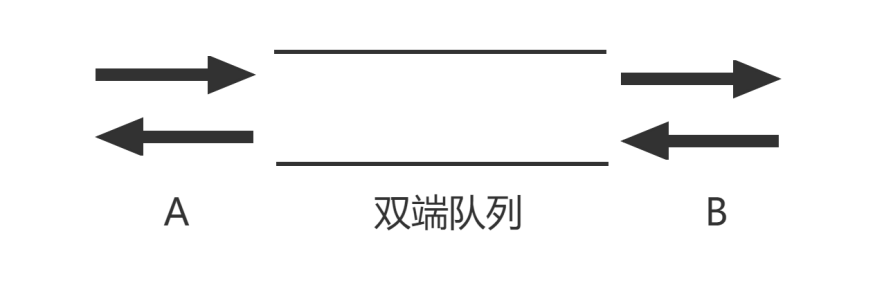
- A. e1、e2、e3、e4
- B. e2、e3、e4、e1
- C. e3、e4、e1、e2
- D. e4、e3、e2、e1
答案:D
解析:
本题考查双端队列。 根据题意,从A端进入的元素必须从A端出,从B端进入的元素必须从B端出,则A端的出队顺序是e2、e1,B 端的出队顺序是e4、e3。只有D选项符合要求。
难度 2 · 作答 1719 次 · 正确率 57.8%
12. 某队列允许在其两端进行入队操作,但仅允许在一端进行出队操作。若元素a、b、c、d依次全部入队列,之后进行出队列操作,则不能得到的出队序列是_____。
- A. dbac
- B. cabd
- C. acdb
- D. bacd
答案:C
解析:
首先入队的是a,其次入队的是b,那么b肯定在紧邻a的"左边"或"右边",又因为仅允许在一端进行出队,因此在出队时必有ab或ba,答案C不可能。
难度 2 · 作答 1728 次 · 正确率 67.9%
13. 在字符串的KMP算法中,需先求解模式串的next函数值,其定义如下式所示,j表示模式串中字符的序号(从1开始)。若模式串p为"abaac",则其next函数值为______。 
- A. 01234
- B. 01122
- C. 01211
- D. 01111
答案:B
解析:
本题考查字符串  算法基础知识。
考察字符串的 算法。关键在于理解公式,而后从1开始代入,过程如下:
 时,
 为
 ,此时输出
 ;
 时,
 为
 ,比较中间的判断条件,
 ,但 ,故
 为空,因此
 ;
 时,
 ,此时 只能等于2, 不等于 ,故不能满足中间的情况,此时
 ;
 时, 可以等于2或3,判断发现
 时满足但
 时不满足,故
 ,再取
 , 可以等于2或3或4,比较
 和右边那个等式,发现 时成立,
 ,答案为B。
难度 2 · 作答 1603 次 · 正确率 57.9%
14. 已知二维数组A按行优先方式存储,每个元素占2个存储单元,第一个元素A[0][0]的地址为100,元素A[3][3]的存储地址是220,则元素A[5][5]的地址是_____。
- A. 300
- B. 306
- C. 310
- D. 296
答案:A
解析:
套公式:对于数组a[m][n],按行优先存储,a[i][j]的存储地址为a+(i*n+j)len。 A[3][3] = 100 + (3n+3)*2 = 220,推导出 n = 19;A[5][5] = 100+(5 * 19 +5) * 2 = 300,本题选A。
难度 2 · 作答 1591 次 · 正确率 61.3%
15. 若有数组声明 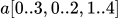 ,设编译时为 分配的存储空间首地址为
 ,且每个数组元素占据一个存储单元。当元素以行序存放(即按
 ),则数组元素
 在其存储空间中相对 的偏移量是______。
- A. 8
- B. 12
- C. 33
- D. 48
答案:C
解析:
本题考查数据结构的多维数组。
以前学过的是二维数组的存储,按"行"或"列"来保存,然后求某元素相对于首地址的偏移量。但这个题目是考查三维数组,更复杂,但是道理是一样的。按"行"序来存,仍是从最后一维开始,再往左到第一维进行变化。题目中数组a的大小为4行、3
列、4
纵,这里要注意题目给出的下标,则数组元素 的位置处在第3行、第3列、第2纵,求它的偏移量分两部分,第一部分,前两行的偏移位置是234=24;第二部分,在第3行的偏移位置是24+1=9。则数组元素 在其存储空间中相对 的偏移量是234+24+1=33,C选项正确。
难度 2 · 作答 1480 次 · 正确率 60.3%
16. 设有如下所示的下三角矩阵 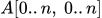 ,将该三角矩阵的非零元素(即行下标不小于列下标的所有元素)按行优先压缩存储在数组
 中,则元素
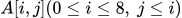 存储在数组
 的______中。
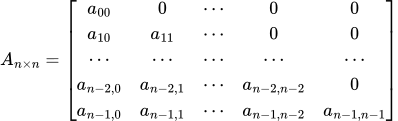
- A.
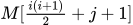
- B.
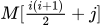
- C.
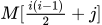
- D.
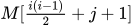
答案:A
解析:
本题考查数组与矩阵基础知识。
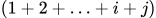
如题图所示,按行方式压缩存储时,  前的元素数目为
 个,数组 的下标从
 开始,因此
 的值存储在 。
特殊值代入法,取
 ,得到第2个元素,对应矩阵中的
 ,因此将
 代入所给答案选项中,只有选项A的值为2,因此答案选A。
难度 2 · 作答 1681 次 · 正确率 61.7%
17. 设  为广义表,将
 定义为取非空广义表的第一个元素,
 定义为取非空广义表除第一个元素外剩余元素构成的广义表。若广义表
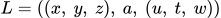 ,则从 中取出原子项
 的运算是______。
- A.
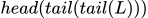
- B.
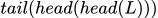
- C.
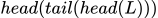
- D.
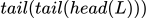
答案:C
解析:
本题考查广义表基础知识。
广义表是函数式语言中使用的一种数据结构。根据广义表取表头和取表尾的定义,对于广义表 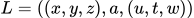 ,运算
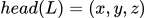 ,而tail(L)=(a,(u,t,w)),因此原子项y应从head(L)中取,对(x,y,z)取表头可得到原子项x,因此从L中取出原子项y的运算为head(tail(head(L)))。
难度 2 · 作答 1547 次 · 正确率 78.9%
18. 若广义表 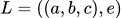 ,则 的长度和深度分别为______。
- A. 2和1
- B. 2和2
- C. 4和2
- D. 4和1
答案:B
解析:
本题考查广义表基础知识。
广义表记作 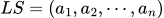 ,其中LS是广义表名, 是它的长度,所以本表的长度为
 。而广义表中嵌套括号的层数为其深度,所以 的深度为2。
难度 2 · 作答 1691 次 · 正确率 59.2%
19. 下面关于二叉树的叙述,正确的是______。
- A. 完全二叉树的髙度h与其节点数n之间存在确定的关系
- B. 在二叉树的顺序存储和链式存储结构中,完全二叉树更适合采用链式存储结构
- C. 完全二叉树中一定不存在度为1的节点
- D. 完全二叉树中必定有偶数个叶子节点
答案:A
解析:
本题考查二叉树基础知识。
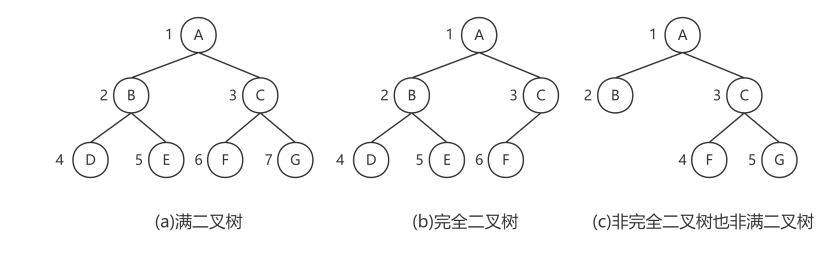
根据其定义,一棵完全二叉树除了最后一层外,其余层的节点数都是满的,最后一层的节点也必须自左至右排列,例如图(a)是高度为3的满二叉树,图(b)是完全二叉树,图(c)不是完全二叉树。
 二叉树采用顺序存储结构时,对于编号为i的节点,则有:
●若i=1时,该节点为根节点,无双亲;
●若i>1时,该节点的双亲节点为[i/2];
●若2i≤n,则该节点的左孩子编号为2i,否则无左孩子;
●若2i+l≤n,则该节点的右孩子编号为2i+1,否则无右孩子。
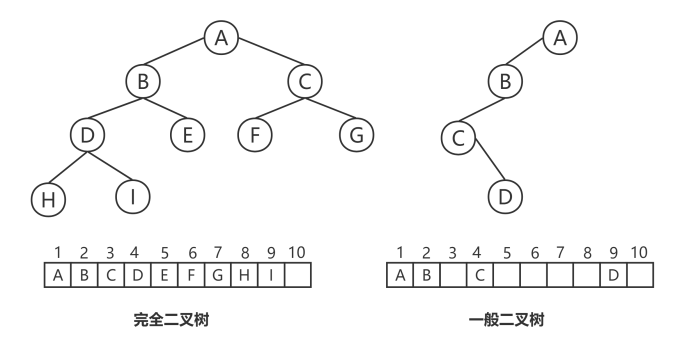
下图为具有9个节点的完全二叉树及其顺序存储结构和某非完全二叉树的顺序存储结构,从中可以看出,完全二叉树适合采用顺序存储结构。
 可以推导出具有 个节点的完全二叉树的深度为
 。
难度 2 · 作答 1693 次 · 正确率 58.1%
20. 已知某二叉树的中序、层次遍历序列分别为DBAFCE、FDEBCA,则该二叉树的后序序列为______。
- A. BCDEAF
- B. ABDCEF
- C. DBACEF
- D. DABECF
答案:B
解析:
本题考查二叉树遍历基础知识。
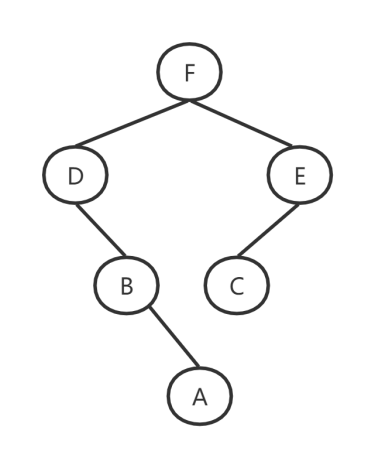
在本题目中,首先根据层序序列的第一个结点为根,即F为根结点,然后根据中序序列划分左、右子树分别为DBA和CE,因此得知根的左右子树都不为空,也就是说层序序列中的D、E分别是F的左子结点和右子结点。由于中序序列中C在E之前,因此C为E的左子树根,而在F的子树D上,B、A在D之后,即说明D的左子树为空,B、A为其右子树的结点且B、A两结点形成父子结点关系。在层序序列中B在A之前,因此A是B的右子结点。因此该二叉树如下图所示。
难度 2 · 作答 1545 次 · 正确率 66.5%
21. 当一棵非空二叉树的_____时,对该二叉树进行中序遍历和后序遍历所得的序列相同。
- A. 每个非叶子结点都只有左子树
- B. 每个非叶子结点都只有右子树
- C. 每个非叶子结点的度都为 1
- D. 每个非叶子结点的度都为 2
答案:A
解析:
一棵非空二叉树,若后序遍历与中序遍历的序列相同,则该二叉树所有结点均无右孩子。
难度 2 · 作答 1457 次 · 正确率 74.9%
22. 若一棵哈夫曼树共有13个顶点,则其叶子结点的个数为______。
- A. 5
- B. 6
- C. 7
- D. 8
答案:C
解析:
本题考查哈夫曼树的特点。
哈夫曼首先给出了对于给定的叶子数目及其权值构造最优二叉树的方法,根据这种方法构造出来的二叉树称为哈夫曼树。具体过程如下所述。
假设有 个权值,则构造出的哈夫曼树有 个叶子结点。 个权值分别设为 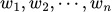 ,则哈夫曼树的构造规则如下:
(1)将 ,看成是有n棵树的森林(每棵树仅有一个结点)。
(2)在森林中选出两个根结点的权值最小的树,作为一棵新树的左、右子树,且新树的根结点权值为其左、右子树根结点权值之和。
(3)从森林中删除选取的两棵树,并将新树加入森林。
(4)重复第(2)和第(3)步,直到森林中只剩一棵树为止,该树即为所求的哈夫曼树。
从以上构造过程可知,哈夫曼树是严格的二叉树,没有度数为 的分支结点。设二叉树的度为
 的结点(即叶子结点)数为
 ,度为 的结点数为
 ,则树的总结点数
 。又因为二叉树有性质对任何一棵二叉树,如果其叶子结点数为 ,度为 的结点数为 ,则
 。所以
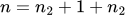 。即
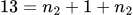 ,
 ,
 。
难度 2 · 作答 1454 次 · 正确率 61.3%
23. 一棵哈夫曼树共有127个结点,对其进行哈夫曼编码,共能得到_____个字符的编码。
- A. 64
- B. 127
- C. 63
- D. 126
答案:A
解析:
哈夫曼树并不是满二叉树,是正则二叉树(也叫正规二叉树),即其中只有度为0和度为2的结点。因为n0=n2+1,n=n0+n2;所以n=2n0-1,即n0=(n+1)/2,n=127叶子结点 n0=64。注:待编码的字符均保存在叶子节点里。
难度 2 · 作答 1485 次 · 正确率 56.6%
24. (复合题 1/2)(1)正确的选项是?
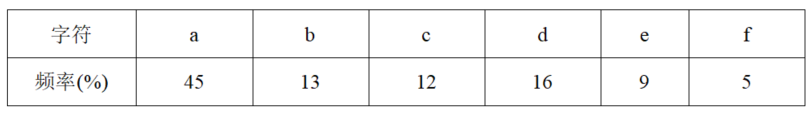
共用题干: 已知一个文件中出现的各字符及其对应的频率如下表所示。若采用定长编码,则该文件中字符的码长应为(1) 。若采用Huffman编码,则字符序列"face"的编码应为(2) 。
- A. 2
- B. 3
- C. 4
- D. 5
答案:B
解析:
本题考查哈夫曼编码。
字符在计算机中是用二进制表示的,每个字符用不同的二进制编码来表示。码的长度影响存储空间和传输效率。若是定长编码方法,用2位码长,只能表示4个字符,即00、01、10和11;若用3位码长,则可以表示8个字符,即000、001、010、011、100、101、110、111。对于题中给出的例子,一共有6个字符,因此采用3位码长的编码可以表示这些字符。
Huffman编码是一种最优的不定长编码方法,可以有效的压缩数据。要使用Huffman
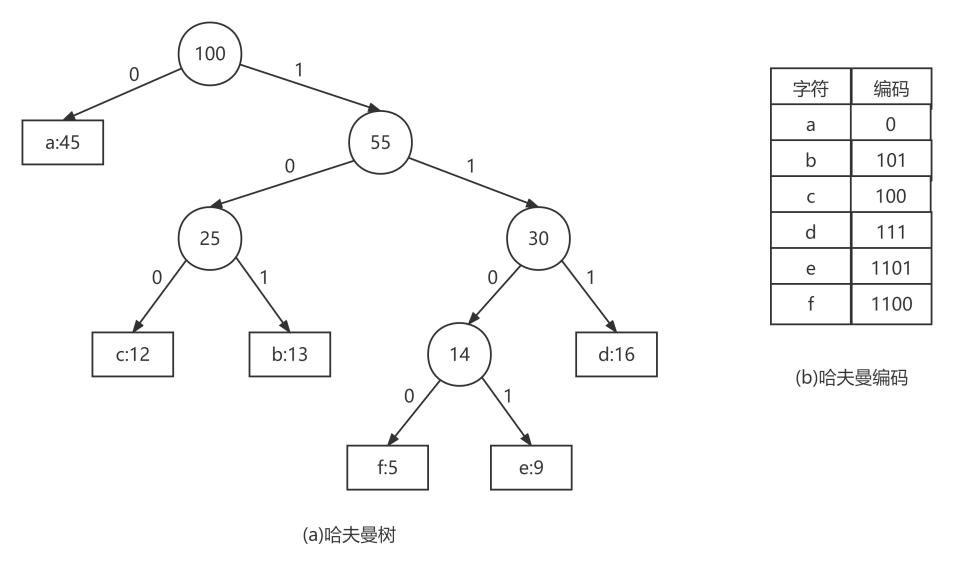
编码,除了知道文件中出现的字符之外,还需要知道每个字符出现的频率。下图(a)是题干中给出对应的编码树,可以看到,每个字符及其对应编码为图(b),因此字符序列"face"的编码应为110001001101,即65选择A。
难度 2 · 作答 1591 次 · 正确率 52.4%
25. (复合题 2/2)(2)正确的选项是?
共用题干: 已知一个文件中出现的各字符及其对应的频率如下表所示。若采用定长编码,则该文件中字符的码长应为(1) 。若采用Huffman编码,则字符序列"face"的编码应为(2) 。
- A. 110001001101
- B. 001110110011
- C. 101000010100
- D. 010111101011
答案:A
解析:
本题考查哈夫曼编码。
字符在计算机中是用二进制表示的,每个字符用不同的二进制编码来表示。码的长度影响存储空间和传输效率。若是定长编码方法,用2位码长,只能表示4个字符,即00、01、10和11;若用3位码长,则可以表示8个字符,即000、001、010、011、100、101、110、111。对于题中给出的例子,一共有6个字符,因此采用3位码长的编码可以表示这些字符。
Huffman编码是一种最优的不定长编码方法,可以有效的压缩数据。要使用Huffman
编码,除了知道文件中出现的字符之外,还需要知道每个字符出现的频率。下图(a)是题干中给出对应的编码树,可以看到,每个字符及其对应编码为图(b),因此字符序列"face"的编码应为110001001101,即65选择A。
难度 2 · 作答 1472 次 · 正确率 68.7%
26. 一个具有967个结点的完全二叉树,其叶子结点数为______。
- A. 483
- B. 484
- C. 485
- D. 486
答案:B
解析:
本题考查完全二叉树的特点。
假设 为度为0的结点总数(即叶子结点数),  为度为 的结点总数, 为度为 的结点总数,由二叉树的性质可知
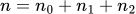 (1)
其中n为完全二叉树的结点总数。又根据二叉树的定义,有
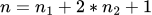 (2)
由公式(1)和(2)可得
 (3)
把(3)式代入(1)式,可得
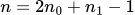 (4)
根据本题的条件,有
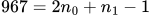 ,即
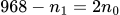 。现在只需确定 就能求得 了。根据完全二叉树的定义,一棵
 层的完全二叉树,上面的
 层为满二叉树,最后一层的结点都靠左边,又因为满二叉树中只有度为 和度为 的结点,没有度为 的结点,这也就意味着在完全二叉树中,只有倒数第二层,才可能有度为 的结点,这就限制了完全二叉树只可能有 个或 个度为 的结点,对于 , 显然为0,所以
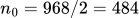 。
难度 2 · 作答 1606 次 · 正确率 72.4%
27. 由元素序列(27,16,75,38,51)构造平衡二叉树,则首次出现最小不平衡子树的根(即离插入结点最近且平衡因子的绝对值为2的结点)为______。
- A. 27
- B. 38
- C. 51
- D. 75
答案:D
解析:
本题考查平衡二叉树的构造过程。
平衡二叉树的构造过程如下图所示:
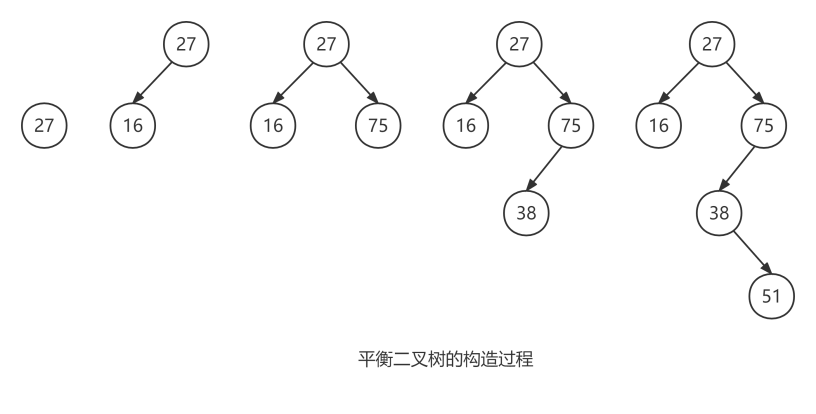 根据题中要求,首次出现最小不平衡子树的根就是75。
难度 2 · 作答 1522 次 · 正确率 42.9%
28. 对于一棵树,每个结点的孩子结点个数称为结点的度,结点度数的最大值称为树的度。某树T的度为4,其中有5个度为4的结点,8个度为3的结点,6个度为2的结点,10个度为1的结点,则T中的叶子结点个数为_____。
- A. 38
- B. 29
- C. 66
- D. 57
答案:A
解析:
在一棵树中,存在n=m+1,其中n为结点的个数,m为边的个数。假设叶子结点个数为x,则可得出下方等式 5 + 8 + 6 + 10+ x = 5 * 4 + 8 * 3 + 6 * 2 + 10*1 + 1;得出x = 38。
难度 2 · 作答 1261 次 · 正确率 61.1%
29. 已知一棵度为3的树(一个节点的度是指其子树的数目,树的度是指该树中所有节点的度的最大值)中有5个度为1的结点,4个度为2的结点,2个度为3的结点,那么,该树中的叶子结点数目为______。
- A. 10
- B. 9
- C. 8
- D. 7
答案:B
解析:
本题考查树的基本计算。 设树中的节点总数为n、分支数目为m,那么n=5+4+2+叶子节点数,m=5×1+4×2+2×3。 在树中,节点总数等于分支数目加上1,即n=m+1。
难度 2 · 作答 1209 次 · 正确率 72.4%
30. 在一棵度为4的数T中,若有20个度为4的结点,10个度为3的结点,1个度为2的结点,10个度为1的结点,则树T的叶子结点的个数是______。
- A. 41
- B. 82
- C. 113
- D. 122
答案:B
解析:
本题考查树的基本计算。 在树中,除根结点外,其余所有结点都是由双亲结点引出的。一个度为n的结点表示由该结点引出n个孩子结点,因此,树T的结点个数为204+103+12+101+1=123,其中最后的1为根结点,则叶子结点数为123-(20+10+1+10)=82个。
难度 2 · 作答 1363 次 · 正确率 81.8%
31. 森林的叶子节点是_____。
- A. 二叉树中没有左孩子的节点
- B. 二叉树中没有右孩子的节点
- C. 森林中度为0的节点
- D. 二叉树中度为1的节点
答案:C
解析:
叶子结点是指度为0的结点,也称为终端结点。
难度 2 · 作答 1466 次 · 正确率 75.4%
32. 下面关于图(网)的叙述,正确的是______。
- A. 连通无向网的最小生成树中,顶点数恰好比边数多1
- B. 若有向图是强连通的,则其边数至少是顶点数的2倍
- C. 可以采用AOV网估算工程的工期
- D. 关键路径是AOE网中源点至汇点的最短路径
答案:A
解析:
本题考查图基础知识。 在有向图中,若以顶点表示活动,用有向边表示活动之间的优先关系,则称这样的有向图为以顶点表示活动的网(Activity On Vertex Network,AOV)。 若在带权有向图G中以顶点表示事件,以有向边表示活动,边上的权值表示该活动持续的时间,则这种带权有向图称为用边表示活动的网(Activity On Edge Network,AOE网)通常在AOE网中列出了完成预定工程计划所需进行的活动、每项活动的计划完成时间、要发生哪些事件以及这些事件和活动间的关系,从而可以分析该项工程是否实际可行并估计工程完成的最短时间,分析出哪些活动是影响工程进度的关键。进一步可以进行人力、物力的调度和分配,以达到缩短工期的目的。 根据生成树的定义,有n个顶点的连通图的生成树中恰好有n-1条边。
难度 2 · 作答 1297 次 · 正确率 56.3%
33. 若G是一个具有36条边的非连通无向图(不含自回路和多重边),则图G至少有_____个顶点。
- A. 11
- B. 10
- C. 9
- D. 8
答案:B
解析:
本题考查非连通图的概念。 因为G为非连通图,所以G中至少含有两个连通子图,而且该图不含有回路和多重边。题目问的是至少有多少个顶点,因此一个连通图可看成是只有1个顶点,另一个连通图可看成是一个完全图(因为完全图在最少顶点的情况下能得到的边数最多),这样,该问题就转化为"36条边的完全图有多少个顶点",因为具有n个顶点的无向完全图的边的条数为n×(n-1)/2,可以算出n=9满足条件。再加上另一个连通图(只有一个顶点),则图G至少有10个顶点。
难度 2 · 作答 1450 次 · 正确率 39.4%
34. 对下列有向图的邻接矩阵,进行深度遍历的次序是_____。 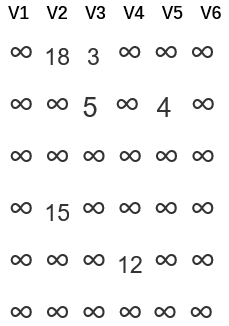
- A. v1-v2-v3-v4-v5-v6
- B. v1-v4-v2-v3-v5-v6
- C. v1-v2-v3-v5-v4-v6
- D. v1-v2-v5-v4-v3-v6
答案:C
解析:
深度优先搜索 :类似于树的先根遍历。①第一步:访问一顶点V;②第二步:依次搜索顶点V的所有邻接顶点;③第三步:若邻接顶点未被访问,则深度优先搜索邻接顶点,若已被访问,则跳到顶点V的下一个邻接顶点。
难度 2 · 作答 1343 次 · 正确率 51.8%
35. 在29个元素构成的查找表中查找任意一个元素时,可保证最多与表中5个元素进行比较即可确定查找结果,则采用的查找表及查找方法是_____。
- A. 二叉排序树上的查找
- B. 顺序表上的顺序查找
- C. 有序顺序表上的二分查找
- D. 散列表上的哈希查找
答案:C
解析:
最坏情况下,二叉排序树是一颗单树(只有左子树或只有右子树),时间复杂度为O(n),所以5次不满足题意;顺序表最坏情况下也是O(n),即走完整个顺序表;二分查找时间复杂度O(logn),介于4与5之间 ,4 < log 29<5,满足题意,所以选C;哈希查找,用key%m取余,在散列上最坏情况下也是O(n),其平均查找长度依赖于哈希表的装填因子α=表中装入的记录数/哈希表的长度。
难度 2 · 作答 1345 次 · 正确率 76.1%
36. 下面关于查找运算及查找表的叙述,错误的是______。
- A. 哈希表可以动态创建
- B. 二叉排序树属于动态查找表
- C. 二分查找要求查找表采用顺序存储结构或循环链表结构
- D. 顺序查找方法既适用于顺序存储结构,也适用于链表结构
答案:C
解析:
本题考查数据结构基础知识。 哈希表和二叉排序树都可以在查找过程中动态创建,属于动态查找表。顺序查找方法按照设定的次序依次与查找表中元素的关键字进行比较,在顺序存储结构和链表结构上都可以实现该查找过程。二分查找需要对中间元素进行快速定位,在链表结构上无法实现。
难度 2 · 作答 1346 次 · 正确率 57.0%
37. (复合题 1/2)(1)正确的选项是?
共用题干: 以下关于折半查找的叙述中,不正确的是 (1) 。采用折半查找等概率查找某个包含8个元素的有序表,查找成功的平均查找长度为 (2) 。
- A. 是一个分治算法
- B. 只能应用于有序表
- C. 查找成功和不成功的平均查找长度是一样的
- D. 若表长为 n,时间复杂度为O(logn)
答案:C
解析:
折半查找(二分查找): 先给数据排序,形成有序表,把待查数据值与查找范围的中间元素值进行比较,会有四种情况出现: ①待查找数值与中间元素值相等,返回中间元素值的索引。②待查找数值比中间元素值小,则以整个查找范围的前半部分作为新的查找范围,执行①,直到找到相等的值。③待查找数值比中间元素值大,则以整个查找范围的后半部分作为新的查找范围,执行①,直到找到相等的值。④如果最后找不到相等的值,则返回错误提示信息。
难度 2 · 作答 1629 次 · 正确率 60.1%
38. (复合题 2/2)(2)正确的选项是?
共用题干: 以下关于折半查找的叙述中,不正确的是 (1) 。采用折半查找等概率查找某个包含8个元素的有序表,查找成功的平均查找长度为 (2) 。
- A. 9/8
- B. 1/8
- C. 20/8
- D. 21/8
答案:D
解析:
折半查找(二分查找): 先给数据排序,形成有序表,把待查数据值与查找范围的中间元素值进行比较,会有四种情况出现: ①待查找数值与中间元素值相等,返回中间元素值的索引。②待查找数值比中间元素值小,则以整个查找范围的前半部分作为新的查找范围,执行①,直到找到相等的值。③待查找数值比中间元素值大,则以整个查找范围的后半部分作为新的查找范围,执行①,直到找到相等的值。④如果最后找不到相等的值,则返回错误提示信息。
难度 2 · 作答 1619 次 · 正确率 53.9%
39. 在有11个元素的有序数组a[1..11]中进行二分法查找(即折半查找),依次与______比较后,成功找到元素a[5]。
- A. a[6] a[2] a[5]
- B. a[6] a[4] a[5]
- C. a[6] a[3] a[4] a[5]
- D. a[6] a[8] a[4] a[5]
答案:C
解析:
本题考查折半查找基础知识。
二分查找又称折半查找,优点是比较次数少,查找速度快,平均性能好;其缺点是要求待查表为有序表,且插入删除困难。因此,折半查找方法适用于不经常变动而查找频繁的有序列表。首先,假设表中元素是按升序排列,将表中间位置记录的关键字与查找关键字比较,如果两者相等,则查找成功;否则利用中间位置记录将表分成前、后两个子表,如果中间位置记录的关键字大于查找关键字,则进一步查找前一子表,否则进一步查找后一子表。重复以上过程,直到找到满足条件的记录,使查找成功,或直到子表不存在为止,此时查找不成功。
二分查找的算法要求有:1.采用的顺序存储结构 2.必须按照关键字大小有序排列
二分查找的算法复杂度:二分查找的基本思想是将n个元素分成大致相等的两部分,x是要查找的元素。取a[n/2]与x做比较,如果x=a[n/2],则找到x,算法中止;如果x<a[n/2],则只要在数组a的左半部分继续搜索x,如果x>a[n/2],则只要在数组a的右半部搜索x.假设有n个元素,接下来操作元素的剩余个数为:n,n/2,n/4......n/2k。由于n/2k取整后>=1,即令n/2k=1,得到  。所以时间复杂度为 。
难度 2 · 作答 1250 次 · 正确率 82.6%
40. 对于关键字序列(26, 25, 72, 38, 8, 18, 59),采用散列函数 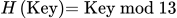 构造散列表(哈希表)。若采用线性探测的开放 定址法解决冲突(顺序地探查可用存储单元),则关键字59所在散列表中的地址为______。
- A. 6
- B. 7
- C. 8
- D. 9
答案:D
解析:
本题考查哈希表基础知识。
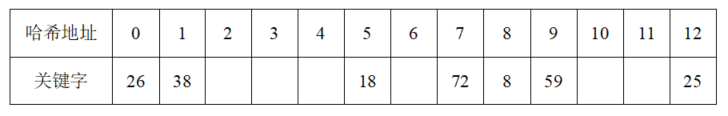
对于关键字序列(26,25,72,38,8,18,59)和散列函数H(Key)=Key mod
13,采用线性探测的开放定址法解决冲突构造的散列表如下表所示:
难度 2 · 作答 1507 次 · 正确率 54.3%
41. 对于哈希表,如果将装填因子  定义为表中装入的记录数与表的长度之比,那么向表中加入新记录时,______。
- A. 的值随冲突次数的增加而递减
- B. 越大发生冲突的可能性就越大
- C. 等于1时不会再发生冲突
- D. 低于0.5时不会发生冲突
答案:B
解析:
本题考查哈希表基础知识。
装填因子 表示了哈希表的装满程度,显然, 越大发生冲突的可能性就越大。
难度 2 · 作答 1300 次 · 正确率 78.8%
42. 采用冒泡排序算法对序列 (49,38,65,97,76,13,27,49) 进行非降序排序,两趟后的序列为_____。
- A. (49,38,65,13,27,49,76,97)
- B. (39,49,65,76,13,27,49,97)
- C. (38,49,65,13,27,49,76,97)
- D. (49,38,65,97,76,13,27,49)
答案:C
解析:
冒泡排序的基本思想是:两两比较待排元素,若次序相反,则交换位置,直到整个序列没有反序。它是通过相邻元素之间的比较和交换,将最大元素(或最小元素)交换到顶层的位置上。是一种稳定的排序方法。
难度 2 · 作答 1356 次 · 正确率 76.8%
43. 采用简单选择排序算法对序列(34,12,49,28,31,52,51,49)进行非降序排序,两趟后的序列为______。
- A. (12,28,49,34,31,52,51,49)
- B. (12,28,34,49,31,52,51,49)
- C. (12,28,31,49,34,52,51,49)
- D. (34,12,49,28,31,49,51,52)
答案:A
解析:
简单选择排序的基本思想是:从待排元素中选出最小的元素放在已排序序列的末尾(与末尾后的第一个元素交换),重复以上过程。是一种不稳定的排序方法。 第一趟排序:12,34,49,28,31,52,51,49; 找出最小的12和34交换; 第二趟排序:12,28,49,34,31,52,51,49; 找出剩余最小的28和34交换;故正确答案选A。
难度 2 · 作答 1458 次 · 正确率 51.4%
44. 用插入排序和归并排序算法对数组<3, 1, 4, 1, 5, 9, 6, 5>进行从小到大排序,则分别需要进行______次数组元素之间的比较。
- A. 12, 14
- B. 10, 14
- C. 12, 16
- D. 10, 16
答案:A
解析:
本题考查排序算法基础知识。
插入排序算法的基本思想是将待排序数组分为两个部分,已排好序部分和未排序部分。其主要步骤为:开始时,第一个元素在已排好序部分中,其余元素在未排序部分。然后依次从未排序部分中取出第一个元素,从后向前与排好序部分的元素进行比较并将其插入到已排好序部分的正确位置。直到所有元素排好序。
归并排序的基本思想是将待排序数组划分为子问题,对子问题求解,然后合并解。其主要步骤为:将数组分为两个相同规模的子数组,分别包含前n/2个元素和后n/2个元素;递归地排序这两个子数组;合并排好序的两个子数组,依次比较两个排好序的子数组的元素,得到整个数组的排好序的序列。
根据上述算法思想和算法步骤,可以得到题中实例的比较次数分别为12和14。具体如下:
插入排序:
①、【3】1,4,1,5,9,6,5
②、【1,3】,4,1,5,9,6,5 比较次数1次:3和1比较
③、【1,3,4】,1,5,9,6,5 比较次数1次:4和3比较
因为4比3大所以不和1比较
④、【1,1,3,4】,5,9,6,5 比较次数3次:1和4比较 1和3比较 1和1比较
因为1比4小故而需要和之前的数组比较直到大于等于之前的数字才停止
⑤、【1,1,3,4,5】,9,6,5 比较次数1次:5和4比较
⑥、【1,1,3,4,5,9】,6,5 比较次数1次:9和5比较
⑦、【1,1,3,4,5,6,9】,5 比较次数2次:6和9比较 6和5比较
⑧、【1,1,3,4,5,5,6,9】 比较次数3次:5和9比较 5和6比较 5和5比较
所以比较的次数为 1+1+3+1+1+2+3=12次。
归并排序:
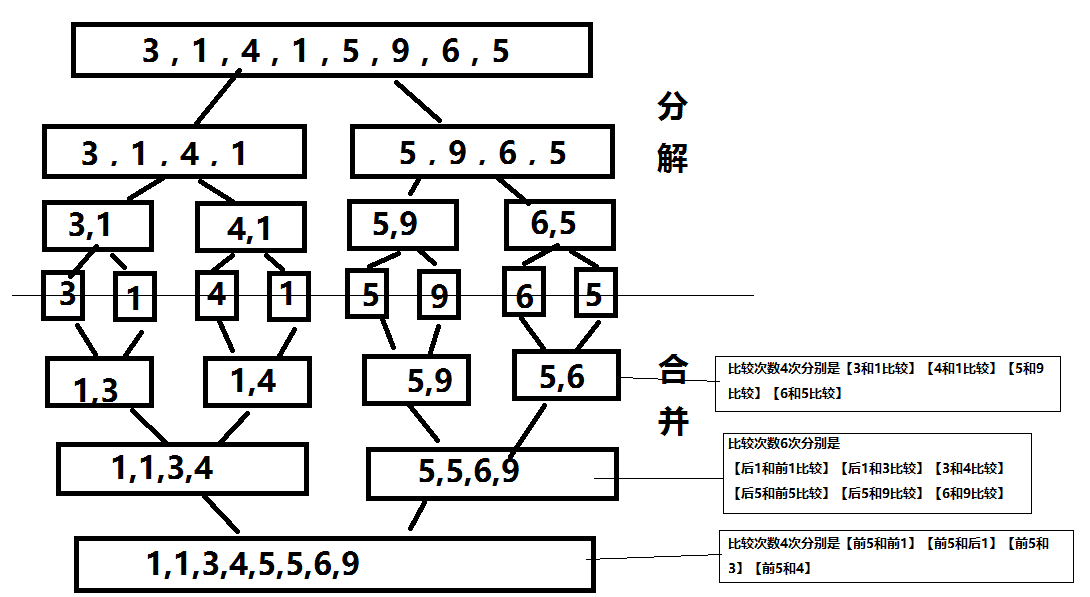 所以比较次数为4+6+4=14次。
难度 2 · 作答 1290 次 · 正确率 46.0%
45. (复合题 1/2)(1)正确的选项是?
共用题干: 堆排序是 (1) 类排序,堆排序平均执行的时间复杂度和需要附加的存储空间复杂度分别是 (2) 。
- A. 插入
- B. 归并
- C. 基数
- D. 选择
答案:D
解析:
本题考查堆排序基础知识。
堆排序是选择排序的一种。堆是一种特殊的完全二叉树,堆顶元素(根结点)是堆中的最大值(或最小值),并且任何一颗子树也都是堆。若堆顶元素为最小值,则为小根堆;若堆顶元素为最大值,则为大根堆。
堆排序的基本思想:①将待排元素建立一个初始堆
②输出堆顶的元素,即最大值(或最小值)
③将剩余待排元素建立一个新的堆,重复以上步骤。
建立初始堆的步骤:①对待排元素按层次遍历,构建一颗完全二叉树
②从最后一个非叶子节点开始,按照堆的定义进行调整。
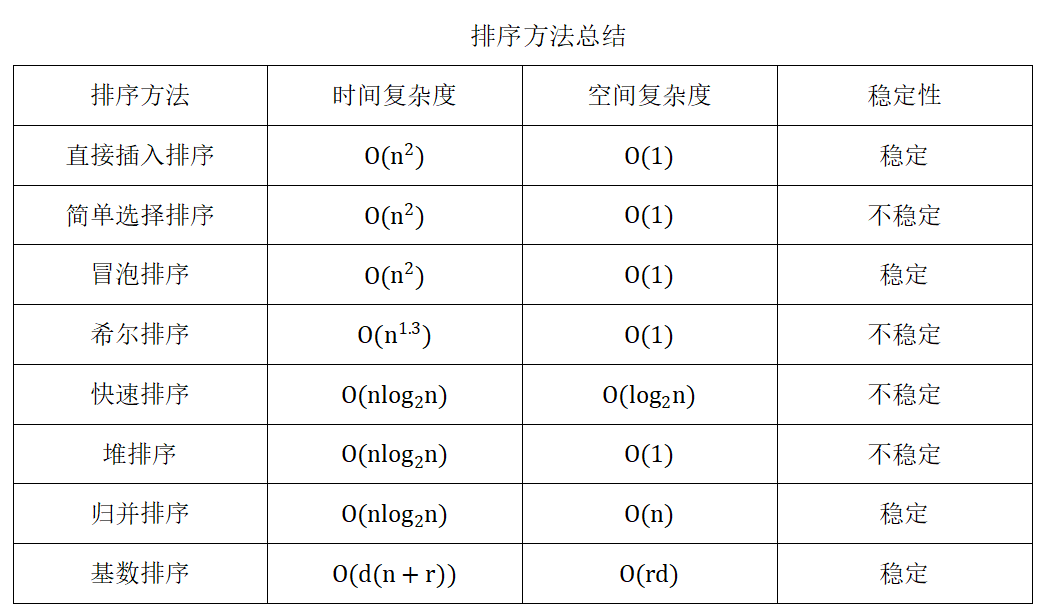
时间复杂度:  。
空间复杂度:仅需要一个元素的辅助空间,空间复杂度为 。
难度 2 · 作答 1591 次 · 正确率 51.5%
46. (复合题 2/2)(2)正确的选项是?
共用题干: 堆排序是 (1) 类排序,堆排序平均执行的时间复杂度和需要附加的存储空间复杂度分别是 (2) 。
- A. 和
- B. 和
- C. 和
- D. 和
答案:B
解析:
本题考查堆排序基础知识。
堆排序是选择排序的一种。堆是一种特殊的完全二叉树,堆顶元素(根结点)是堆中的最大值(或最小值),并且任何一颗子树也都是堆。若堆顶元素为最小值,则为小根堆;若堆顶元素为最大值,则为大根堆。
堆排序的基本思想:①将待排元素建立一个初始堆
②输出堆顶的元素,即最大值(或最小值)
③将剩余待排元素建立一个新的堆,重复以上步骤。
建立初始堆的步骤:①对待排元素按层次遍历,构建一颗完全二叉树
②从最后一个非叶子节点开始,按照堆的定义进行调整。
时间复杂度: 。
空间复杂度:仅需要一个元素的辅助空间,空间复杂度为 。
难度 2 · 作答 1520 次 · 正确率 61.7%
47. (202505)中缀式a*(b+c)-d转换为后缀式,存储运算符的栈最多有 个元素。
- A. 1
- B. 2
- C. 3
- D. 4
答案:C
解析:
后缀式简单求法:按运算的优先顺序依次将运算符写在运算对象的后面,例如,把写成a+b写成ab+。 首先计算本题的后缀式为abc+d-,本后缀式就是输出的顺序。 将中缀表达式a∗(b+c)−d转换为后缀表达式的过程中,使用栈来存储运算符和左括号。栈的大小变化如下: 初始时,栈为空,大小为 0。 扫描到 'a'(操作数),直接输出,栈大小仍为 0。 扫描到 ''(运算符),压入栈,栈为 [],大小为 1。 扫描到 '('(左括号),压入栈,栈为 [,(],大小为 2。 扫描到 'b'(操作数),直接输出,栈大小仍为 2。 扫描到 '+'(运算符),压入栈(因为栈顶是 '('),栈为 [,(,+],大小为 3(此时栈达到最大大小)。 扫描到 'c'(操作数),直接输出,栈大小仍为 3。 扫描到 ')'(右括号),弹出栈顶运算符 '+' 到输出,栈变为 [,(],大小为 2;然后弹出 '(' 并丢弃,栈变为 [],大小为 1。 扫描到 '-'(运算符),弹出栈顶运算符''到输出(因为'*'优先级高于 '-'),栈变为空,大小为 0;然后压入 '-',栈为 [-],大小为 1。 扫描到 'd'(操作数),直接输出,栈大小仍为 1。 表达式结束,弹出栈中剩余运算符 '-' 到输出,栈变为空,大小为 0。 栈的大小变化序列为:0 → 1 → 2 → 2 → 3 → 3 → 2 → 1 → 0 → 1 → 0。最大栈大小为 3,此时栈中元素为 ∗∗、(( 和 ++。 因此,存储运算符的栈最多有3个元素。 最终后缀表达式为:abc+*d-。
难度 1 · 作答 1056 次 · 正确率 72.1%
48. (202505)已知字符集为{a,b,c,d,e,f,g,h},若各字符的哈夫曼编码如下表所示,则对编码序列0101 011 0001 10 0100 10 011 11的译码结果为 。 字符 a b c d e f g h 哈夫曼编码 0100 10 0000 0101 001 011 11 0001
- A. daceabdg
- B. dabccabg
- C. dfaecbfg
- D. dfhbabfg
答案:D
解析:
根据哈夫曼编码表,将二进制序列按空格分隔逐个匹配,即0101→d,011→f,0001→h,10→b,0100→a,10→b,011→f,11→g,最后再组合起来得到dfhbabfg,答案选D。
难度 1 · 作答 825 次 · 正确率 88.0%
49. (202505)无向图G的顶点集合V={a,b,c,d,e,f},边集合E={(a,b),(a,c),(b,d),(b,e),(c,d),(c,e),(c,f),(d,f)},对G进行深度优先遍历,结果不可能的是 。
- A. acfdbe
- B. acebdf
- C. abdfce
- D. abcdef
答案:D
解析:
首先绘制无向图,如下所示:
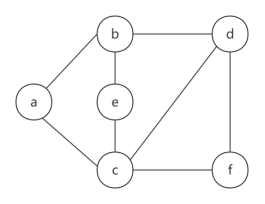 对于答案D中的bc和de,并没有b到c和d到e的边,因此答案D不可能。
难度 1 · 作答 820 次 · 正确率 65.4%
50. (202505)对某有序表进行折半查找时,参与比较的关键字顺序不可能的是 。
- A. 43,65,99,85,78
- B. 99,85,78,65,43
- C. 43,99,85,65,78
- D. 99,85,65,78,43
答案:D
解析:
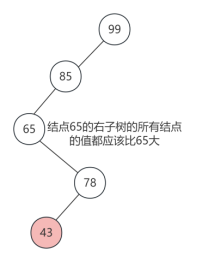
折半查找考查的频率较高。折半查找:假设表中的元素存储在一维数组r[1,⋯,n]中,且表中元素按递增方式排序,则折半查找的基本思想:将给定值key与表中中间位置元素r[mid]进行比较,若key==r[mid],则查找成功;若key>r[mid],则给定值key在后半个子表r[mid+1,⋯,n]中继续递归查找;若key<r[mid],则给定值key在前半个子表r[1,⋯,mid−1]中继续递归查找;递归以上步骤,直到查找成功或子表为空为止。
在答案D中,结点65的右子树的所有结点的值都应该比65大,但出现了43,因此答案D不可能。
难度 1 · 作答 1080 次 · 正确率 65.2%
51. (202511)设某n阶三对角矩阵的示意图如下图所示。若将该三对角矩阵的非零元素按行存储在一维数组B[k]中,A[1,1]存到B[0]中,则k与i、j的对应关系是 。 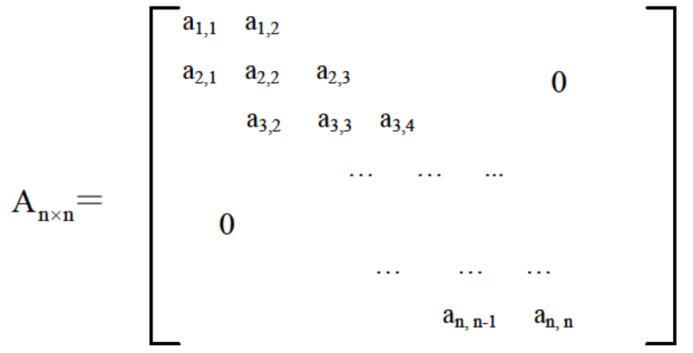
- A. k=2i+j-1
- B. k=2i+j+1
- C. k=i+2j-3
- D. k=2i+j-3
答案:D
解析:
特殊值代入法。当i=1,j=1时,k=0,选项C、D均等于0,满足条件;当i=1,j=2时,k=1,只有选项D满足条件。
难度 1 · 作答 365 次 · 正确率 64.7%
52. (202511)设有向图G=(V,E),顶点集合V={V0,V1,V2,V3},边集合E={<V0,V1>,<V0,V2>,<V0,V3>,<V1,V3>},若从顶点V0开始对该有向图进行深度优先遍历,则可能得到的不同遍历序列有 个。
- A. 2
- B. 3
- C. 4
- D. 5
答案:D
解析:
深度优先搜索:类似于树的先根遍历。①第一步:访问一顶点V;②第二步:依次搜索顶点V的所有邻接顶点;③第三步:若邻接顶点未被访问,则深度优先搜索邻接顶点,若已被访问,则跳到顶点V的下一个邻接顶点。
首先画出有向图,如下图所示:
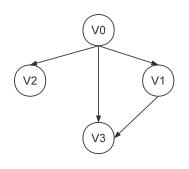 按照深度优先搜索遍历有:V0->V1->V3->V2,V0->V2->V1->V3,V0->V2->V3->V1,V0->V3->V1->V2,V0->V3->V2->V1,一共有5种不同的遍历序列。
难度 1 · 作答 521 次 · 正确率 46.1%
53. (202511)对有序顺序表(19,24,30,35,40,47,55,70,91)进行折半查找(二分查找)时,进行比较的关键字序列可能是 。
- A. 40,55,91
- B. 40,24,30
- C. 40,35,24
- D. 40,47,70
答案:B
解析:
折半查找考查的频率较高。折半查找:假设表中的元素存储在一维数组r[1,⋯,n]中,且表中元素按递增方式排序,则折半查找的基本思想:将给定值key与表中中间位置元素r[mid]进行比较,若key==r[mid],则查找成功;若key>r[mid],则给定值key在后半个子表r[mid+1,⋯,n]中继续递归查找;若key<r[mid],则给定值key在前半个子表r[1,⋯,mid−1]中继续递归查找;递归以上步骤,直到查找成功或子表为空为止。 对于题目中的数组r[1,...,9],首先与表中间的元素r[(1+9)/2]=r[5](即40),进行比较;若给定值key小于40,则在前半个子表r[1,...,4]中递归查找,与子表中的元素r[(1+4)/2]=r[2](即24),进行比较;若给定值key大于24,则继续在子表r[3,4]中递归查找,与子表中的元素r[(3+4)/2]=r[3](即30),进行比较,因此进行比较的关键字序列可能是40,24,30。
难度 1 · 作答 489 次 · 正确率 71.0%
54. (202511)以下序列中,满足大顶堆条件的是 。
- A. 50,38,40,28,43,16,25,19
- B. 50,37,45,25,16,40,35,19
- C. 45,25,15,16,24,20,7,10
- D. 55,43,45,48,52,29,75,15
答案:B
解析:
堆是一种特殊的完全二叉树,堆顶元素(根结点)是堆中的最大值(或最小值),并且任何一颗子树也都是堆。若堆顶元素为最小值,则为小根堆;若堆顶元素为最大值,则为大根堆(大顶堆)。
堆排序的基本思想:①将待排元素建立一个初始堆 ②输出堆顶的元素,即最大值(或最小值) ③将剩余待排元素重新建立一个新的堆,重复以上步骤。
建立初始堆的步骤:①对待排元素按层次遍历,构建一棵完全二叉树 ②从最后一个非叶子节点开始,按照堆的定义进行调整。
对题目中的每个序列建立堆如下:
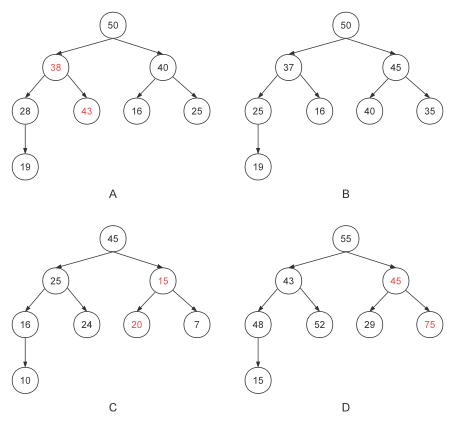 选项A、C、D序列建立的堆不符合大顶堆的定义,因此答案选B。
难度 1 · 作答 368 次 · 正确率 64.4%
55. 2026上半年 根据以下序列构造的二叉排序树中, 与其他3个序列所构造的结果不同。
- A. (95,65,85,90,115,100,125)
- B. (95,85,65,90,115,125,100)
- C. (95,115,100,125,85,65,90)
- D. (95,85,90,65,115,100,125)
答案:A
解析:
二叉排序树,又称为二叉查找树或者二叉搜索树,定义如下:
(1)要么为空树,要么具有(2)、(3)点的性质;
(2)若左子树不为空,则左子树的所有结点值均小于根结点;
(3)若右子树不为空,则右子树的所有结点值均大于根结点。
显然,这是一个递归定义,对二叉排序树进行中序遍历,就能得到一个递增的有序序列,因此其经常被用于查找算法。口诀:“左小右大”。
难度 1 · 作答 148 次 · 正确率 51.4%