C语言算法
题库 9 · 章节 92 · 共 6 题(案例 6)
1. (案例题)阅读下列说明和C代码,回答问题1至问题3,将解答写在答题纸的对应栏内。 【说明】 排序是将一组无序的数据元素调整为非递减顺序的数据序列的过程,堆排序是一种常用的排序算法。用顺序存储结构存储堆中元素。非递减堆排序的步骤是: (1)将含n个元素的待排序数列构造成一个初始大顶堆,存储在数组R(R[1],R[2],...,R[n])中。此时堆的规模为n,堆顶元素R[1]就是序列中最大的元素,R[n]是堆中最后一个元素; (2)将堆顶元素和堆中最后一个元素交换,最后一个元素脱离堆结构,堆的规模减1,将堆中剩余的元素调整成大顶堆; (3)重复步骤(2),直到只剩下最后一个元素在堆结构中,此时数组R是一个非递减的数据序列。 【C代码】 下面是该算法的C语言实现。 (1)主要变量说明 n:待排序的数组长度 R[]:待排序数组,n个数放在R[1],R[2],...,R[n]中 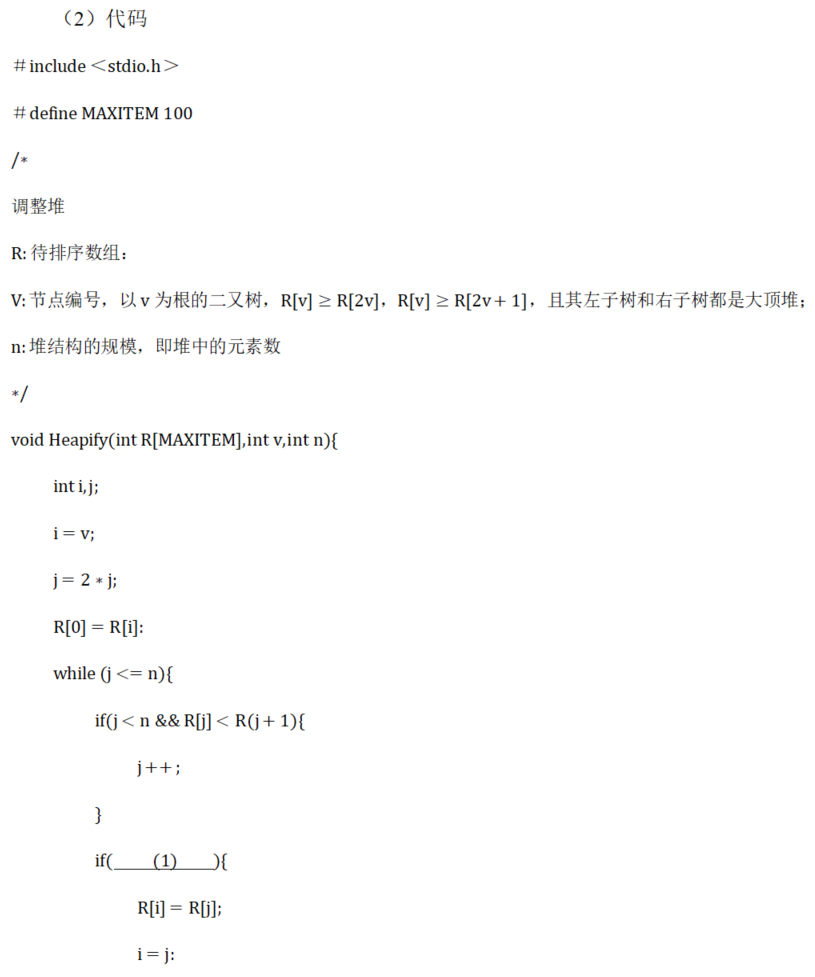
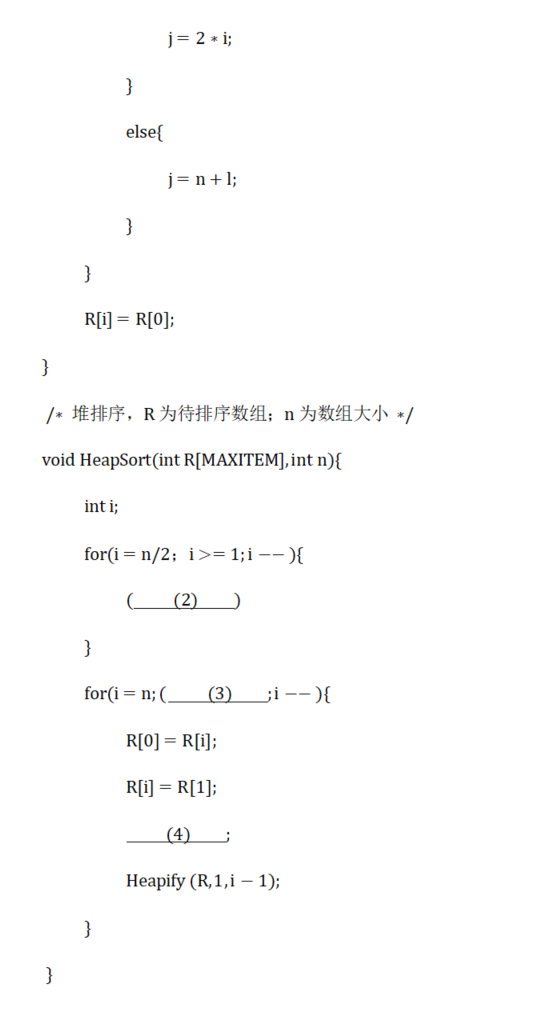 【问题1】(8分) 根据以上说明和C代码,填充C代码中的空(1)~(4)。 【问题2】(2分) 根据以上说明和C代码,算法的时间复杂度为(5)(用O符号表示)。 【问题3】(5分) 考虑数据序列R=(7,10,13,15,4,20,19,8),n=8,则构建的初始大顶堆为(6),第一个元素脱离堆结构,对剩余元素再调整成大顶堆后的数组R为(7)。
参考答案:
【问题1】
(1)R[j]>R[i] (2)Heapify(R,i,n) (3)i>=1 (4)R[1]>R[0] 【问题2】 (5)O(nlogN) 【问题3】 (6)20,15,19,10,4,13,7,8 (7)19,15,13,10,4,8,7
2. (案例题)阅读下列说明和C代码,回答问题1至问题3,将解答填入答题纸的对应栏内。 【说明】 某工程计算中要完成多个矩阵相乘(链乘)的计算任务,对矩阵相乘进行以下说明。 (1)两个矩阵相乘要求第一个矩阵的列数等于第二个矩阵的行数,计算量主要由进行乘法运算的次数决定。假设采用标准的矩阵相乘算法,计算AnmBnp,需要mnp次乘法运算,即时间复杂度为O(mnp)。 (2)矩阵相乘满足结合律,多个矩阵相乘时不同的计算顺序会产生不同的计算量。以矩阵A15100A21008A3850三个矩阵相乘为例,若按(A1A2)A3计算,则需要进行51008+5850=6000次乘法运算,若按A1*(A2A3)计算,则需要进行100850+510050=65000次乘法运算。 矩阵连乘问题可描述为:给定n个矩阵,对较大的n,可能计算的顺序数量非常庞大,用蛮力法确定计算顺序是不实际的。经过对问题进行分析,发现矩阵连乘问题具有最优子结构,即若A1A2*...A3的一个最优计算顺序从第k个矩阵处断开,即分为A1A2*...Ak和Ak+1Ak+2*...An两个子问题,则该最优解应该包含A1A2*...Ak的一个最优计算顺序和Ak+1Ak+2*...An的一个最优计算顺序。据此构造递归式: 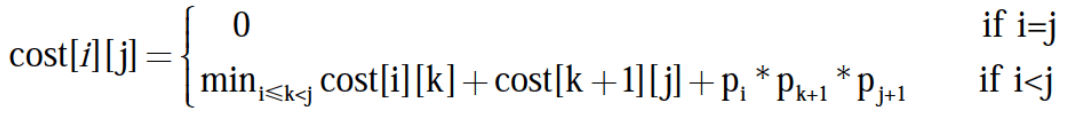 其中,cost[i][j]表示Ai+1Ai+2*...Aj+1的最优计算的代价。最终需要求解cost[0][n – 1]。 【C代码】 算法实现采用自底向上的计算过程。首先计算两个矩阵相乘的计算量,然后依次计算3个矩阵、4个矩阵、…、n个矩阵相乘的最小计算量及最优计算顺序。下面是算法的C语言实现。 (1)主要变量说明 n:矩阵数 seq[]:矩阵维数序列 cost[][]:二维数组,长度为nn,其中元素cost[i][j]表示Ai+1Ai+2...Aj+1的最优计算的计算代价 trace[][]:二维数组,长度为nn,其中元素trace[i][j]表示Ai+1Ai+2...*Aj+1的最优计算对应的划分位置,即k (2)函数cmm #define N 100 int cost[N][N]; int trace[N][N]; int cmm(int n, int seq[]) { int tempCost; int tempTrace; int i, j, k, p; int temp; for (i = 0; i < n; i ++ ) { cost[i][i] = 0; } for (p = 1; p < n; p ++ ) { for (i = 0; i < n - p; i ++ ) { (1) ; tempCost = -1; for (k = i; (2) ; k ++ ) { temp = (3) ; if(tempCost == -1 || tempCost > temp) { tempCost = temp; tempTrace = k; } } cost[i][j] = tempCost; (4) ; } } return cost[0][n - 1]; } 【问题1】(8分) 根据以上说明和C代码,填充C代码中的空(1)〜(4)。 【问题2】(4分) 根据以上说明和C代码,该问题采用了 (5) 算法设计策略,时间复杂度为 (6) 。(用O符号表示) 【问题3】(3分) 考虑实例n = 4,各个矩阵的维数:A1为15 * 5,A2为5 * 10,A3为10 * 20,A4为20 * 25,即维数序列为15, 5, 10, 20, 25。则根据上述C代码得到的一个最优计算顺序为 (7) (用加括号方式表示计算顺序),所需要的乘法运算次数为 (8) 。
参考答案:
【问题1】
- j=i+p
- k<j
- cost[i][k]+cost[k+1][j]+sep[i]*sep[k+1]*sep[j+1]
- trace[i][j] = tempTrace; 【问题2】
- 动态规划算法
- O(n^3) 【问题3】
- A1*((A2*A3)*A4)
- 5375
3. (案例题)阅读下列说明和C代码,回答问题1至问题2,将解答填入答题纸的对应栏内。 【说明】 生物学上通常采用编辑距离来定义两个物种DNA序列的相似性,从而刻画物种之间的进化关系。具体来说,编辑距离是指将一个字符串变换为另一个字符所需要的最小操作次数。操作有三种,分别为:插入一个字符、删除一个字符以及将一个字符修改为另一个字符。用字符数组str1和str2分别表示长度为len1和len2的字符串,定义二维数组d记录求解编辑距离的子问题最优解,则该二维数组可以递归定义为: 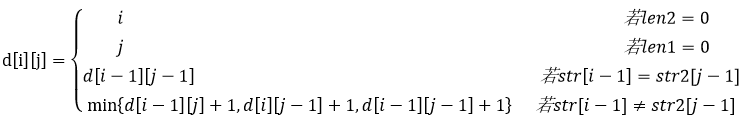 【C代码】 下面是算法的C语言实现。 (1)常量和变量说明 A,B:两个字符数组 d[][]:二维数组 i,j:循环变量 temp:临时变量 (2)C程序 #include <stdio.h> #define N 100 char A[N] = "CTGA"; char B[N] = "ACGCTA"; int d[N][N]; int min(int a, int b) { return a < b ? a : b; } int editdistance(char *str1, int len1, char *str2, int len2) { int i, j; int diff; int temp; for (i = 0; i <= len1; i ++ ) { d[i][0] = i; } for (j = 0; j <= len2; j ++ ) { (1) ; } for (i = 1; i <= len1; i ++ ) { for (j = 1; j <= len2; j ++ ) { if ( (2) ) { d[i][j] = d[i - 1][j - 1]; } else { temp = min(d[i - 1][j] + 1, d[i][j - 1] + 1); d[i][j] = min(temp, (3) ); } } } return (4) ; } 【问题1】(8分) 根据说明和C代码,填充C代码中的空(1)〜(4)。 【问题2】(4分) 根据说明和C代码,算法采用了 (5) 设计策略,时间复杂度为 (6) (用O符合表示,两个字符串的长度分别用m和n表示)。 【问题3】(3分) 已知两个字符串A=“CTGA”和B=“ACGCTA”,根据说明和C代码,可得出这两个字符串的编辑距离为 (7) 。
参考答案:
【问题1】(8分) (1) d[0][j] = j (2) str1[i – 1] == str2[j – 1] (3) d[i – 1][j – 1] + 1 (4) d[len1][len2] 【问题2】(4分) (5) 动态规划法 (6)O(mn) 或 O(m * n) 【问题3】(3分) (7)4
4. (案例题)阅读下列说明和C代码,回答问题1至问题2,将解答填入答题纸的对应栏内。 【说明】 凸多边形是指多边形的任意两点的连线均落在多边形的边界或内部。相邻的点连线落在多边形边界上,称为边;不相邻的点连线落在多边形内部,称为弦。假设任意两点连线上均有权重,凸多边形最优三角剖分问题定义为:求将凸多边形划分为不相交的三角形集合,且各三角形权重之和最小的剖分方案。每个三角形的权重为三条边权重之和。 假设N个点的凸多边形点编号为V1, V2, ...... , VN,若在Vk处将原凸多边形划分为一个三角形V1VkVN,两个子多边形V1, V2, ... , Vk和Vk, Vk+1, ... , VN得到一个最优的剖分方案,则该最优剖分方案应该包含这两个子凸边形的最优剖分方案。用m[i][j]表示Vi-1, Vi, ... ,Vj构成的凸多边形的最优剖分方案的权重,S[i][j]记录剖分该凸多边形的k值。 则: 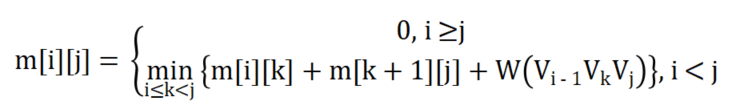 其中:W(Vi-1VkVj) = Wi-1,k + Wk,j + Wj,i-1为三角形Vi-1VkVj的权重,Wi-1,k, Wk,j, Wj,i-1分别为该三角形三条边的权重。求解凸多边形的最优剖分方案,即求解最小剖分的权重及对应的三角形集。 【C代码】 #include<stdio.h> #define N 6 // 凸多边形规模 int m[N + 1][N + 1]; // m[i][j]表示多边形Vi-1到Vj最优三角剖分的权值 int S[N + 1][N + 1]; // S[i][j]记录多边形Vi-1到Vj最优三角剖分的k值 int W[N + 1][N + 1]; // 凸多边形的权重矩阵,在main函数中输入 /* 三角形的权重a, b, c, 三角形的顶点下标 / int get_ triangle_weight(int a, int b, int c) { return W[a][b] + W[b][c] + W[c][a]; } / 求解最优值 / void triangle_partition() { int i, r, k, j; int temp; / 初始化 / for (i = 1; i <= N; i ++ ) { m[i][i] = 0; } / 自底向上计算m, S / for (r = 2; (1) ; r ++ ) { / r为子问题规模 / for (i = 1; k <= N – r + 1; i ++ ) { (2) ; m[i][j] = m[i][j] + m[i + 1][j] + get_triangle_weight(i - 1, i, j); / k = j */ S[i][j] = i; for (k = j + 1; k < j; k ++ ) { /*计算m[i][j]的最小代价 / temp = m[i][k] + m[k + 1][j] + ge_triangle_ weight(i - 1, k, j); if ( (3) ) { / 判断是否最小值 / m[i][j] = temp; S[i][j] = k; } } } } } / 输出剖分的三角形i, j:凸多边形的起始点下标 */ void print_triangle(int i, nt j) { if (i == j) return; print_triangle(i, S[i][j]); print_triangle( (4) ); printf("V%d--V%d--V%d\n", i - 1, S[i][j], j); } 【问题1】(8分) 根据题干说明,填充C代码中的空(1)〜(4)。 【问题2】(7分) 根据题干说明和C代码,该算法采用的设计策略为 (5) 。 算法的时间复杂度为 (6) ,空间复杂度为 (7) (用O表示)
参考答案:
【问题1】(8分) (1)i <= N (2)j = i + r - 1 (3)temp < m[i][j] (4)S[i][j] + 1, j 【问题2】(7分) (5)动态规划 (6)O(n3) (7)O(n2)
5. (案例题)阅读下列说明和C代码,回答问题1至问题3,将解答填入答题纸的对应栏内。 【说明】 希尔排序算法又称最小增量排序算法,其基本思想是: 步骤1:构造一个步长序列delta1, delta2, ...., deltak, 其中delta1 = n / 2,后面的每个delta是前一个的1 / 2,deltak = 1; 步骤2:根据步长序列进行k趟排序; 步骤3:对第i趟排序,根据对应的步长delta,将等步长位置元素分,对同一组内元素在原位置上进行直接插入排序。 【C代码】 下面的算法用C语言实现 (1)常量和变量说明 Data:待排序数组data,长度为n,待排序数据在data[0], data[1], data[2]..., data[n - 1]中。 N:数组data中的元素个数 delta:步长数组 (2)C程序 #include <stdlib.h> void ShellSort(int data[], int n) { int* delta, k, i, t, dk, j; k = n; delta = (int*) malloc(sizeof(int) * (n / 2)); i = 0; do { (1) ; delta[i ++ ] = k; } while (2) ; i = 0; while ( (3) ) { for (k = delta[i]; k < n; ++ k ) if (data[k] < data[k - dk]) { t = data[k]; for (j = k - dk; j >= 0 && t < data[j]; j -= dk) data[j + dk] = data[j]; (4) ; } ++ i; } } 【问题1】(8分) 根据说明和C代码,填充C代码中的空(1)〜(4)。 【问题2】(4分) 根据说明和C代码,该算法的时间复杂度 (5) O(n^2)(填写小于、等于或大于)。 该算法是否稳定 (6) (是或否)。 【问题3】(3分) 对数组(15, 9, 7, 8, 20, -1, 4)用希尔排序方法进行排序,经过第一趟排后得到的数组为 (7) 。
参考答案:
【问题1】(8分) (1)k /= 2 或 k = k / 2 (2)k > 1 (3)data[k – dk] > data[k] 或 data[k] < data[k – dk] (4)data[j + dk] = t 【问题2】(4分) (5)小于 (6)否 【问题3】(3分) (7)(4, 9, -1, 8, 20, 7, 15)
6. (案例题)阅读下列说明和C代码,回答问题1至问题3,将解答填入答题纸的对应栏内。 【说明】 0-1背包问题定义为:给定i个物品的价值v[1…i]、小重量w[1…i]和背包容量T,每个物品装到背包里或者不装到背包里。求最优的装包方案,使得所得到的价值最大。 0-1背包问题具有最优子结构性质。定义c[i][T]为最优装包方案所获得的最大价值,则可得到如下所示的递归式。 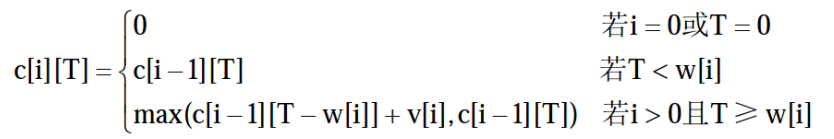 【C代码】 下面是算法的C语言实现。 (1)常量和变量说明 T:背包容量 v[]:价值数组 w[]:重量数组 c[][]:c[i][j]表示前i个物品在背包容量为j的情况下最优装包方案所能获得的最大价值 (2)C程序 #include <stdio.h> #include <math.h> #define N 6 #define maxT 1000 int c[N][maxT] = {0}; int Memoized_Knapsack(int v[N], int w[N], int T) { int i; int j; for (i = 0; i < N; i ++ ) { for (j = 0; j <= T; j ++ ) { c[i][j] = -1; } } return Calculate_Max_Value(v, w, N - 1, T); } int Calculate_Max_Value(int v[N], int w[N], int i, int j) { int temp = 0; if (c[i][j] != -1) { return (1) ; } if (i == 0 || j == 0) { c[i][j] == 0; } else { c[i][j] = Calculate_Max_Value(v, w, i - 1, j); if ( (2) ) { temp = (3) ; if (c[i][j] < temp) { (4) ; } } } return c[i][j]; } 【问题1】(8分) 根据说明和C代码,填充C代码中的空(1)〜(4)。 【问题2】(4分) 根据说明和C代码,算法采用了 (5) 设计策略。在求解过程中,采用了 (6)(自底向上或者自顶向下)的方式。 【问题3】(3分) 若5项物品的价值数组和重量数组分别为v[] = {0, 1, 6, 18, 22, 28}和w[] = {0, 1, 2, 5, 6, 7}背包容量为T = 11,则获得的最大价值为 (7) 。
参考答案:
【问题1】 (1)c[i][j] (2)w[i]<=j (3)Calculate_Max_Value(v,w,i-1,j-w[i])+v[i] (4)c[i][j]=temp 【问题2】 (5)动态规划 (6)自顶向下 【问题3】 (7)40