数据结构与算法(第五版)
51CTO 软考题库 · 共 243 题(单选 216 + 问答 27)
1. 根据渐进分析,表达式序列∶n^4,lgn,2^n,1000n,n^(2/3),n!从低到高排序为(65)。
- A. lgn,1000n, n^(2/3), n^4, n!, 2^n
- B. n^(2/3),1000n, lgn, n4, n!, 2n
- C. lgn,n^(2/3), 1000n, 2^n, n^4, n!
- D. lgn, n^(2/3), 1000n, n^4, 2^n, n!
答案:D
解析(AI 生成):
比较阶的增长速度:lgn最慢,n^(2/3)是幂函数低于一次,1000n为线性,n^4为多项式,2^n为指数,n!增长最快,故由低到高为lgn、n^(2/3)、1000n、n^4、2^n、n!,选D。常数1000不改变阶。
单选题
2. 对以下四个序列用直接插入排序方法由小到大进行排序时,元素比较次数最少的是(49)。
- A. 89,27,35,78,41,15
- B. 27,35,41,16,89,70
- C. 15,27,46,40,64,85
- D. 90,80,45,38,30,25
答案:C
解析:
当序列基本有序时,直接插入排序过程中元素比较的次数较少,当序列为逆序时,元素的比较次数最多。这里选项C中的元素按照从小到大基本有序排列,用直接插入法比较次数最少。
单选题
3. 用关键字序列10、20、30、40、50构造的二又排序树(二又查找树)为(50)。
- A.
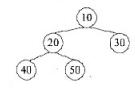
- B.
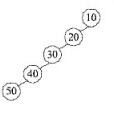
- C.
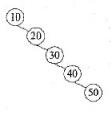
- D.
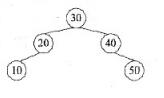
答案:C
解析:
根据关键字序列构造二叉排序树的基本过程是,若需插入的关键字大于树根,则插入到右子树上,若小于树根,则插入到左子树上,若为空树,则作为树根结点。
单选题
4. 采用顺序表和单链表存储长度为n的线性序列,根据序号查找元素,其时间复杂度分别为(53)。
- A. O(1)、O(1)
- B. O(1)、O(n)
- C. O(n)、O(1)
- D. O(n)、O(n)
答案:B
解析:
顺序表存储位置是相邻连续的,可以随即访问的一种数据结构,一个顺序表在使用前必须指定起长度,一旦分配内存,则在使用中不可以动态的更改。他的优点是访问数据是比较方便,可以随即的访问表中的任何一个数据。链表是通过指针来描述元素关系的一种数据结构,他可以是物理地址不连续的物理空间。不能随即访问链表元素,必须从表头开始,一步一步搜索元素。它的优点是:对于数组,可以动态的改变数据的长度,分配物理空间。因此两者的查找复杂度就显而易见了。
单选题
5. 设元素序列a、b、c、d、e、f经过初始为空的栈S后,得到出栈序列cedfba,则栈S的最小容量为(54)。
- A. 3
- B. 4
- C. 5
- D. 6
答案:B
解析:
根据题中出栈的顺序,当元素c出栈后,栈中有元素a、b,当元素e出栈之前,栈中有元素a、b、d、e,此时栈中的元素达到最多。因此栈s最小容量为4。
单选题
6. 为了描述n个人之间的同学关系,可用(56)结构表示。
- A. 线性表
- B. 树
- C. 图
- D. 队列
答案:C
解析:
在线性表中,数据元素之间仅有线性关系,每个数据元素只有一个直接前驱和一个直接后继:在树形结构中,数据元素之间有着明显的层次关系,并且每一层上的数据元素可自能和下一层中多个元素有关系,但只能和上一层中一个元素有关系;而在图结构中,结点之间的关系可以是任意的,图中任意两个数据元素之间都可能有关系。 在描述n个人之间的同学关系时,使用图这种数据结构表示是较合适的。
单选题
7. 判断一个表达式中左右括号是否匹配,采用(57)实现较为方便。
- A. 线性表的顺序存储
- B. 队列
- C. 线性表的链式存储
- D. 栈
答案:D
解析:
栈可以实现表达式中的括号匹配问题。当扫描到左括号时,则将其压入栈中;当扫描到右括号时,从栈顶取出一个左括号。如果能够匹配,比如“(”跟“)”匹配,“[”跟“]”匹配,“{”跟“}”匹配,则继续扫描剩下的字符串。如果扫描的过程中,遇到不能配对的右括号,或者栈中没有数据,则说明为非法格式。 当所有的括号都扫描完成之后,如果栈为空,则说明字符串为合法格式;否则,说明有未匹配的左括号,为非法格式。
单选题
8. 在一颗非空二叉树中,叶子节点的总数比度为2的节点总数多 (59) 个。
- A. -1
- B. 0
- C. 1
- D. 2
答案:C
解析(AI 生成):
设叶子结点n0、度为2的结点n2、度为1的结点n1,结点总数n=n0+n1+n2,分支数n-1=n1+2n2,两式相减得n0=n2+1,即叶子比度为2的结点多1个,选C,与度为1的结点数无关。
单选题
9. 在求解某问题时,经过分析发现该问题具有最优子结构性质,求解过程中子问题被重复求解,则采用(1)算法设计策略,以深度优先的方法是搜索解 空间,则采用(2)算法设计策略。
- A. 分治 (问题62)
- B. 动态规划 (问题62)
- C. 贪心 (问题62)
- D. 回溯 (问题62)
答案:B
解析:
动态规划算法总体思想:如果能够保存已解决的子问题的答案,而在需要时再找出已求得的答案,就可以避免大量重复计算,从而得到多项式时间算法 从根开始计算,到找到位于某个节点的解,回溯法(深度优先搜索)作为最基本的搜索算法,其采用了一种“一直向下走,走不通就掉头”的思想(体会“回溯”二字),相当于采用了先根遍历的方法来构造搜索树。
单选题
10. 某货车运输公司有一个中央仓库和n个运输目的地,每天要从中央仓库将货物运输到所有运输目的地,到达每个运输目的地一次且仅一次,最后回到中央仓库。在两个地点i和j之间运输货物存在费用Cij。为求解旅行费用总和最小的运输路径,设计如下算法:首先选择离中央仓库最近的运输目的地1,然后选择离运输目的地1最近的运输目的地2,…,每次在来访问过的运输目的地中选择离当前运输目的地最近的运输目的地,最后回到中央仓库。 该算法采用了(1)算法设计策略,其时间复杂度为(2)。
- A. 分治
- B. 动态规划
- C. 贪心
- D. 回溯
答案:C
解析:
由于每次选择下一个要访问的城市时都是基于与当前最近的城市来进行,是一种贪心的选择策略,因此该算法采用的是贪心算法设计策略。而货车从中央仓库出发,第1个要到达的目的地是在n个目的地中选择一个,第2个要到达的目的地是在n-1个目的地中选择一个,……,第n个要到达的目的地是在1个目的地中选择一个,所以该算法的时间复杂度为n+(n-1)+…+1=n*(n-1)/2=O  。
单选题
11. 要在8×8的棋盘上摆放8个“皇后”,要求“皇后”之间不能发生冲突,即任何两个“皇后”不能在同一行、同一列和相同的对角线上,则一般采用______来实现。
- A. 分治法
- B. 动态规划法
- C. 贪心法
- D. 回溯法
答案:D
解析:
N-皇后问题是一个经典的计算问题,该问题基于一些约束条件来求问题的可行解。该问题不易划分为子问题求解,因此分治法不适用;由于不是要求最优解,因此不具备最优子结构性质,也不宜用动态规划法和贪心法求解。而系统搜索法——回溯法可以有效地求解该问题。
单选题
12. n个顶点的有向完全图中含有向边的数目最多为 (54) 。
- A. n-1
- B. n
- C. n(n-1)/2
- D. n(n-1)
答案:D
解析:
n个顶点的有向完全图中,每个顶点都向其他n-1个顶点发出一条弧,因此总的有向边的数目为n(n-1)。
单选题
13. 设有栈S和队列Q且其初始状态为空,数据元素序列a,b,c,d,e,f依次通过栈S,且各个元素从S出栈后立即进入队列Q,若出队列的序列是b,d,f,e,c,a,则S中的元素最多时,栈底到栈顶的元素依次为()。
- A. a,b,c
- B. a,c,d
- C. a,c,e,f
- D. a,d,f,e
答案:C
解析:
队列Q的出队序列就是栈S的出栈序列,从b,d,f,e,c,a反过来看a,c,e,f,d,b,如果后面元素的排列比前面的顺序靠后,就可以同时在栈里,由此只能是a,c,e,f。
单选题
14. 当二叉树的结点数目确定时,()的高度一定是最小的。
- A. 二叉排序树
- B. 完全二叉树
- C. 线索二叉树
- D. 最优二叉树
答案:B
解析(AI 生成):
结点数固定时,完全二叉树每层尽量填满,高度为⌈log2(n+1)⌉,达到最小。二叉排序树形状取决于插入次序,可能退化成单支;线索二叉树只改变遍历方式;最优二叉树是带权路径长度最小,不保证高度最小,故选B。
单选题
15. ()是对稀疏矩阵进行压缩存储的方式
- A. 二维数组和双向链表
- B. 三元组顺序链表和十字链表.
- C. 邻接矩阵和十字链表
- D. 索引顺序表和双向链表
答案:B
解析:
对稀疏矩阵的压缩方法有三种: 1、三元组顺序表 2、行逻辑连接的顺序表 3、十字链表
单选题
16. 设用线性探查法解决冲突构造哈希表,且哈希函数为H(key)=key%m,若在该哈希表中查找某关键字e是成功的且与多个关键字进行了比较,则(60)。
- A. 这些关键字形成一个有序序列
- B. 这些关键字都不是e的同义词
- C. 这些关键字都是e的同义词
- D. 这些关键字的第一个可以不是e的同义词
答案:D
解析:
同义词才会占用同个位置,从而需要进行多次比较。这些关键字的第一个可以不是e的同义词,可以是排在e之前的关键字正好占了那个位置。
单选题
17. 对于一个初始无序的关键字序列,在下面的排序方法中,(61)第一趟排序结束后,一定能将序列中的某个元素在最终有序序列中的位置确定下来 ①直接插入排序②冒泡排序③简单选择排序 ④堆排序⑤快速排序 ⑥归并排序
- A. ①②③⑥
- B. ①②③⑤⑥
- C. ②③④⑤
- D. ③④⑤⑥
答案:C
解析:
每次排序能够确定至少一个元素最终位置的排序: 快速排序:每次可以确定指定的哨兵元素位置。 冒泡排序:每次可以确定最大元素位置。 堆排序:每一次排序时,都是将堆顶的元素和最后一个节点互换,然后调整堆,再将堆大小减1。所以每一次排序堆顶元素确定。 简单选择排序:每次将最大的数放到最后。每次确定最大元素的位置。
单选题
18. 对数组A=(2,8,7,1,3,5,6,4)构建大顶堆为(62)(用数组表示)。
- A. (1,2,3,4,5,6,7,8)
- B. (1,2,5,4,3,7,6,8)
- C. (8,4,7,2,3,5,6,1).
- D. (8,7,6,5,4,3,2,1)
答案:C
解析:
1、先按照元素顺序构造二叉树
2、选择第一个最大的非叶子节点,与其两个孩子(若有)分别进行比较,如果比孩子小,则与孩子交换位置
3、重复1、2过程知道父节点比孩子结点都大为止。
如下图所示:
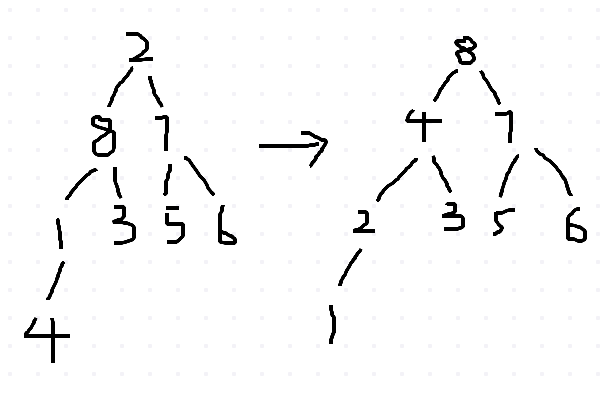
单选题
19. 最大子段和问题描述为,在n个整数(包含负数)的数组A中,求元素之和最大的非空连续子数组,如数组A=(-2,11,-4,13,-5,-2),其子数组B=(11,-4,13)具有最大子段和 20(11-4+13=20)。求解该问题时,可以将数组分为两个n/2个整数的子数组最大子段和或者在前半段,或者在后半段,或者跨越中间元素,通过该方法继续划分问题,直至最后求出最大子段和,该算法的时间复杂度为(63)。
- A. O(nlgn)
- B. O(n^2)
- C. O(n^2lgn)
- D. O(n^3)
答案:A
解析:
根据题干描述“求解该问题时,可以将数组分为两个n/2个整数的子数组最大子段和或者在前半段,或者在后半段,或者跨越中间元素,通过该方法继续划分问题,直至最后求出最大子段和”。可知采用的是分治法求解,时间复杂度为O(nlgn) 。
单选题
20. 在求解某问题时,经过分析发现该问题具有最优子结构和重叠子问题性,宜采用(1)算法设计策略得到最优解;若定义问题的解空间,并以广度优先的探索问题的解空间,则采用的是(2)算法设计策略。
- A. (64)分治
- B. (64)贪心
- C. (64)动态规划
- D. (64)回溯
答案:C
解析(AI 生成):
最优子结构加重叠子问题,说明大问题最优解可由子问题最优解组合,且子问题被反复求解,宜用动态规划自底向上填表;若改为广度优先搜索解空间,则是分支限界法。贪心要求贪心选择性质,分治的子问题独立不重叠。
单选题
21. 在求解某问题时,经过分析发现该问题具有最优子结构和重叠子问题性,宜采用(1)算法设计策略得到最优解;若定义问题的解空间,并以广度优先的探索问题的解空间,则采用的是(2)算法设计策略。
- A. (65)动态规划
- B. (65)贪心
- C. (65)回溯
- D. (65)分支限界
答案:D
解析:
动态规划算法: 动态规划过程是:每次决策依赖于当前状态,又随即引起状态的转移。一个决策序列就是在变化的状态中产生出来的,所以,这种多阶段最优化决策解决问题的过程就称为动态规划。 贪心算法: 所谓贪心算法是指,在对问题求解时,总是做出在当前看来是最好的选择。也就是说,不从整体最优上加以考虑,他所做出的仅是在某种意义上的局部最优解。贪心算法没有固定的算法框架,算法设计的关键是贪心策略的选择。必须注意的是,贪心算法不是对所有问题都能得到整体最优解,选择的贪心策略必须具备无后效性,即某个状态以后的过程不会影响以前的状态,只与当前状态有关。所以对所采用的贪心策略一定要仔细分析其是否满足无后效性。 回溯算法: 回溯算法实际上一个类似枚举的搜索尝试过程,主要是在搜索尝试过程中寻找问题的解,当发现已不满足求解条件时,就“回溯”返回,尝试别的路径。回溯法是一种选优搜索法,按选优条件向前搜索,以达到目标。但当探索到某一步时,发现原先选择并不优或达不到目标,就退回一步重新选择,这种走不通就退回再走的技术为回溯法,而满足回溯条件的某个状态的点称为“回溯点”。许多复杂的,规模较大的问题都可以使用回溯法,有“通用解题方法”的美称。 分支限界算法: 所谓“分支”就是采用广度优先的策略,依次搜索E-结点的所有分支,也就是所有相邻结点,抛弃不满足约束条件的结点,其余结点加入活结点表。然后从表中选择一个结点作为下一个E-结点,继续搜索。
单选题
22. 有一个n*n的对称矩阵A,将其下三角部分按行存放在一个一维数组B中,而A[0][0]存放在B[0]中,则A[i][i]存放在B中的(57)处。
- A. (i+3)*i/2
- B. (i+1)*i/2
- C. (2n-i+1)*i/2
- D. (2n-i-1)*i/2
答案:A
解析:
矩阵下标自0开始,数组下标自0开始,矩阵按行优先存放在数组中。可以使用代入法,A[1][1]=B [2],代入选择A
单选题
23. 一棵度为4的数T中,若有5个度为4的结点,7个度为3的结点,3个度为2的结点,9个度为1的结点,则树T的叶子结点个数(58)。
- A. 30
- B. 31
- C. 32
- D. 33
答案:D
解析:
根据树中结点总数为n,n=分支数+1,而分支数等于树中各个节点的度之和,所以根据此:54+73+32+91+1=叶子数+5+7+3+9;因此叶子数为33个。
单选题
24. 分别以以下序列构造二叉排序树,与其他3个序列所构造的结果不同的是(59)。
- A. 100,80,90,60,120,110,130
- B. 100,120,110,130,80,60,90
- C. 100,60,80,90,120,110,130
- D. 100,80,60,90,120,130,110
答案:C
解析(AI 生成):
二叉排序树形状由插入次序决定。A、B、D均以100为根,左子树80(左60、右90),右子树120(左110、右130)。C中60先入左子树,80成为60的右孩子,90再挂80右侧,形成单支左子树,形状不同,选C。
单选题
25. 设图的邻接矩阵A如下所示,各顶点的出度分别为(60)。 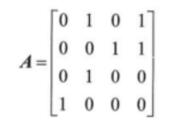
- A. 1,2,2,2
- B. 2,2,2,2
- C. 2,2,1,1
- D. 2,3,2,4
答案:C
解析:
邻接矩阵A为非对称矩阵,说明图是有向图,各顶点的出度为矩阵行中1的个数,即2,2,1,1。
单选题
26. 在有11个元素的有序表A[1,2,3···11]中进行折半查找,向下取整,查找元素A时[11],被比较的元素下标依次是(61)。
- A. 6,8,10,11
- B. 6,9,10,11
- C. 6,7,9,11
- D. 6,8,9,11
答案:B
解析:
根据折半查找思想,第一次mid=(1+11)/2=6,第二次mid=(7+11)/2=9,第三次mid=(10+11)/2=10,第四次mid=11。
单选题
27. 设散列表长m=14,散列函数为H(key)=key%11,表中仅有4个结点H(15)=4,H(38)=5,H(61)=6,H(84)=7,若使用线性探测法处理冲突,则关键字49存储的地址是(62)。
- A. 3
- B. 5
- C. 8
- D. 9
答案:C
解析:
49%11=5,发生冲突 线性探测6,发生冲突 线性探测7,发生冲突 线性探测8,无冲突
单选题
28. 对于n个关键字进行堆排序,最坏情况下的时间复杂度为(63)。
- A. O(log2n)
- B. O(n)
- C. O(nlog2n)
- D. O(n2)
答案:C
解析(AI 生成):
堆排序先建堆,耗时O(n),再反复输出堆顶并向下调整,共n-1次,每次沿树高O(log2n),总计O(nlog2n)。最好、最坏与平均均为该量级,且只需常数辅助空间,故选C;O(n2)是简单选择、冒泡等的最坏情况。
单选题
29. 设有二叉排序树(或二叉查找树)如下图所示,建立该二叉树的关键码序列不可能是()。 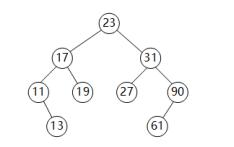
- A. 23 31 17 19 11 27 13 90 61
- B. 23 17 19 31 27 90 61 11 13
- C. 23 17 27 19 31 13 11 90 61
- D. 23 31 90 61 27 17 19 11 13
答案:C
解析:
二叉查找树(又称二叉搜索树,二叉排序树)它或者是一棵空树,或者是具有下列性质的二叉树: 若它的左子树不空,则左子树上所有结点的值均小于它的根结点的值; 若它的右子树不空,则右子树上所有结点的值均大于它的根结点的值; 它的左、右子树也分别为二叉排序树。31是27的父亲节点,31必须在27前面
单选题
30. 若栈采用顺序存储方式,现有两栈共享空间V[1..n],,top[i]代表i( i=1,2)个栈的栈顶(两个栈都空时top[1]= 1、top[2]= n),栈1的底在V[1],栈2的底在V[n], 则栈满(即n个元素暂存在这两个栈)的条件是(57)。
- A. top[1]= top[2]
- B. top[1]+ top[2]==1
- C. top[1]+ top[2]==n
- D. top[1]- top[2]== 1
答案:D
解析:
最后一个栈元素的位置加1为栈满的情况,因此判断的条件就是top[1]- top[2]== 1,选择D。
单选题
31. 采用循环队列的优点是(58)。
- A. 入队和出队可以在队列的同端点进行操作
- B. 入队和出队操作都不需要移动队列中的其他元素
- C. 避免出现队列满的情况
- D. 避免出现队列空的情况
答案:B
解析:
循环队列是将顺序队列形成一个环状结构,元素入队时修改尾指针,元素出队时修改头指针,入队和出队操作都不需要移动队列中的其他元素。
单选题
32. 二叉树的高度是指其层数,空二叉树的高度为0,仅有根结点的二叉树高度为1。若某二叉树中共有1024个结点,则该二叉树的高度是整数区间(59)中的任一值。
- A. (10, 1024)
- B. [10, 1024]
- C. (11, 1024)
- D. [11, 1024]
答案:D
解析:
要求二叉树高度的取值范围,需分别求出其最小高度和最大高度,并证明区间连续。 最小高度:当二叉树为完全二叉树时高度最小。根据二叉树性质,具有 nn 个结点的完全二叉树的高度为 ⌊log2n⌋+1⌊log2n⌋+1。代入 n=1024n=1024,得最小高度为 ⌊log21024⌋+1=10+1=11⌊log21024⌋+1=10+1=11。 最大高度:当二叉树退化为单支树(每个非叶子结点只有一个孩子)时高度最大。此时高度等于结点总数,即最大高度为 10241024。 连续性证明:高度为 1111 到 10241024 之间的任意整数都能构造成立。我们可以从高度为 1111 的完全二叉树出发,每次将最底层的一个叶子结点移动到下一层作为唯一子结点,即可使树的高度增加 11,通过这种方式可以连续构造出高度为 11,12,13,…,102411,12,13,…,1024 的二叉树。 综上所述,该二叉树的高度可以取区间 [11,1024][11,1024] 中的任何一个整数值。
单选题
33. 对有向图G进行拓扑排序得到的拓扑序列中,顶点Vi在顶点Vj之前,则说明G中(61)。
- A. 一定存在有向弧<Vi, Vj>
- B. 一定不存在有向弧<Vj, Vi>
- C. 可能存在从Vi到Vj的路径
- D. 必定存在从Vj到Vi的路径
答案:B
解析:
拓扑排序的前提为有向无环图,顶点Vi在顶点Vj之前,则一定不存在有向弧<Vj, Vi>。
单选题
34. 归并排序算法在排序过程中,将待排序数组分为两个大小相同的子数组,分别对两个子数组采用归并排序算法进行排序,排好序的两个子数组采用时间复杂度为0(n)的过程合并为一个大数组。根据上述描述,归并排序算法采用了(62)算法设计策略。归并排序算法的最好和最坏情况下的时间复杂度为(63)。
- A. 分治
- B. 动态规划
- C. 贪心
- D. 回溯
答案:A
解析(AI 生成):
把数组一分为二、分别递归排序再线性合并,正是分治策略:分解、解决、合并三步,子问题相互独立,递归深度log2n,每层合并O(n),故最好与最坏均为O(nlog2n)。动态规划要求子问题重叠,贪心与回溯不划分子数组。
单选题
35. 归并排序算法在排序过程中,将待排序数组分为两个大小相同的子数组,分别对两个子数组采用归并排序算法进行排序,排好序的两个子数组采用时间复杂度为0(n)的过程合并为一个大数组。根据上述描述,归并排序算法采用了(62)算法设计策略。归并排序算法的最好和最坏情况下的时间复杂度为(63)。
- A. O(n)和O(nlgn)
- B. O(n)和O(n^2)
- C. O(nlgn) 和O(nlgn)
- D. O(nlgn) 和O(n^2)
答案:C
解析(AI 生成):
归并排序将序列一分为二、分别递归排序后再线性合并,是典型的分治法。每层划分加合并需 O(n),共约 lgn 层,所以最好、最坏和平均情况都是 O(nlgn),额外空间 O(n)。D 项把最坏情况误作 O(n^2),那是快速排序最坏情形;A、B 则低估了合并代价。
单选题
36. 在一个长度为n的带头结点的单链表h上,设有尾指针r,则执行(53)操作与链表的表长有关。
- A. 删除单链表中的第一个元素
- B. 删除单链表中的最后一个元素
- C. 在单链表第一个元素前插入一个新元素
- D. 在单链表最后一个元素后插入一个新元素
答案:B
解析:
删除单链表的最后一个结点需置其前驱结点的指针域为NULL,需要从头开始依次遍历找到该前驱结点,需要O(n),与表长有关。其他操作均与表长无关。
单选题
37. 设有一个空栈,栈顶指针为1000H,每个元素需要一个存储单元,执行Push、Push、Pop、Push、Pop、Push、Pop、Push操作后,栈顶指针的值为(54)。
- A. 1002H
- B. 1003H
- C. 1004H
- D. 1005H
答案:A
解析:
每个元素需要一个存储单元,所以每入栈Push一次top加1,出栈Pop一次top减1.指针top的值依次是1001H,1002H,1001H,1002H,1001H,1002H,1001H,1002H。
单选题
38. 允许对队列进行的操作有(55)。
- A. 对队列中的元素排序
- B. 去除最近进队列的元素
- C. 在队列元素之间插入元素
- D. 删除队头元素
答案:D
解析(AI 生成):
队列是只允许在队尾插入、在队头删除的线性表,遵循先进先出,因此合法操作只有入队和删除队头元素。A 项排序、C 项在元素之间插入都破坏了受限访问;B 项删除最近入队的元素是栈的后进先出特性,属于栈的操作而非队列操作。
单选题
39. 将三对角矩阵A[1…100][1...100]按行优先存入一维数组B[1...298]中,A中元素A[66][65]在数组B中的位置k为(56)。
- A. 198
- B. 195
- C. 197
- D. 196
答案:B
解析:
对于三对角矩阵,将A[1..n][1..n]压缩至B[1..3n-2]时,aij与bk的对应关系为k=2i+j-2。则A中的元素A[66][65]在数组B中的位置k=2*66+65-2=195
单选题
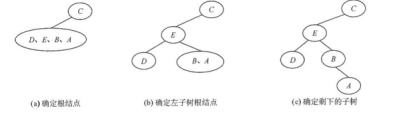
40. 已知一棵二叉树的后序遍历为DABEC,中序遍历为DEBAC,则先序遍历为(58)。
- A. ACBED
- B. DECAB
- C. DEABC
- D. CEDBA
答案:D
解析:
根据后序遍历与中序遍历可以构造出二叉树,如下图所示,由图可知先序遍历为CEDBA。
单选题
41. 已知字符集{a,b,c,d,e,f},若各字符出现的次数分别为6,3,8,2,10,4,则对应字符集中各字符的哈夫曼编码可能为(59)。
- A. 00,1011,01,1010,11,100
- B. 11,100,110,000,0010,01
- C. 10,1011,11,0011,00,010
- D. 0011,10,11,0010,01,000
答案:A
解析:
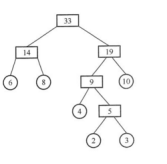
结合题意构造哈夫曼树如下图所示,在进行左子树为0,右子树为1,进行编码,最后为A
单选题
42. 下列哪种图的邻接矩阵是对称矩阵?(60)。
- A. 有向图
- B. 无向图
- C. AOV网
- D. AOE网
答案:B
解析(AI 生成):
无向图中边(i,j)与(j,i)是同一条边,邻接矩阵中 A[i][j] 与 A[j][i] 同时为 1,故矩阵关于主对角线对称。有向图的弧有方向,AOV 网、AOE 网都是有向图,只保证弧尾到弧头方向为 1,反向不一定为 1,一般不具对称性。
单选题
43. 下列选项中,不是下图深度优先搜索序列的是(61)。 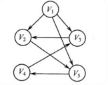
- A. V1,V5,V4,V3,V2
- B. V1,V3,V2,V5,V4
- C. V1,V2,V5,V4,V3
- D. V1,V2,V3,V4,V5
答案:D
解析:
根据题意,只需根据深度遍历的策略进行遍历。对于A,先访问V1,然后访问与V1邻接且未被访问的任一顶点(满足的有V2,V3和V5),此时访问V5,然后从V5出发,访问与V5邻接且未被访问的任一顶点(满足的只有V4),然后从V4出发,访问与V4邻接且未被访问的任一节点(满足的只有V3),然后从V3出发,访问与V3邻接且未被访问的任一顶点(满足的只有V2),结束遍历。选项B和C的分析方法和A相同。选项D,先访问V1,在从V1出发,访问V1邻接且未被访问的任一顶点(满足的有V2,V3,V5),然后从V2出发,访问与V2邻接且未被访问的任一顶点(满足的只有V5)。按规则本应该访问V5,但是选项D却访问了V3,D错误。
单选题
44. 一组记录的关键为19,14,23,1,68,20,84,27,55,11,10,79,用链地址法构造散列表,散列函数为H(key)=key MOD 13,散列地址为1的链中有(62)个记录。
- A. 1
- B. 2
- C. 3
- D. 4
答案:D
解析(AI 生成):
逐个取模 13:14→1、1→1、27→1、79→1,共 4 个;其余 19→6、23→10、68→3、20→7、84→6、55→3、11→11、10→10,都不落在 1 号地址。链地址法把同址记录串成一条链,故地址 1 的链长 4,选 D。
单选题
45. 下列算法中,(63)算法可能出现下列情况:在最后一趟开始之前,所有元素都不在最终位置上。
- A. 堆排序
- B. 冒泡排序
- C. 直接插入排序
- D. 快速排序
答案:C
解析:
在直接插入排序中,若待排序中的最后一个元素插入表的第一个位置,则前面的有序子序列中的所有元素都不在最终位置上。
单选题
46. 对一组数据2,12,16,88,5,10进行排序,如果前3趟排序结果如下: 第一趟排序结果:2,12,16,5,10,88 第二趟排序结果:2,12,5,10,16,88 第三趟排序结果:2,5,10,12,16,88 则采用的排序算法可能是(64)
- A. 冒泡排序
- B. 希尔排序
- C. 归并排序
- D. 基数排序
答案:A
解析:
分别用其他3中排序算法执行数据,归并排序的第一趟排序后的结果是2,12,16,88,5,10。基数排序第一趟后的结果是10,2,12,5,16,88。希尔排序显然不符合,只有冒泡排序符合。
单选题
47. 3个不同元素依次进栈, 能得到(53)种不同的出栈序列。
- A. 4
- B. 5
- C. 6
- D. 7
答案:B
解析:
本次采用列举法,abc依次进栈的出栈序列有abc,acb,bac,bca,cba。
单选题
48. 在一个二维数组A中,假设每个数组元素的长度为3个存储单元,行下标i为0-8,列下标j为0-9,从首地址SA开始连续存放,在这种情况下,元素A[8][5]的起始地址为(55)。
- A. SA+141
- B. SA+144
- C. SA+222
- D. SA+255
答案:D
解析:
二维数组计算地址(按照行优先顺序)的公式为: LOC(i,j)=LOC(0,0)+(i*m+j)L 其中LOC(0,0)=SA,是数组存放的首地址,L=3是每个数组元素的长度:m=9-0+1=10是数组的列数,因此LOC(8,5)=SA+(810+5)*3=SA+255,选D
单选题
49. 已知一棵二叉树的先序遍历结果为ABCDEF,中序遍历结果为CBAEDF,则后序遍历结果为(56)。
- A. CBEFDA
- B. FEDCBA
- C. CBEDFA
- D. 不确定
答案:A
解析(AI 生成):
先序首元素 A 是根,中序中 A 左侧的 CB 属左子树,右侧 EDF 属右子树。左子树先序 BC 得根 B、左孩子 C;右子树先序 DEF 得根 D、左右孩子 E 和 F。按左右根输出为 C、B、E、F、D、A,即 CBEFDA。
单选题
50. 一棵哈夫曼树共有215个结点,对其进行哈夫曼编码,共能得到(57)个不同的码字。
- A. 107
- B. 108
- C. 214
- D. 215
答案:B
解析:
根据哈夫曼树构造过程可知,哈夫曼树中只有度为0和度为2的结点,在非空二叉树中,n0=n2+1。根据此关系,n=n0+n2=2n0-1=215,所以n0=108
单选题
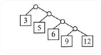
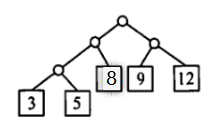
51. 给定整数集合{3,5,8,9,12},与之对应的哈夫曼树是(58)。
- A.
- B.

- C.
- D.
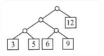
答案:C
解析:
首先,3和5构造为一棵子树,其跟权值为8,然后该子树与8构造一棵新子树,根权值为16,再后9与12构造为一棵子树,最后两棵子树共同构造为一棵哈夫曼树。
单选题
52. 下列关于图的存储结构的叙述中,正确的是(59).
- A. 一个图的邻接矩阵表示唯一,邻接表表示唯一
- B. 一个图的邻接矩阵表示不唯一,邻接表表示唯一
- C. 一个图的邻接矩阵表示唯一,邻接表表示不唯一
- D. 一个图的邻接矩阵表示不唯一,邻接表表示不唯一
答案:C
解析:
邻接矩阵表示唯一是因为图中边的信息在矩阵中有确定的位置,邻接表不唯一是因为邻接表的建立取决于建立边的顺序和表中的插入算法。
单选题
53. 在含有n个顶点和e条边的无向图的邻接矩阵中,零元素的个数是(60)。
- A. e
- B. 2e
- C. n^2-e
- D. n^2-2e
答案:D
解析:
无向图的邻接矩阵中,邻接大小为n^2,非零元素个数为2e,所以零元素的个数是n^2-2e。
单选题
54. 对如下无向图进行遍历,则下列选项中,不是广度优先遍历序列的是(61)。 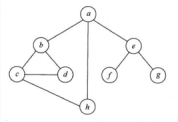
- A. h,c,a,b,d,e,g,f
- B. e,a,f,g,b,h,c,d
- C. d,b,c,a,h,e,f,g
- D. a,b,c,d,h,e,f,g
答案:D
解析(AI 生成):
广度优先遍历借助队列按层扩展:先访问起点的全部邻接点,再依次访问它们的未访问邻接点,同一层顶点必须连续出现。D 项把更深一层的 h 排在同层的 e、f、g 之前,破坏了层次与入队顺序,因此不是合法的广度优先序列。
单选题
55. 有一组数据15,9,7,8,20,-1,7,4,用堆排序的筛选方法建立的初始小根堆为(64)。
- A. -1,4,8,9,20,7,15,7
- B. -1,7,15,7,4,8,20,9
- C. -1,4,7,8,20,15,7,9
- D. 以上均不对
答案:C
解析(AI 生成):
建堆从最后一个非叶结点 n/2 起逐个向前筛选:把该结点与左右孩子中较小者交换,直到满足小根堆性质。筛选完成后最小值 -1 升到堆顶,其后依次是 4、7 等较小元素,与 C 一致。A、B 未按自下而上逐层筛选,父子大小关系不成立。
单选题
56. 设有一个包含n个元素的有序线性表。在等概率情况下删除其中的一个元素,若采用顺序存储结构,则平均需要移动 (1) 个元素;若采用单链表存储,则平均需要移动 (2) 个元素。
- A. 1
- B. (n-1)/2
- C. logn
- D. n
答案:B
解析:
本题考查数据结构基础知识。 线性表是一个线性序列,在顺序存储方式下,若删除其中一个元素,需要将其后的元素逐个前移,使得元素之间没有空闲单元。表长为n时,共有n个可删除的元素,删除元素a1时需要移动n-1个元素,删除元素an时不需要移动元素,因此,等概率下删除一个元素时平均的移动元素次数Edelete为(n-1)/2。 线性表若采用单链表存储,插入和删除元素的实质都是对相关指针的修改,而不需要移动元素。
单选题
57. 在一条笔直公路的一边有许多房子,现要安装消防栓,每个消防栓的覆盖范围远大于房子的面积,如下图所示。现求解能覆盖所有房子的最少消防栓数和安装方案(问题求解过程中,可将房子和消防栓均视为直线上的点)。 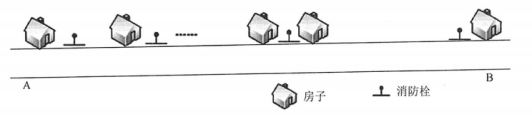 该问题求解算法的基本思路为:从左端的第一栋房子开始,在其右侧m米处安装一个消防栓,去掉被该消防栓覆盖的所有房子。在剩余的房子中重复上述操作,直到所有房子被覆盖。算法采用的设计策略为 (1) ;对应的时间复杂度为 (2) 。 假设公路起点A的坐标为0,消防栓的覆盖范围(半径)为20米,10栋房子的坐标为(10,20,30,35,60,80,160,210,260,300),单位为米。根据上述算法,共需要安装 (3) 个消防栓。以下关于该求解算法的叙述中,正确的是 (4) 。
- A. 分治
- B. 动态规划
- C. 贪心
- D. 回溯
答案:C
解析:
本题考查算法设计与分析的基础知识。
根据题干描述,每次在未被覆盖的房子中选择最左端的房子,在其右侧20米处(覆盖范围)安装消防栓。这是典型的贪心策略求解问题的思路。因此算法设计采用的是贪心策略。
在求解过程中,只需要遍历一次房子即可,因此算法的时间复杂度为Θ(n)。
题干中的案例可以按如下图方式安装消防栓,黑点表示房子,圆圈表示消防栓的覆盖范围。
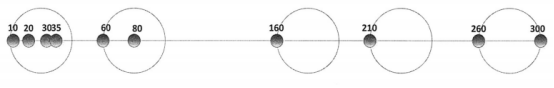 由上图可见,安装5个消防栓就可以覆盖这10栋房子。
对于得到一个最优解是动态规划的特点,可以得到问题所有的最优解,是回溯法的特征,可以排除A、B选项。选择C 。有些实例,可能得不到最优解。
单选题
58. 在一条笔直公路的一边有许多房子,现要安装消防栓,每个消防栓的覆盖范围远大于房子的面积,如下图所示。现求解能覆盖所有房子的最少消防栓数和安装方案(问题求解过程中,可将房子和消防栓均视为直线上的点)。 该问题求解算法的基本思路为:从左端的第一栋房子开始,在其右侧m米处安装一个消防栓,去掉被该消防栓覆盖的所有房子。在剩余的房子中重复上述操作,直到所有房子被覆盖。算法采用的设计策略为 (1) ;对应的时间复杂度为 (2) 。 假设公路起点A的坐标为0,消防栓的覆盖范围(半径)为20米,10栋房子的坐标为(10,20,30,35,60,80,160,210,260,300),单位为米。根据上述算法,共需要安装 (3) 个消防栓。以下关于该求解算法的叙述中,正确的是 (4) 。
- A. Θ(lgn)
- B. Θ(n)
- C. Θ(nlgn)
- D. Θ(n2)
答案:B
解析:
本题考查算法设计与分析的基础知识。
根据题干描述,每次在未被覆盖的房子中选择最左端的房子,在其右侧20米处(覆盖范围)安装消防栓。这是典型的贪心策略求解问题的思路。因此算法设计采用的是贪心策略。
在求解过程中,只需要遍历一次房子即可,因此算法的时间复杂度为Θ(n)。
题干中的案例可以按如下图方式安装消防栓,黑点表示房子,圆圈表示消防栓的覆盖范围。
由上图可见,安装5个消防栓就可以覆盖这10栋房子。
对于得到一个最优解是动态规划的特点,可以得到问题所有的最优解,是回溯法的特征,可以排除A、B选项。选择C 。有些实例,可能得不到最优解。
单选题
59. 在一条笔直公路的一边有许多房子,现要安装消防栓,每个消防栓的覆盖范围远大于房子的面积,如下图所示。现求解能覆盖所有房子的最少消防栓数和安装方案(问题求解过程中,可将房子和消防栓均视为直线上的点)。 该问题求解算法的基本思路为:从左端的第一栋房子开始,在其右侧m米处安装一个消防栓,去掉被该消防栓覆盖的所有房子。在剩余的房子中重复上述操作,直到所有房子被覆盖。算法采用的设计策略为 (1) ;对应的时间复杂度为 (2) 。 假设公路起点A的坐标为0,消防栓的覆盖范围(半径)为20米,10栋房子的坐标为(10,20,30,35,60,80,160,210,260,300),单位为米。根据上述算法,共需要安装 (3) 个消防栓。以下关于该求解算法的叙述中,正确的是 (4) 。
- A. 4
- B. 5
- C. 6
- D. 7
答案:B
解析:
本题考查算法设计与分析的基础知识。
根据题干描述,每次在未被覆盖的房子中选择最左端的房子,在其右侧20米处(覆盖范围)安装消防栓。这是典型的贪心策略求解问题的思路。因此算法设计采用的是贪心策略。
在求解过程中,只需要遍历一次房子即可,因此算法的时间复杂度为Θ(n)。
题干中的案例可以按如下图方式安装消防栓,黑点表示房子,圆圈表示消防栓的覆盖范围。
由上图可见,安装5个消防栓就可以覆盖这10栋房子。
对于得到一个最优解是动态规划的特点,可以得到问题所有的最优解,是回溯法的特征,可以排除A、B选项。选择C。有些实例,可能得不到最优解。
单选题
60. 在一条笔直公路的一边有许多房子,现要安装消防栓,每个消防栓的覆盖范围远大于房子的面积,如下图所示。现求解能覆盖所有房子的最少消防栓数和安装方案(问题求解过程中,可将房子和消防栓均视为直线上的点)。 该问题求解算法的基本思路为:从左端的第一栋房子开始,在其右侧m米处安装一个消防栓,去掉被该消防栓覆盖的所有房子。在剩余的房子中重复上述操作,直到所有房子被覆盖。算法采用的设计策略为 (1) ;对应的时间复杂度为 (2) 。 假设公路起点A的坐标为0,消防栓的覆盖范围(半径)为20米,10栋房子的坐标为(10,20,30,35,60,80,160,210,260,300),单位为米。根据上述算法,共需要安装 (3) 个消防栓。以下关于该求解算法的叙述中,正确的是 (4) 。
- A. 肯定可以求得问题的一个最优解
- B. 可以求得问题的所有最优解
- C. 有些实例,可能得不到最优解
- D. 只能得到近似最优解
答案:C
解析:
本题考查算法设计与分析的基础知识。
根据题干描述,每次在未被覆盖的房子中选择最左端的房子,在其右侧20米处(覆盖范围)安装消防栓。这是典型的贪心策略求解问题的思路。因此算法设计采用的是贪心策略。
在求解过程中,只需要遍历一次房子即可,因此算法的时间复杂度为Θ(n)。
题干中的案例可以按如下图方式安装消防栓,黑点表示房子,圆圈表示消防栓的覆盖范围。
由上图可见,安装5个消防栓就可以覆盖这10栋房子。
对于得到一个最优解是动态规划的特点,可以得到问题所有的最优解,是回溯法的特征,可以排除A、B选项。选择C 。有些实例,可能得不到最优解。
单选题
61. 一棵有n个结点的树的所有结点的度数之和为( )。
- A. n-1
- B. n
- C. n+1
- D. 2n
答案:A
解析:
这道题有点偏,可以当成一个常识。除了根结点之外,其他每个结点都是某个结点的孩子结点,因此树中所有结点的度数加1等于结点数。
单选题
62. 在设计算法时,通常应考虑以下原则:首先说设计的算法必须是 ( ) ,其次应有很好的 ( ) ,还必须具有 ( ) ,最后应考虑所设计的算法具有 ( ) 。
- A. 正确的
- B. 有穷性
- C. 有输入
- D. 用户需求
答案:A
解析:
算法是对问题求解过程的一种描述,是为解决一个或一类问题给出的一个确定的、有限长的操作序列。在设计算法时,通常应考虑以下原则:首先说设计的算法必须是"正确的",其次应有很好的"可读性",还必须具有"健壮性",最后应考虑所设计的算法具有"高效率与低存储量"。 所谓算法是正确的,除了应该满足算法说明中写明的"功能"之外,应对各组典型的带有苛刻条件的输入数据得出正确的结果。在算法是正确的前提下,算法的可读性是摆在第一位的。算法的效率是指算法的执行时间,算法的存储量是指算法执行过程中所需最大存储空间。
单选题
63. 在设计算法时,通常应考虑以下原则:首先说设计的算法必须是 ( ) ,其次应有很好的 ( ) ,还必须具有 ( ) ,最后应考虑所设计的算法具有 ( ) 。
- A. 有穷性
- B. 可读性
- C. 确定性
- D. 高效率与低存储量
答案:B
解析:
算法是对问题求解过程的一种描述,是为解决一个或一类问题给出的一个确定的、有限长的操作序列。在设计算法时,通常应考虑以下原则:首先说设计的算法必须是"正确的",其次应有很好的"可读性",还必须具有"健壮性",最后应考虑所设计的算法具有"高效率与低存储量"。 所谓算法是正确的,除了应该满足算法说明中写明的"功能"之外,应对各组典型的带有苛刻条件的输入数据得出正确的结果。在算法是正确的前提下,算法的可读性是摆在第一位的。算法的效率是指算法的执行时间,算法的存储量是指算法执行过程中所需最大存储空间。
单选题
64. 在设计算法时,通常应考虑以下原则:首先说设计的算法必须是 ( ) ,其次应有很好的 ( ) ,还必须具有 ( ) ,最后应考虑所设计的算法具有 ( ) 。
- A. 有输入
- B. 确定性
- C. 健壮性
- D. 可读性
答案:C
解析:
算法是对问题求解过程的一种描述,是为解决一个或一类问题给出的一个确定的、有限长的操作序列。在设计算法时,通常应考虑以下原则:首先说设计的算法必须是"正确的",其次应有很好的"可读性",还必须具有"健壮性",最后应考虑所设计的算法具有"高效率与低存储量"。 所谓算法是正确的,除了应该满足算法说明中写明的"功能"之外,应对各组典型的带有苛刻条件的输入数据得出正确的结果。在算法是正确的前提下,算法的可读性是摆在第一位的。算法的效率是指算法的执行时间,算法的存储量是指算法执行过程中所需最大存储空间。
单选题
65. 在设计算法时,通常应考虑以下原则:首先说设计的算法必须是 ( ) ,其次应有很好的 ( ) ,还必须具有 ( ) ,最后应考虑所设计的算法具有 ( ) 。
- A. 可读性
- B. 有输入
- C. 健壮性
- D. 高效率与低存储量
答案:D
解析:
算法是对问题求解过程的一种描述,是为解决一个或一类问题给出的一个确定的、有限长的操作序列。在设计算法时,通常应考虑以下原则:首先说设计的算法必须是"正确的",其次应有很好的"可读性",还必须具有"健壮性",最后应考虑所设计的算法具有"高效率与低存储量"。 所谓算法是正确的,除了应该满足算法说明中写明的"功能"之外,应对各组典型的带有苛刻条件的输入数据得出正确的结果。在算法是正确的前提下,算法的可读性是摆在第一位的。算法的效率是指算法的执行时间,算法的存储量是指算法执行过程中所需最大存储空间。
单选题
66. 求解两个长度为n的序列X和Y的一个最长公共序列(如序列ABCBDAB和BDCABA的一个最长公共子序列为BCBA)可以采用多种计算方法。如可以采用蛮力法,对X的每一个子序列,判断其是否也是Y的子序列,最后求出最长的即可,该方法的时间复杂度为 (1) 。经分析发现该问题具有最优子序列,可以定义序列长度分别为i和j的两个序列X和Y的最长公共子序列的长度为C[i,j],如下式所示。该方法的时间复杂度为 (2) 。 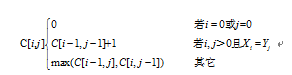
- A.

- B.

- C.

- D.

答案:D
解析:
第69题一个给定的序列的子序列,就是将给定序列中零个或多个元素去掉之后得到的结果。序列ABCBDAB去掉划线的字符ABCBDAB得到的BCBA就是它的一个子序列。一个序列的子序列有2n个,将X、Y的所有子序列都检查过后即可求出X、Y的最长公共子序列。这种方式的时间复杂度为O(n2n)。
第70题引进一个二维数组c[i][j]表示X的i位和Y的j位之前的最长公共子序列的长度,按照公式将数值填入下表。
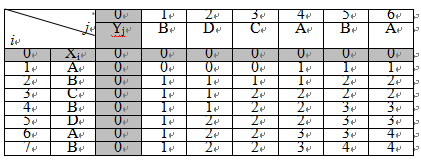 此时,c[i][j]中最大的数就是X和Y的最长公共子序列的长度,等于4。该算法的时间复杂度为O(n2)。
单选题
67. 求解两个长度为n的序列X和Y的一个最长公共序列(如序列ABCBDAB和BDCABA的一个最长公共子序列为BCBA)可以采用多种计算方法。如可以采用蛮力法,对X的每一个子序列,判断其是否也是Y的子序列,最后求出最长的即可,该方法的时间复杂度为 (1) 。经分析发现该问题具有最优子序列,可以定义序列长度分别为i和j的两个序列X和Y的最长公共子序列的长度为C[i,j],如下式所示。该方法的时间复杂度为 (2) 。
- A.

- B.

- C.

- D.

答案:A
解析:
第69题一个给定的序列的子序列,就是将给定序列中零个或多个元素去掉之后得到的结果。序列ABCBDAB去掉划线的字符ABCBDAB得到的BCBA就是它的一个子序列。一个序列的子序列有2n个,将X、Y的所有子序列都检查过后即可求出X、Y的最长公共子序列。这种方式的时间复杂度为  。
第70题引进一个二维数组c[i][j]表示X的i位和Y的j位之前的最长公共子序列的长度,按照公式将数值填入下表。
此时,c[i][j]中最大的数就是X和Y的最长公共子序列的长度,等于4。该算法的时间复杂度为
 。
单选题
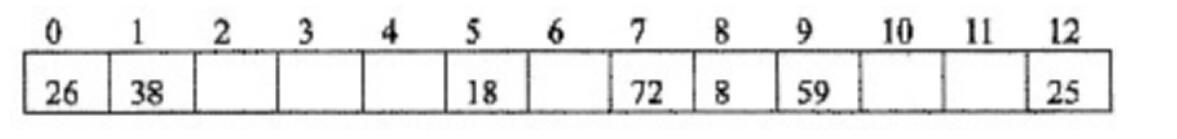
68. 对于关键字序列(26,25,72,38,8,18,59),采用散列函数H(Key)=Key mod 13构造散列表(哈希表)。若采用线性探测的开放定址法解决冲突(顺序地探查可用存储单元),则关键字59所在散列表中的地址为(56)。
- A. 6
- B. 7
- C. 8
- D. 9
答案:D
解析:
本题考查散列表的基本概念。
对于关键字序列(26,25,72,38,8,18,59)和散列函数H(Key)=Key mod 13,采用线性探测的开放定址法解决冲突构造的散列表如下表所示:
单选题
69. 分治算法设计技术(58)。
- A. 一般由三个步骤组成:问题划分、递归求解、合并解
- B. 一定是用递归技术来实现
- C. 将问题划分为多个规模相等的子问题
- D. 划分代价很小而合并代价很大
答案:A
解析:
本题考查算法设计技术。 分治方法是一种重要的算法设计技术(设计策略),该策略将原问题划分成n个规模较小而结构与原问题相似的子问题;递归地解决这些子问题;然后再合并其结果,最终得到原问题的解。分治算法往往用递归技术来实现,但并非必须。分治算法最理想的情况是划分为k个规模相等的子问题,但很多时候往往不能均匀地划分子问题。分治算法的代价在划分子问题和合并子问题的解上,根据不同的问题,划分的代价和合并的代价有所不同。例如归并排序中,主要的计算代价在合并解上,而在快速排序中,主要的计算代价在划分子问题上。
单选题
70. 用插入排序和归并排序算法对数组<3,1,4,1,5,9,6,5>进行从小到大排序,则分别需要进行(59)次数组元素之间的比较。
- A. 12,14
- B. 10,14
- C. 12,16
- D. 10,16
答案:A
解析:
本题考查排序算法。 插入排序算法的基本思想是将待排序数组分为两个部分,已排好序部分和未排序部分。其主要步骤为:开始时,第一个元素在已排好序部分中,其余元素在未排序部分。然后依次从未排序部分中取出第一个元素,从后向前与排好序部分的元素进行比较并将其插入到已排好序部分的正确位置。直到所有元素排好序。 归并排序的基本思想是将待排序数组划分为子问题,对子问题求解,然后合并解。其主要步骤为:将数组分为两个相同规模的子数组,分别包含前n/2个元素和后n/2个元素;递归地排序这两个子数组;合并排好序的两个子数组,依次比较两个排好序的子数组的元素,得到整个数组的排好序的序列。 根据上述算法思想和算法步骤,可以得到题中实例的比较次数分别为12和14。
单选题
71. 设下三角矩阵(上三角部分的元素值都为0)A[0..n,0..n]如下所示,将该三角矩阵的所有非零元素(即行下标不小于列下标的元素)按行优先压缩存储在容量足够大的数组M[]中(下标从1开始),则元素A[i,j](0%E2%89%A4i%E2%89%A4n%EF%BC%8Cj%E2%89%A4i)存储在数组M的(61)中。 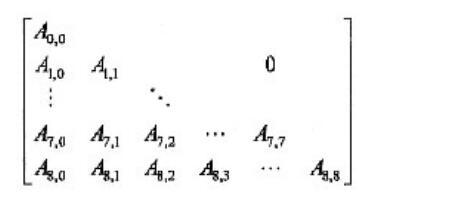
- A.
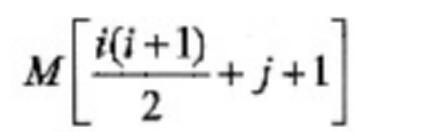
- B.
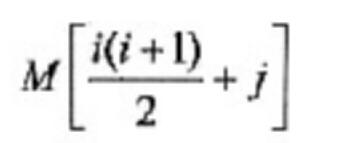
- C.
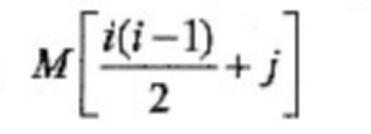
- D.
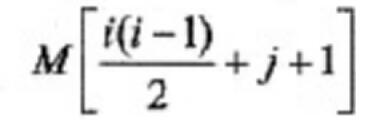
答案:A
解析:
本题考查数组存储的基础知识。按行方式存储时,元素A[i,j]之前的元素个数为(1+2+…+i+j),由于数组M的下标从1开始,因此,存储A[i,j]的是M[1+2+…+i+j+1],即
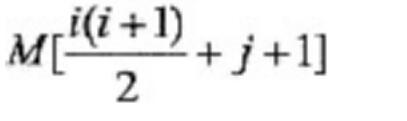
单选题
72. 迪杰斯特拉(Dijkstra)算法用于求解图上的单源点最短路径。该算法按路径长度递增次序产生最短路径,本质上说,该算法是一种基干(63)策略的算法。
- A. 分治
- B. 动态规划
- C. 贪心
- D. 回溯
答案:C
解析:
本题考查算法的设计策略。 单源点最短路径问题是指给定图G和源点v0,求从v0到图G中其余各项点的最短路径。迪杰斯特拉(Dijkstra)算法是一个求解单源点最短路径的经典算法,其思想是:把图中所有的顶点分成两个集合S和T,S集合开始时只包含顶点v0,T集合开始时包含图中除了顶点v0之外的所有顶点。凡是以v0为源点,已经确定了最短路径的终点并入S集合中,顶点集合T则是尚未确定最短路径的顶点集合。按各顶点与v0间最短路径长度递增的次序,逐个把T集合中的顶点加入到S集合中,使得从v0到S集合中各顶点的路径长度始终不大于从v0到T集合中各顶点的路径长度。该算法是以一种贪心的方式将T集合中的顶点加入到S集合中的,而且该贪心方法可以求得问题的最优解。
单选题
73. 在有n个无序无重复元素值的数组中查找第i小的数的算法描述如下:任意取一个元素r,用划分操作确定其在数组中的位置,假设元素r为第k小的数。若i等于k,则返回该元素值;若i小于k,则在划分的前半部分递归进行划分操作找第i小的数;否则在划分的后半部分递归进行划分操作找第k-i小的数。该算法是一种基于(64)策略的算法。
- A. 分治
- B. 动态规划
- C. 贪心
- D. 回溯
答案:A
解析:
本题考查算法的设计策略。 从题干可以看出,划分操作与快速排序中的划分操作是一样的,确定某个元素如r的最终位置,划分后,在r之前的元素都小于r,在r之后的元素都大于r(假设无重复元素)。因此可以据此确定r是数组中第几小的数。题干所述的算法把找第i小的数转换为确定任意一个元素是第几小的数,然后根据这个结果再在依据该元素划分后得到的结果在前一部分还是后一部分来继续确定某个元素为第几小的数,重复这种处理,直到找到第i小的数。这是分治策略的一个典型应用。
单选题
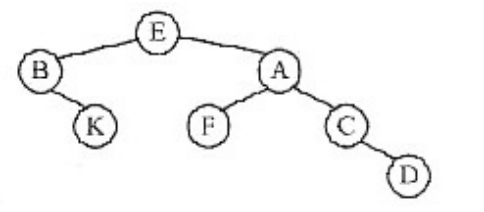
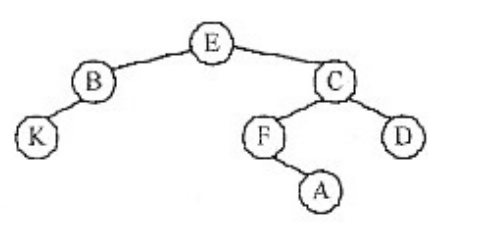
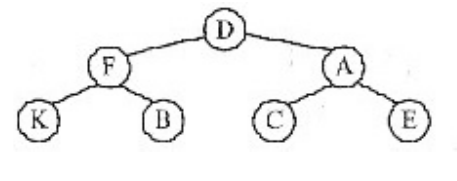
74. 若某二叉树的后序遍历序列为KBFDCAE,中序遍历序列为BKEFACD,则该二叉树为(53)。
- A.
- B.
- C.
- D.
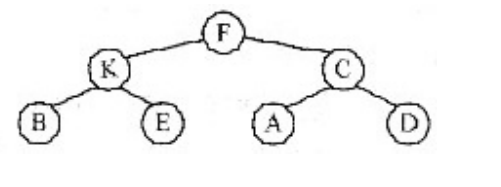
答案:A
解析:
依题意,选项A的二叉树,其中序遍历序列为BKEFACD,后序遍历序列为KBFDCAE。
单选题
75. 在13个元素构成的有序表M[1…13]中进行折半查找(向下取整),若找到的元素为M[4],则被比较的元素依次为(54)。
- A. M[7]、M[3]、M[5]、M[4]
- B. M[7]、M[5]、M[4]
- C. M[7]、M[6]、M[4]
- D. M[7]、M[4]
答案:A
解析:
在13个元素构成的有序表M[1…13]中进行折半查找(向下取整),若找到的元素为M[4],则被比较的元素依次为M[7]、M[3]、M[5]、M[4]。
单选题
76. 拓扑排序是将有向图中所有顶点排成一个线性序列的过程,并且该序列满足:若在AOV网中从顶点νi到νj有一条路径,则顶点νi必然在顶点νj之前。对于下图所示的有向图,(55)是其拓扑序列。 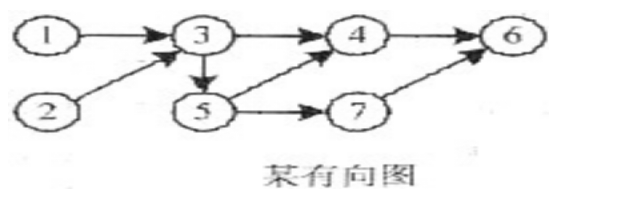
- A. 1 2 3 4 5 7 6
- B. 1 2 3 5 4 6 7
- C. 2 1 3 5 4 7 6
- D. 2 1 3 4 5 6 7
答案:C
解析(AI 生成):
拓扑排序反复输出入度为 0 的顶点并删除其出弧。检验序列只需看每条弧的弧尾是否排在弧头之前。C 中 2、1 可先输出,3、5 都在 4 之前,7 在 6 之前,全部约束满足;A、B、D 均存在弧头先于弧尾出现的情况。
单选题
77. 将数组{1,1,2,4,7,5}从小到大排序,若采用(1)排序算法,则元素之间需要进行的比较次数最少,共需要进行(2)次元素之间的比较。
- A. 直接插入
- B. 归并
- C. 堆
- D. 快速
答案:A
解析:
直接插入排序算法是:每次从无序表中取出第一个元素,把它插入到有序表的合适位置,使有序表仍然有序。第1趟比较前两个数,然后把第2个数按大小插入到有序表中;第2趟把第3个数据与前两个数从前向后扫描,把第3个数按大小插入到有序表中;依次进行下去,进行了(n-1)趟扫描以后就完成了整个排序过程。直接插入排序属于稳定的排序,最坏时间复杂性为  (n^2),空间复杂度为0(1)。
依题意,将数组{1,1,2,4,7,5}从小到大排序,若采用直接插入排序算法,则元素之间需要进行的比较次数最少,共需要进行6次元素之间的比较。
单选题
78. 将数组{1,1,2,4,7,5}从小到大排序,若采用(1)排序算法,则元素之间需要进行的比较次数最少,共需要进行(2)次元素之间的比较。
- A. 5
- B. 6
- C. 7
- D. 8
答案:B
解析:
直接插入排序算法是:每次从无序表中取出第一个元素,把它插入到有序表的合适位置,使有序表仍然有序。第1趟比较前两个数,然后把第2个数按大小插入到有序表中;第2趟把第3个数据与前两个数从前向后扫描,把第3个数按大小插入到有序表中;依次进行下去,进行了(n-1)趟扫描以后就完成了整个排序过程。直接插入排序属于稳定的排序,最坏时间复杂性为 (n^2),空间复杂度为0(1)。
依题意,将数组{1,1,2,4,7,5}从小到大排序,若采用直接插入排序算法,则元素之间需要进行的比较次数最少,共需要进行6次元素之间的比较。
单选题
79. 霍夫曼编码将频繁出现的字符采用短编码,出现频率较低的字符采用长编码。具体的操作过程为:i)以每个字符的出现频率作为关键字构建最小优先级队列;ii)取出关键字最小的两个结点生成子树,根节点的关键字为孩子节点关键字之和,并将根节点插入到最小优先级队列中,直至得到一棵最优编码树。 霍夫曼编码方案是基于(1)策略的。用该方案对包含a到f6个字符的文件进行编码,文件包含100000个字符,每个字符的出现频率(用百分比表示)如表1-3所示,则与固定长度编码相比,该编码方案节省了(2)存储空间。 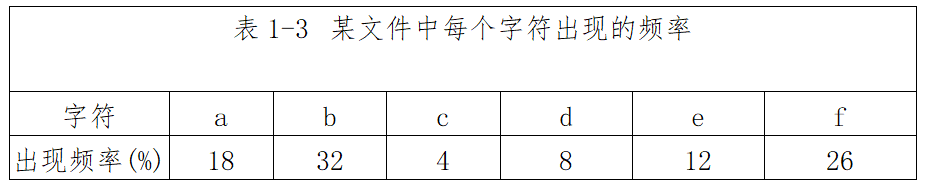
- A. 分治
- B. 贪心
- C. 动态规划
- D. 回溯
答案:B
解析:
根据频率构造的哈夫曼树如下所示:
由图可知,各字符的哈夫曼编码长度为a:2,b:2,c:4,e:3,f:2。 压缩后的编码长度为100000*(218%+232%+44%+48%+312%+226%)=236000, 压缩前需要3位二进制编码才能表示5个不同的字符,因此压缩前的编码长度为 3*100000=300000,代入计算公式可求得压缩比=(1-236000/300000)*100%≈21.33%
单选题
80. 霍夫曼编码将频繁出现的字符采用短编码,出现频率较低的字符采用长编码。具体的操作过程为:i)以每个字符的出现频率作为关键字构建最小优先级队列;ii)取出关键字最小的两个结点生成子树,根节点的关键字为孩子节点关键字之和,并将根节点插入到最小优先级队列中,直至得到一棵最优编码树。 霍夫曼编码方案是基于(1)策略的。用该方案对包含a到f6个字符的文件进行编码,文件包含100000个字符,每个字符的出现频率(用百分比表示)如表1-3所示,则与固定长度编码相比,该编码方案节省了(2)存储空间。
- A. 21%
- B. 27%
- C. 18%
- D. 36%
答案:A
解析:
根据频率构造的哈夫曼树如下所示:
由图可知,各字符的哈夫曼编码长度为a:2,b:2,c:4,e:3,f:2。 压缩后的编码长度为100000*(218%+232%+44%+48%+312%+226%)=236000, 压缩前需要3位二进制编码才能表示5个不同的字符,因此压缩前的编码长度为 3*100000=300000,代入计算公式可求得压缩比=(1-236000/300000)*100%≈21.33%
单选题
81. 设一个包含N个顶点、E条边的简单有向图采用邻接矩阵存储结构(矩阵元素A[i][j]等于1/0分别表示顶点i与顶点j之间有/无弧),则该矩阵的元素数目为(1) ,其中非零元素数目为(2) 。
- A. E^2
- B. N^2
- C. N^2-E^2
- D. N^2+E^2
答案:B
解析:
本题考查数据结构中图的存储结构。
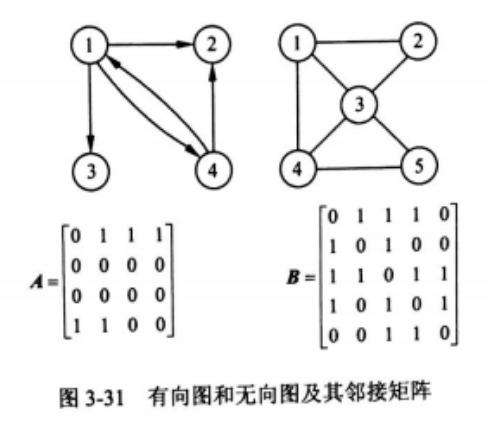
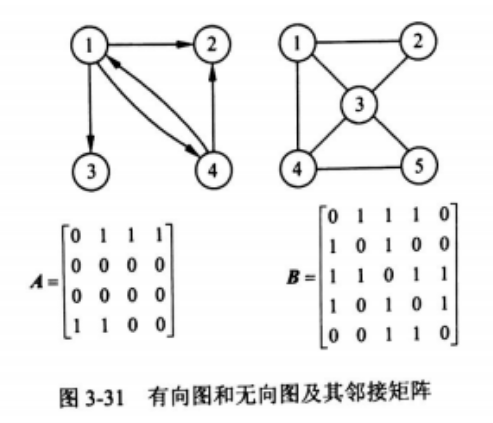
对于一个具有n个顶点的图,其邻接矩阵为n*n个元素的矩阵。无向图的邻接矩阵是对称矩阵,如下图(a)所示。对于有向图,其邻接矩阵中非零元素的数目表示有向弧的个数。有向图的邻接矩阵如下图(b)所示。
单选题
82. 设一个包含N个顶点、E条边的简单有向图采用邻接矩阵存储结构(矩阵元素A[i][j]等于1/0分别表示顶点i与顶点j之间有/无弧),则该矩阵的元素数目为(1) ,其中非零元素数目为(2) 。
- A. N
- B. N+E
- C. E
- D. N-E
答案:C
解析:
本题考查数据结构中图的存储结构。
对于一个具有n个顶点的图,其邻接矩阵为n*n个元素的矩阵。无向图的邻接矩阵是对称矩阵,如下图(a)所示。对于有向图,其邻接矩阵中非零元素的数目表示有向弧的个数。有向图的邻接矩阵如下图(b)所示。
单选题
83. 57、【51CTO学堂-学员回忆版】利用栈对算术表达式 10*(40-30/5)+20求值时,存放操作数的栈(初始为空)的容量至少为_(57)_,才能满足暂存该表达式中的运算数或运算结果的要求。
- A. 2
- B. 3
- C. 4
- D. 5
答案:C
解析:
这类题目可以先将算术表达式转成后缀式,然后看第一个算数符号前有多少个数字,即可得出存放操作数的容量至少为多少。
单选题
84. 58、【51CTO学堂-学员回忆版】设有5个字符,根据其使用频率为其构造哈夫曼编码。以下编码方案中,(58) 是不可能的。
- A. {111,110,101,100,0}
- B. {0000,0001,001,01,1}
- C. {11,10,01,001,000}
- D. {11,10,011,010,000}
答案:D
解析(AI 生成):
哈夫曼树是严格二叉树,每个内部结点都有两个孩子,因此任一编码都不能是另一编码的前缀。D 中 0 分支下 01 有两个孩子,00 却只有 000 一个孩子,出现度为 1 的结点,构造不出哈夫曼树。A、B、C 都是完整的前缀码。
单选题
85. 59、【51CTO学堂-学员回忆版】设有向图G 具有n个顶点、e条弧,采用邻接表存储,则完成广度优先遍历的时间复杂度为(59)
- A. O(n+e)
- B. O(n^2)
- C. O(e^2)
- D. O(n*e)
答案:A
解析(AI 生成):
邻接表存储时,广度优先遍历中每个顶点至多入队、出队一次,共 O(n);扫描邻接表时每条弧只被检查一次,共 O(e)。两者相加为 O(n+e),与顶点数和边数成线性关系,故选 A;O(n^2) 是邻接矩阵存储时的结论。
单选题
86. 60、【51CTO学堂-学员回忆版】对某有序概序表进行折半查找《二分查找》 时,进行比较的关键字序列不可能是(60)
- A. 42,61,90,85,77
- B. 42,90,85,61,77
- C. 90,85,61,77,42
- D. 90,85,77,61,42
答案:C
解析(AI 生成):
折半查找每比较一次都把待查区间缩小一半,后续比较的关键字必须落在前面比较所限定的区间内。C 中 90、85、61 一路向左,说明目标大于 61,随后又比较 42,落在该区间之外,自相矛盾。其余三项的关键字均未越出区间。
单选题
87. 61、【51CTO学堂-学员回忆版】设由三棵树构成的森林中,第一棵树、第二棵树和第三棵树的结点总数分别为 n1、n2 和n3。将该森林转换为一棵二叉树,那么该二叉树的右子树包含_(61)个结点。
- A. n1
- B. n1+n2
- C. n3
- D. n2+n3
答案:D
解析(AI 生成):
森林转二叉树采用“左孩子右兄弟”:第一棵树的根作二叉树的根,其子树挂在左分支;第二、三棵树的根依次作为前一根的右孩子,整条右链由后两棵树构成。故右子树含 n2+n3 个结点,选 D;n1 分布在根及其左分支上。
单选题
88. 62、【51CTO学堂-学员回忆版】对一组数据进行排序,要求排序算法的时间复杂度为 O(nlgn),且要求排序是稳定的,则可采用_(62).算法。若要求排序算法的时间复杂度为 O(nlgn),且在原数据上进行,即空间复杂度为 O(1),则可采用_(63) 算法。
- A. 直接插入排序
- B. 堆排序
- C. 快速排序
- D. 归并排序
答案:D
解析(AI 生成):
归并排序最好、最坏均为 O(nlgn),合并时相等元素保持原有先后,是稳定排序,故选 D。堆排序和快速排序同为 O(nlgn) 却不稳定;直接插入排序稳定但为 O(n^2)。第二空要求原地进行、空间 O(1),应选堆排序。
单选题
89. 62-63、【51CTO学堂-学员回忆版】对一组数据进行排序,要求排序算法的时间复杂度为 O(nlgn),且要求排序是稳定的,则可采用_(62).算法。若要求排序算法的时间复杂度为 O(nlgn),且在原数据上进行,即空间复杂度为 O(1),则可采用_(63) 算法。
- A. 直接插入排序
- B. 堆排序
- C. 快速排序
- D. 归并排序
答案:D
解析:
直接插入排序是稳定的,但是时间复杂度不符合。 堆排序时间复杂度符合,但是不稳定的。 快速排序时间复杂度符合,但是不稳定。 归并排序二者都符合,因此选择D选项。
单选题
90. 64-65、【51CTO学堂-学员回忆版】采用 Kruskal 算法求解下图的最小生成树,采用的算法设计策略是(64)。该小生成树的权值是(65)。 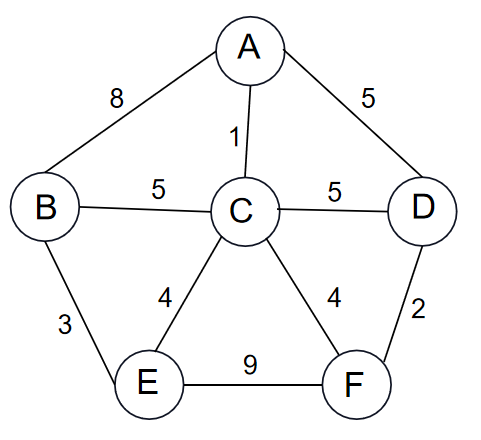
- A. 分治法
- B. 动态规划
- C. 贪心法
- D. 追溯法
答案:C
解析:
克鲁斯卡尔算法是一种贪心算法,用于求解最小生成树问题。 克鲁斯卡尔算法的基本思想是从边的集合中选择边,使得所选边的集合构成一棵连通图,并且这些边的权值之和最小。算法的实现过程可以概括为以下几个步骤: 输入:输入图的顶点数和边数,以及每条边的起点、终点和权重。 初始化:为每个顶点分配一个唯一的标识符,通常是将每个顶点的标识符初始化为其自身的编号。 排序:将所有边按照权重从小到大排序。 选择边:从排序后的边中选择边,如果两条边连接的是同一个集合中的顶点,则跳过;否则,将这两点所属的集合合并,并选择这条边加入到最小生成树中。 结束条件:当选择的边数达到顶点数减一(即n−1,其中n是顶点数)时,算法结束。
克鲁斯卡尔算法的时间复杂度主要取决于边的排序操作,通常采用并查集来优化选择和合并的过程,从而降低时间复杂度。排序的时间复杂度为O(ElogE),而选择和合并的时间复杂度则可以通过并查集优化到O(Eα(V)),其中α(V)是逆阿克曼函数的值,可以认为是一个非常小的常数。因此,克鲁斯卡尔算法的总时间复杂度大约为O(ElogE)。 克鲁斯卡尔算法的应用非常广泛,特别是在图论和计算机网络中,它被用来解决如何以最小的代价连接所有节点的问题。此外,克鲁斯卡尔算法也是贪心算法的一个典型例子,它通过逐步选择权重最小的边来构建最小生成树,体现了贪心算法的核心思想:每一步都做出在当前看来最好的选择,从而希望导致全局最优解。
单选题
91. 64-65、【51CTO学堂-学员回忆版】采用 Kruskal 算法求解下图的最小生成树,采用的算法设计策略是(64)。该小生成树的权值是(65)。
- A. 14
- B. 16
- C. 20
- D. 32
答案:A
解析(AI 生成):
Kruskal 算法按边权从小到大考察各边,用并查集判断两端点是否已连通,不成回路就选入,直到选满 n-1 条边,属于贪心策略。本例依次选入权值最小的若干边,累计权值为 14。16、20、32 是把成环边或较大边误计入的结果。
单选题
92. 对于一棵树,每个结点的孩子个数称为结点的度,结点度数的最大值成为树的度。某树T的度为4,其中有5个度为4的结点,8个度为3的结点,6个度为2的结点,10个度为1的结点,则T中的叶子结点个数为( )。
- A. 38
- B. 29
- C. 66
- D. 57
答案:A
解析:
设度为0的叶子结点数为n0,度为1的结点数为n1,度为2的结点数为n2,度为3的结点数是n3,度为4的结点数为n4。这里有一个公式,边的总数=结点总数-1,边指的是连接结点的线段。那么就有5n4+8n3+6n2+10n1=n0+n1+n2+n3+n4-1,答案是38。
单选题
93. 在29个元素构成的查找表中查找任意一个元素时,可保证最多与表中5个元素进行比较即可确定查找结果,则采用的查找表及查找方法是( )。
- A. 二叉排序树上的查找
- B. 顺序表上的顺序查找
- C. 有序顺序表上的二分查找
- D. 散列表中的哈希查找
答案:C
解析:
由29个元素构成的有序顺序表,采用二分查找,二分查找的决策树深度为log229向上取整为5,比较次数最多达5次。采用二叉排序树查找,若二叉排序树为单支树,则比较次数最多可达29次。采用顺序表进行顺序查找,比较次数最多也可达29次。若采用散列表中的哈希查找,在前28个地址都满的情况下,在进行最后一个函数值的哈希值为0,则需从头开始比较到最后一个位置,因此比较次数最多可达29次。
单选题
94. 森林的叶子节点是( )
- A. 二叉树中没有左孩子的节点
- B. 二叉树中没有右孩子的节点
- C. 森林中度为0的节点
- D. 二叉树中度为1的节点
答案:C
解析(AI 生成):
叶子是度为 0 的结点,森林中同样如此,故 C 正确。森林转成二叉树后,原叶子表现为没有左孩子、但仍可能有右孩子(指向兄弟)的结点,所以 A、B 用二叉树的孩子情况描述森林叶子并不准确,D 的度为 1 更不是叶子。
单选题
95. 关于存在尾指针的链表操作中,说法正确的是( )
- A. 新增一个头结点需要遍历链表
- B. 新增一个尾结点需要遍历链表
- C. 删除最后一个节点需要遍历链表
- D. 删除第一个节点需要遍历链表
答案:C
解析:
A选项:新增一个头结点通常只需要在链表的开始处插入一个新节点,并将它的next指针指向原链表的头结点(如果原链表非空的话)。这个过程并不需要遍历整个链表。 B选项:新增一个尾结点通常意味着需要找到链表的最后一个节点,并将新节点的next指针设置为null(或对应语言中的空值),同时更新最后一个节点的next指针以指向新节点。但是,如果链表有一个指向尾部的指针(比如双向链表或某些特定设计的单链表),那么就不需要遍历整个链表来找到尾结点。 C选项:为了删除链表的最后一个节点,我们需要找到倒数第二个节点(也就是原最后一个节点的前一个节点),并将其next指针设置为null。由于我们没有直接指向最后一个节点的指针,所以通常需要遍历链表来找到它。 D选项:删除链表的第一个节点(即头结点)通常只需要将头指针指向第二个节点(如果链表非空的话)。这个过程并不需要遍历整个链表。 因此,说法正确的是 C。
单选题
96. 对下列有向图的邻接矩阵,进行深度遍历的次序是( ) 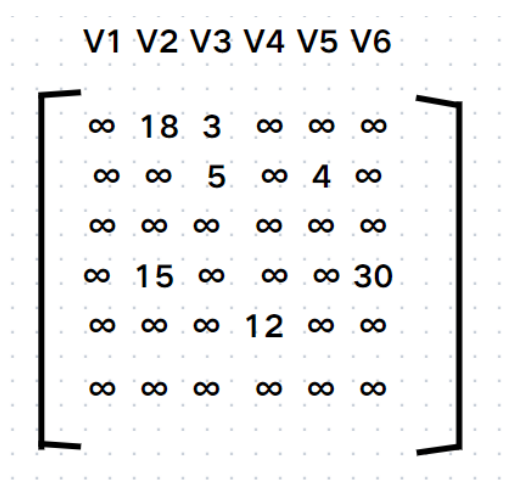
- A. v1-v2-v3-v4-v5-v6
- B. v1-v4-v2-v3-v5-v6
- C. v1-v2-v3-v5-v4-v6
- D. v1-v2-v5-v4-v3-v6
答案:C
解析:
该有向图如下:
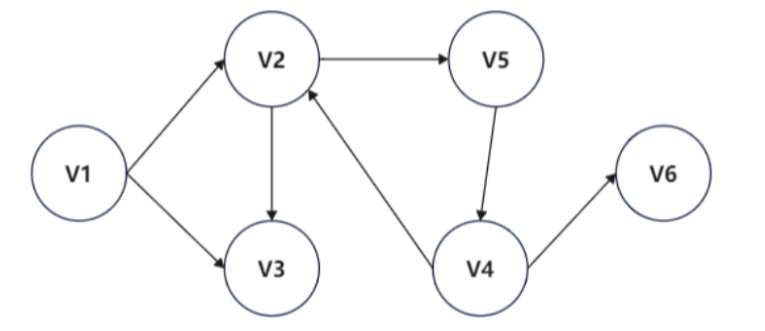
图的深度优先遍历(DFS)遍历: ①首先,选取图中某一顶点vi作为起始点访问; ②任意选取一个与vi邻接的顶点,且该顶点未被访问,一直重复下去,直到图中所有与vi连通的顶点都被访问到;【可概括为由起始顶点开始,沿着一条路径尽可能地深入搜索该图,直到无法再继续下去】 ③若还有顶点未被访问到,则另外选取一个未被访问的顶点再次作为起始点,回溯到上一个未访问的顶点,重复以上步骤,直至图中所有结点都被访问。 A选项属于层次遍历,不满足题目要求 B选项遍历V1之后应该遍历V2或V3,因此错误 D选项遍历V4之后,应先遍历V6,因此错误 答案因此选C。
单选题
97. 堆是一种数据结构, ( ) 是堆。
- A. (10,50,80,30,60,20,15,18)
- B. (10,18,15,20,50,80,30,60)
- C. (10,15,18,50,80,30,60,20)
- D. (10,30,60,20,15,18,50,80)
答案:B
解析:
堆排序中堆的定义:n个元素的序列{k1,k2,…,kn}当且仅当满足下列关系时,称为堆。
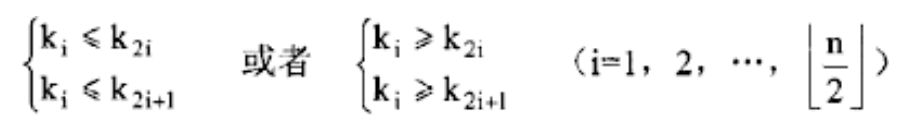 这里可以取i的值为“1,2,3,4”去检验哪些选项不满足上图公式。
单选题
98. 由权值为9,2,5,7的四个叶子结点构造一棵哈夫曼树,该树的带权路径长度为( ) 。
- A. 23
- B. 37
- C. 44
- D. 46
答案:C
解析:
根据哈夫曼算法,由权值为9,2,5,7的四个叶子结点构造的一棵哈夫曼树如下图所示。
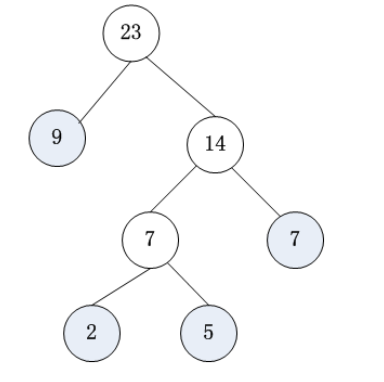
该树的带权路径长度为:9×1+2×3+5×3+7×2=44
单选题
99. 在最好和最坏情况下的时间复杂度均为O(nlogn)且稳定的排序方法是( ) 。
- A. 冒泡排序
- B. 快速排序
- C. 堆排序
- D. 归并排序
答案:D
解析:
基数排序最坏的时间复杂度均为O(d(n+rd));快速排序最好和最坏情况下F的时间复杂度分别为O(n2)和O(nlogn)且不稳定;堆排序在最好和最坏情况下的时间复杂度均为O(nlogn)但不稳定;归并排序是在最好和最坏情况下的时间复杂度均为O(nlogn)且稳定的排序方法。
单选题
100. 若排序前后关键字相同的两个元素相对位置不变,则称该排序方法是稳定的。 ( )排序是稳定的。
- A. 归并
- B. 快速
- C. 希尔
- D. 堆
答案:A
解析:
在快速排序、希尔排序和堆排序中,元素的移动不保证在相邻位置间进行,因此不能确保关键字相同的两个元素在排序前后的相对位置不变。在归并排序中,对于关键字相同的两个元素,排在前面的元素可确保先进入最终的有序序列,因此归并排序是稳定的。
单选题
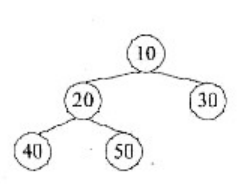
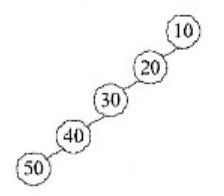
101. 用关键字序列10、20、30、40、50构造的二叉排序树(二叉查找树)为( )。
- A.
- B.
- C.
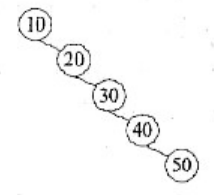
- D.
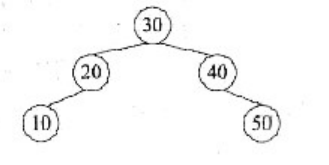
答案:C
解析:
根据关键字序列构造二叉排序树的基本过程是,若需插入的关键字大于树根,则插入到右子树上,若小于树根,则插入到左子树上,若为空树,则作为树根结点。
单选题
102. 已知一个有序表13,18,24,35,47,50,62,83,90,115,134,当二分查找值为90的元素是,查找成功的比较次数为( )。
- A. 1
- B. 2
- C. 4
- D. 6
答案:B
解析:
第一次查找范围为13,18...,115,134,取中间值50 第二次查找范围为62,83,90,114,134,取中间值90 因此一共比较2次
单选题
103. 若一个有向图具有拓扑排序序列,则该图的邻接矩阵必定为()矩阵。
- A. 对称
- B. 一般
- C. 三角
- D. 稀疏
答案:D
解析:
本题考查有向图拓扑排序相关知识。 矩阵的下三角或上三角部分包含非零元素,而其余部分为零。一般矩阵这个术语太过宽泛,不具体指向任何特定性质的矩阵。对称矩阵中元素关于主对角线对称,即矩阵中(i,j)和(j,i)位置上的元素相等。这通常用于无向图的邻接矩阵,因为有向图中边的方向性会导致矩阵不对称。具有拓扑排序序列的有向图通常表示一种“有向无环图”,在这种图中,不是所有顶点之间都有直接连接,因此其邻接矩阵是稀的。本题选择D选项。
单选题
104. 在平衡二叉树中,要求每个结点的左右子树高度差不超过1,那么高度为5的平衡二叉树最少有()个节点。
- A. 15
- B. 16
- C. 12
- D. 11
答案:C
解析:
本题考查二叉树相关知识。 为了使节点数最少,尽量使每个节点都只有一个子节点(尽量左子节点或右子节点为同时保证满足平衡二叉树的性质。本题选C
单选题
105. 采用栈将一个算术表达式的中缀形式转换为后缀形式,设暂存运算符的栈S初始时为空,将算术表达式"17+(45-57)/9"转换为后级式“17 45 5 7-9/+”的过程中,栈S中最多有( )个元素。
- A. 6
- B. 4
- C. 5
- D. 2
答案:B
解析:
本题考查数据结构-栈相关知识。 在后缀表达式中,如果遇到运算符就进行运算,再把结果存入栈中,由题目所给后缀式可知,后缀式中第一个运算符是它前面有3个元素,此时栈中元素最多,本题选择B选项。
单选题
106. 希望用最快的速度挑选出1000个无序元素中前10个最大的元素,则最好选择()排序算法
- A. 冒泡
- B. 基数
- C. 堆
- D. 快速
答案:C
解析:
本题考查常见排序算法相关知识。 冒泡排序:这种排序算法通过重复地遍历待排序元素列,依次比较相邻的两个元素,并根据需要交换它们的位置直至整个元素列有序。然而,冒泡排序的平均时间复杂度为0(n^2),在处理大数据集时效率较低,不适合。基数排序:基数排序是一种非比较型整数排序算法,其原理是将整数按位数切割成不同的数字,然后按每个位数分别比较。尽管基数排序在某些情况下效率很高,如处理大量数据且数据分布较为均匀时,但本题要求的是挑选前10个最大元素,而非对整个数据集进行完整排序。堆排序:堆排序利用堆这种数据结构进行排序。在挑选前10个最大元素的问题中,我们可以使用最大堆(大顶堆)。首先,将前10个元素构建成一个最大堆,然后遍历剩余的元素。对于每个新元素,如果它大于堆顶元素(即当前前10个元素中的最小者),则替换堆顶元素并重新调整堆。这样,在遍历完所有元素后,堆中的元素即为前10个最大元素,堆排序在处理此类部分排席问题时效率较高,时间复杂度约为0(n log k),其中n是元素总数,k是所需挑选的元素数量(本题中k=10)快速排序:快速排序是一种高效的排序算法,采用分治法的策略来将一个序列分为较小和较大的两个子席列,然后递归地排序两个子席列。虽然快速排序在平均情况下的时间复杂度为0(n log n),但在本题中,我们只需要前10个最大元素,而无需对整个数据集进行排序。因此,使用快速排序会造成不必要的计算开销。综上所述,本题选择C选项。
单选题
107. 要在O(nlgn)时间内,对数据进行稳定排序,则应选择()排序算法,
- A. 快速
- B. 归并
- C. 堆
- D. 直接插入
答案:B
解析:
归并排序是一种时间复杂度为O(nlogn)的排序算法。它采用分治策略,将数组分成较小的子数组进行排序,然后将已排序的子数组合并成一个有序的数组。归并排序是稳定的排序算法,因为它在合并过程中会保持相同元素的相对顺序不变。
单选题
108. 某二叉树如图所示,若进行顺序存储(即用一维数组元素存储该二叉树中的节点且通过下标反映节点间的关系,例如,对于下标为i的节点,其左孩子的下标为2i、右孩子的下标为2i+1),则该数组的大小至少为 ( ) ;若采用三叉链表存储该二叉树(各个节点包括节点的数据、父节点指针、左孩子指针、右孩子指针),则该链表的所有节点中空指针的数目为 ( ) 。 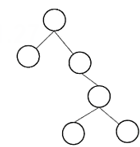
- A. 6
- B. 10
- C. 12
- D. 15
答案:D
解析:
采用顺序存储结构存储二叉树时,一般的二叉树也必须按照完全二叉树的形式存储,需要填上一些不存在的“虚节点”。题中二叉树的高度为4,需要的存储空间为2^4-1=15,如下:
可见,空指针的数目为8。
完形类单选题
109. 某二叉树如图所示,若进行顺序存储(即用一维数组元素存储该二叉树中的节点且通过下标反映节点间的关系,例如,对于下标为i的节点,其左孩子的下标为2i、右孩子的下标为2i+1),则该数组的大小至少为 ( ) ;若采用三叉链表存储该二叉树(各个节点包括节点的数据、父节点指针、左孩子指针、右孩子指针),则该链表的所有节点中空指针的数目为 ( ) 。
- A. 6
- B. 8
- C. 12
- D. 14
答案:B
解析:
采用顺序存储结构存储二叉树时,一般的二叉树也必须按照完全二叉树的形式存储,需要填上一些不存在的“虚节点”。题中二叉树的高度为4,需要的存储空间为2^4-1=15,如下:
可见,空指针的数目为8。
完形类单选题
110. 某个算法的时间复杂度递归式T(n)=T(n-1)+n,其中n为问题的规模,则该算法的渐进时间复杂度为 ( ) ,若问题的规模增加了16倍,则运行时间增加 ( ) 倍。
- A. O(n)
- B. O(nlgn)
- C. O(n2)
- D. O(n2lgn)
答案:C
解析:
对于递归式,假设T(1)=1,则: T(n)=T(n-1)+n =T(n-2)+n-1+n =T(n-3)+n-2+n-1+n =1+2+…+n-1+n =n(n+1)/2 可见,时间复杂度为O(n2)。若问题的规模增加了16倍,则运行时间增加了162=256倍。
完形类单选题
111. 某个算法的时间复杂度递归式T(n)=T(n-1)+n,其中n为问题的规模,则该算法的渐进时间复杂度为 ( ) ,若问题的规模增加了16倍,则运行时间增加 ( ) 倍。
- A. 16
- B. 64
- C. 256
- D. 1024
答案:C
解析:
对于递归式,假设T(1)=1,则: T(n)=T(n-1)+n =T(n-2)+n-1+n =T(n-3)+n-2+n-1+n =1+2+…+n-1+n =n(n+1)/2 可见,时间复杂度为O(n2)。若问题的规模增加了16倍,则运行时间增加了162=256倍。
完形类单选题
112. Prim算法和Kruscal算法都是无向连通网的最小生成树的算法,Prim算法从一个顶点开始,每次从剩余的顶点中加入一个顶点,该顶点与当前的生成树中的顶点的连边权重最小,直到得到一颗最小生成树;Kruscal算法从权重最小的边开始,每次从不在当前的生成树顶点中选择权重最小的边加入,直到得到一颗最小生成树,这两个算法都采用了 ( ) 设计策略,且 ( ) 。
- A. 分治
- B. 贪心
- C. 动态规划
- D. 回溯
答案:B
解析:
Prim算法和Kruscal算法都是基于贪心算法的应用。Prim算法的时间复杂度为O(n2),与图中边数无关,该算法适合于稠密图。Kruskal算法的时间复杂度只和边有关系,为O(elog2e),由于Kruskal算法只与边有关,因此适合求稀疏图的最小生成树。
完形类单选题
113. Prim算法和Kruscal算法都是无向连通网的最小生成树的算法,Prim算法从一个顶点开始,每次从剩余的顶点中加入一个顶点,该顶点与当前的生成树中的顶点的连边权重最小,直到得到一颗最小生成树;Kruscal算法从权重最小的边开始,每次从不在当前的生成树顶点中选择权重最小的边加入,直到得到一颗最小生成树,这两个算法都采用了 ( ) 设计策略,且 ( ) 。
- A. 若网较稠密,则Prim算法更好
- B. 两个算法得到的最小生成树是一样的
- C. Prim算法比Kruscal算法效率更高
- D. Kruscal算法比Prim算法效率更高
答案:A
解析:
Prim算法和Kruscal算法都是基于贪心算法的应用。Prim算法的时间复杂度为O(n2),与图中边数无关,该算法适合于稠密图。Kruskal算法的时间复杂度只和边有关系,为O(elog2e),由于Kruskal算法只与边有关,因此适合求稀疏图的最小生成树。
完形类单选题
114. 利用栈对算术表达式a*(b+c)-e求值,设栈初始时为空,则暂存操作数(或运算结果)的栈中最多需存放( )个操作数(或运算结果)。
- A. 3
- B. 1
- C. 2
- D. 4
答案:A
解析:
执行过程: 1.压入a,b,c(栈中有3个操作数); 2.计算b+c后,压入结果(栈剩a+结果); 3.计算a*(结果)后,压入最终值; 4.压入e并计算减法。 最大栈深度为3。
单选题
115. 在二维平面最近点对问题中,分治法的步骤不包括以下()。
- A. 计算所有点对的欧氏距离
- B. 递归求解左右两半中点集的最近点对问题
- C. 按x坐标排序并将点集划分为左右两半
- D. 合并时仅需检查距离中线8范围内的点
答案:A
解析:
分治法的核心步骤为:排序并划分点集(C)、递归求解子问题(B)、合并时检查中线附近有限范围内的点(D)。而选项A“计算所有点对的欧氏距离”是暴力解法的步骤,不属于分治法
单选题
116. 已知字符集为{a,b,c,d,e,f,g,h},若各字符的哈夫曼编码如下表所,则对编码序列010101100011001001001111的译码结果为()。 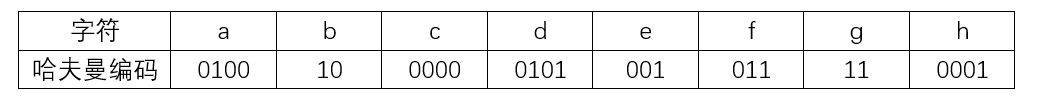
- A. daceabdg
- B. dabccabg
- C. dfhbabfg
- D. dfaecbfg
答案:C
解析(AI 生成):
哈夫曼编码是前缀码,译码时从左往右逐位读入,与码表比对,一旦完整匹配某个字符的编码就输出该字符并从下一位重新开始,不会产生歧义。按此规则切分 010101100011001001001111,依次得到 d、f、h、b、a、b、f、g,故选 C。
单选题
117. 对某有序表进行折半查找时,参与比较的关键字顺序不可能是()。
- A. 43,65,99,85,78
- B. 99,85,78,65,43
- C. 43,99,85,65,78
- D. 99,85,65,78,43
答案:D
解析:
本题答案选D。 折半查找每次将查找区间缩小一半,参与比较的关键字应该是逐渐逼近目标关键字的。在有序表中进行折半查找,每次比较的关键字应该是当前查找区间的中间元素。如果有序表是升序排列,每次比较的关键字应该是先中间元素,然后根据比较结果缩小查找区间,再取新的中间元素比较。 选项D中,65之后是78,再之后应该是比65大的数,不可能是43,不符合折半查找的比较顺序。
单选题
118. 设链队列Q用含头结点的循环单链表表示,且仅设尾指针rear,假设队列中有n个元素结点,则入队列和出队列运算的时间复杂度分别为()。
- A. O(1)、O(1)
- B. O(1)、O(n)
- C. O(n)、O(1)
- D. O(n)、O(n)
答案:A
解析:
入队列操作:因为链队列Q用含头结点的循环单链表表示且仅设尾指针rear,入队列时只需在尾指针rear之后插入新结点,然后更新尾指针,操作时间复杂度为O(1)。 出队列操作:可以通过尾指针rear找到头结点的下一个结点(即队头结点),删除该结点并更新头结点的指针,时间复杂度也为O(1)。
单选题
119. 某递归算法的时间复杂度计算公式为T(n)=4T (n/2)+nlgn,其中n为问题规模,则该算法的时间复杂度是( )。
- A. ⊙(nlgn)
- B. ⊙(n³)
- C. ⊙(n² )
- D. ⊙(n² lgn)
答案:C
解析:
递归式 T(n) = 4T(n/2) + nlgn 的时间复杂度可通过 主定理 分析:
- 主定理形式:对形如 T(n) = aT(n/b) + f(n) 的递归式,主定理通过比较 f(n) 与 n^(log_b a) 的阶来确定时间复杂度。
- 参数分析: a = 4,b = 2 → log_b a = log₂4 = 2,因此 n^(log_b a) = n²。 f(n) = nlgn,需与 n² 比较阶。
- 主定理情况判断:若 f(n) = O(n^{log_b a - ε})(存在 ε > 0),则 T(n) = Θ(n^{log_b a})。这里 nlgn 的阶低于 n²(因为 lgn 的增长速度远慢于 n),且存在 ε = 0.5 使得 nlgn = O(n^{2 - 0.5}) = O(n^{1.5})。因此满足情况1,时间复杂度为 Θ(n²)。
单选题
120. 以下问题中,肯定可以用贪心算法求得最优解的是( )。
- A. 旅行商问题(TSP)
- B. 最大公共子序列(LCS)
- C. 部分(分数)背包问题
- D. 0-1背包问题
答案:C
解析:
贪心算法适用场景需满足贪心选择性质与最优子结构: 部分(分数)背包问题(C):允许分割物品,贪心策略按单位价值排序选取,能保证全局最优。 旅行商问题(A):贪心选择最短边可能陷入局部最优,无法保证全局最短路径。 0-1背包问题(D):不可分割物品,贪心策略可能错过更高总价值的组合。 最大公共子序列(B):需动态规划递推求解,贪心无法处理重叠子问题
单选题
121. 对n阶上三角矩阵A按行压缩存储,将元素A (0≤i,j<n且i≤j)存储在B[k] (k≥1) 中,则k的值为()。
- A. -i /2+(n+1/2)i+j-n
- B. -i /2+(n+1/2)i+j-1
- C. -i /2+(n-1/2)i+j
- D. -i /2+(n-1/2)i+j+1
答案:D
解析:
代入法直接验证。 元素A[0][0],A[0][1]应是分别对应B[1],B[2]。 依次代入验证即可。
单选题
122. 对某有序顺序表进行折半查找(二分查找)时,进行比较的关键字序列不可能是()
- A. 42,61,90,85,77
- B. 42,90,85,61,77
- C. 90,85,61,77,42
- D. 90,85,77,61,42
答案:C
解析:
在有序表中进行折半查找时,各选项的比较序列合理性如下:
- 选项A:先与42比较,因61>42在右半部分,90>61在右半部分,85<90在左半部分,77<85在左半部分,比较序列合理。
- 选项B:先与42比较,90>42在右半部分,85<90在左半部分,61<85在左半部分,77>61,比较序列合理。
- 选项C:若以90为起始比较元素,按折半查找逻辑后续应找小于90的元素,此选项先85后61再77最后42的序列不符合逻辑,本题选C。
- 选项D:以90为起始,85<90,77<85,61<77,42<61,比较序列合理。
单选题
123. 算数表达式a*(b+c/d)-e的后缀式为( )。
- A. a b c d/+*e-
- B. a b c de*+/-
- C. a*b+c/d-e
- D. ab*cd/+e-
答案:A
解析:
原始表达式经过按运算符优先级括起算术单元后变为:((a*(b+(c/d)))-e)。
将其转换为后缀表达式时,把操作符号移到相应括号之后,得到:((a(b(cd)/)+)e)- ,除去括号后最终的后缀表达式为:abcd/+e- 。 本题选A。
单选题
124. 根据渐进分析,表达式序列:n4, lgn, 2n, 1000n, n2/3, n!从低到高排序为( )。
- A. Ign,1000n, n2/3, n4, n!, 2n
- B. n2/3,1000n, lgn, n4, n!, 2n
- C. lgn,1000n, n2/3, 2n, n4, n!
- D. Ign, n2/3, 1000n, n4, 2n, n!
答案:D
解析:
从选项分析,1000n的渐进表示为O(n)。因为lgn的增长规模小于1000n,所以B选项错误。又因为n的2/3次方(n2/3)的增长规模小于n,所以D选项正确。
单选题
125. 对n个基本有序的整数进行排序,若采用插入排序算法,则时间和空间复杂度分别为( )(作答此空);若采用快速排序算法,则时间和空间复杂度分别为。
- A. O(n^2)和O(n)
- B. O(nlgn)和O(n)
- C. O(n^2)和O(1)
- D. O(nlgn)和O(1)
答案:C
解析:
本题考查算法分析的基础知识。排序和查找是基本的计算问题。存在很多相关的算法,不同的算法适用于不同的场合。不同的数据输入特点相同的算法也有不同的计算时间。若数据基本有序,对插入排序算法而言,则可以在近似线性时间内完成排序。即 O(n);而对于快速排序而言,则是其最坏情况,需要二次时间才能完成排序,即O(n2)。两个算法在排序时仅需要一个额外的存储空间,即空间复杂度为常数O(1)。(这里比较特殊,基本有序的情况下,快速排序因为不需要做交换处理,所以不需要存储额外数据,每一轮记录一次基准数值,空间复杂度只需要O(1)。) 本题选C。
单选题
126. 以下关于折半查找的叙述中,不正确的是 ( )。采用折半查找等概率查找某个包含8个元素的有序表,查找成功的平均查找长度为(作答此空)。
- A. 9/8
- B. 1/8
- C. 20/8
- D. 21/8
答案:D
解析:
本题求具体的查找成功的平均查找长度需要把每个元素的查找路径的查找次数一一列举出来最后除以8求平均值: ①找1号元素:4→2→1,3次; ②找2号元素:4→2,2次; ③找3号元素:4→2→3,3次; ④找4号元素:4,1次; ⑤找5号元素:4→6→5,3次; ⑥找6号元素:4→6,2次; ⑦找7号元素:4→6→7,3次; ⑧找8号元素:4→6→7→8,4次; 查找总次数:3+2+3+1+3+2+3+4=21,平均查找长度=21/8。 综上所述,本题选D。
单选题
127. 以下的算法设计方法中,( )以获取问题最优解为目标。
- A. 回溯方法
- B. 分治法
- C. 动态规划
- D. 递推
答案:C
解析:
本题考查算法基础知识。 回溯法的实质是在包含问题的所有解的解空间树中,按照深度优先的策略,从根节点出发搜索解空间树。若进入某子节点的子树后没有找到解(或者需要找出全部解),则需要从子节点回退(回溯)至父节点,从而可以选择其他子节点进行搜索。回溯法有“通用的解题法”之称,用它可以系统地搜索一个问题的所有解或任一解。 分治与递归就像一对孪生兄弟,经常同时应用于算法设计中。分治的思路是将一个难以直接解决的大问题分成一些规模较小的相同问题,以便各个击破,分而治之。如果规模为n的问题可分解成k个子问题,1<k≤n,这些子问题互相独立且与原问题相同。 动态规划算法与分治法类似,其基本思想也是将待求解问题分解成若干个子问题,先求解子问题,然后从这些子问题的解得到原问题的解。与分治法不同的是,适合于用动态规划法求解的问题,经分解得到的子问题往往不是独立的。若用分治法来解这类问题,则相同的子问题会被求解多次,以至于最后解决原问题需要耗费指数级时间。动态规划算法通常用于求解具有某种最优性质的问题。在这类问题中,可能会有许多可行解,每个解都对应于一个值,我们希望找到具有最优值(最大值或最小值)的那个解。 本题选C。
单选题
128. ( )不能保证求得0-1背包问题的最优解。
- A. 分支限界法
- B. 贪心算法
- C. 回溯法
- D. 动态规划策略
答案:B
解析:
分支限界法一般以广度优先或以最小耗费(最大效益)优先的方式搜索问题的解空间,那么肯定能找出最优解。 贪心算法的思想是:总是做出在当前来说是最好的选择,而并不从整体上加以考虑,它所做的每步选择只是当前步骤的局部最优选择,但从整体来说不一定是最优的选择。所以用该算法并不能保证求得0-1背包问题的最优解。 回溯法的思想是:按选优条件向前搜索,以达到目标。但当搜索到某一步时,发现原先选择并不优或达不到目标,就退回一步重新选择。它其实是遍历了整个解空间,所以肯定能找到最优解。 动态规划法的思想是:在求解问题中,对于每一步决策,列出各种可能的局部解,再依据某种判定条件,舍弃那些肯定不能得到最优解的局部解,在每一步都经过筛选,以每一步都是最优解来保证全局是最优解。它能求得0-1背包问题的最优解。 本题选B。
单选题
129. 在分支-限界算法设计策略中,通常采用( )搜索问题的解空间。
- A. 深度优先
- B. 广度优先
- C. 自底向上
- D. 拓扑序列
答案:B
解析:
分支-限界算法通过广度优先或最小耗费优先的方式搜索解空间树,目标是找到满足约束条件的最优解。具体实现中,算法维护一个活结点表(如队列或优先队列),按先进先出(FIFO)或优先级顺序扩展节点。 本题选B。
单选题
130. 某算法的时间复杂度表达式为T(n)=an2+bnlgn+cn+d,其中,n为问题的规模,a、b、c和d为常数,用O表示其渐近时间复杂度为( )。
- A. O(n^2)
- B. O(n)
- C. O(nlgn)
- D. O(1)
答案:A
解析:
本题考查算法分析的基础知识。 在算法分析中,符号O用于表示算法运行时间的上限。从定义上说,对一个函g(n),O(g(n))表示函数集合: {f(n):存在正常数c和n0,使得对所有的n≥n0,有0≤f(n)≤cg(n)} 根据上述定义,可以知道表达式T(n)=an2+bnlgn+cn+d在函数集合O(n2)中。对此问题,简单的做法是忽略n的低阶项和最高阶项n2的常系数,故答案应为O(n2)。 本题选A。
单选题
131. 下面函数中渐进时间最小的是( )。
- A. T1(n)=n+nlogn
- B. T2(n)=2n+nlogn
- C. T3(n)=n2-logn
- D. T4(n)=n+100logn
答案:D
解析:
一般情况下,算法中基本操作重复执行的次数是问题规模n的某个函数f(n),算法的时间量度记作
T(n)=O(f(n))

它表示随问题规模n的增大,算法执行的时间的增长率和f(n)的增长率相同,称作算法的渐进时间复杂度。当n→∞时,常见的渐进复杂度大小为

O(1)≤O(n)≤O(nlogn)≤O(n2)
本题选D。
单选题
132. 若一个问题既可以用迭代方式也可以用递归方式求解,则( )方法具有更高的时空效率。
- A. 迭代
- B. 递归
- C. 先递归后迭代
- D. 先迭代后递归
答案:A
解析:
本题考查迭代和递归算法。 递归是设计和描述算法的一种有力的工具。 能采用递归描述的算法通常有这样的特征:为求解规模为N的问题,设法将它分解成一些规模较小的问题,然后从这些小问题的解方便地构造出大问题的解,并且这些规模较小的问题也能采用同样的分解和综合方法,分解成规模更小的问题,并从这些更小问题的解构造出规模稍大问题的解。特别地,当规模N=1时,能直接得到解。 由于递归函数执行过程中引起一系列的函数调用和返回,因此需要较多的时间开销(控制转移和存储空间管理操作所需的时间)及空间开销(每一次调用时为函数中的形式参数和自动局部变量分配存储空间等),因此与实现相同功能的非递归函数相比,运行效率较低。
单选题
133. 利用动态规划方法求解每对结点之间的最短路径问题(all pairs shortest path problem)时,设有向图G=<V,E>,则()。
- A. D^k(i,j)=D^(k-1)(i,j)+C(i,j)
- B. D^k(i,j)=min{D^(k-1)(i,j),D^(k-1)(i,j)+C(i,j)}
- C. D^k (i,j)=D^(k-1)(i,k)+D^(k-1)(k,j)
- D. D^k(i,j)=min{D^(k-1)(i,j),D^(k-1)(i,k)+D^(k-1)(k,j)}
答案:D
解析:
设pk(i,j)表示从i到j并且不经过编号比k还大的结点的最短路径,那么pk(i,j)有以下两种可能:
①pk(i,j)经过编号为k的结点,此时pk(i,j)可以分为从i到k和从k到j的两段,易知pk(i,j)的长度为Dk-1(i,k)+Dk-1(k,j)。

②pk(i,j)不经过编号为k的结点,此时pk(i,j)的长度为Dk-1(i,j)。
因此,求解该问题的递推关系式为:Dk(i,j)=min{Dk-1(i,j),Dk-1(i,k)+Dk-1(k,j)}。 本题选D。
单选题
134. 迪杰斯特拉(Dijkstra)算法按照路径长度递增的方式求解单源点最短路径问题,该算法运用了( )算法策略。
- A. 贪心
- B. 分而治之
- C. 动态规划
- D. 试探+回溯
答案:A
解析:
本题考查最短路径问题。 贪心算法通过一系列的选择得到问题的解。它所做出的每一次选择是当前状态下局部最优选择,即贪心选择。 分治法的基本思想是把大问题分解成一些较小的问题,然后由小问题的解方便地构造出大问题的解。 动态规划策略设计算法利用问题的最优子结构性质,以自底向上的方式递归地从子问题的最优解逐步构造出整个问题的最优解。 回溯法也称为试探法,该方法首先暂时放弃关于问题规模大小的限制,并将问题的候选解按某种顺序逐一枚举和检验。 迪杰斯特拉(Dijkstra)提出的按路径长度递增的次序产生最短路径的算法,其思想是把网中所有的顶点分成两个集合S和T、 S集合的初态只包含顶点v0,T集合的初态为网中除v0之外的所有顶点。凡以v0为源点,己经确定了最短路径的终点并入S集合中;顶点集合T则是尚未确定最短路径的顶点的集合。按各顶点与v0间最短路径长度递增的次序,逐个把T集合中的顶点加入到S集合中去,使得从v0到S集合中各顶点的路径长度始终不大于从v0到T集合中各顶点的路径长度。 从迪杰斯特拉算法求最短路径的过程可知,其算法策略属于贪心策略,本题选A。
单选题
135. 对于哈希表,如果将装填因子α定义为表中装入的记录数与表的长度之比,那么向表中加入新记录时,( )。
- A. α的值随冲突次数的增加而递减
- B. α越大发生冲突的可能性就越大
- C. α等于1时不会再发生冲突
- D. α低于0.5时不会发生冲突
答案:B
解析:
本题考查数据结构基础知识。 装填因子α表示了哈希表的装满程度,显然,α越大发生冲突的可能性就越大,本题选B。
单选题
136. 在()存储结构中,数据结构中元素的存储地址与其关键字之间存在某种映射关系。
- A. 顺序(Sequence)
- B. 链表(Link)
- C. 索引(Index)
- D. 散列(Hash)
答案:D
解析:
本题考查数据的基本存储结构。 顺序存储指逻辑上相邻的元素其存储位置也相邻。链表存储结构中,通过结点中的指针映射元素之间的逻辑关系。索引存储是指在元素的存储结构之上另外建立一个元素与其存储位置之间的索引表。散列存储结构中,元素的存储位置与其关键字之间有某种映射关系,本题选D。
单选题
137. 一个算法是对某类给定问题求解过程的精确描述,算法中描述的操作都可以通过将已经实现的基本操作执行有限次来实现,这句话说明算法具有() 特性。
- A. 有穷性
- B. 可行性
- C. 确定性
- D. 健壮性
答案:B
解析:
本题考查算法基本概念。 一个算法是对某类给定问题求解过程的精确描述,算法有5个基本特性:有穷性、确定性、可行性、有输入和输出。其中,有穷性是指对于任意一组合法输入值,在执行有穷步骤之后一定能结束,即算法中的每个步骤都能在有限时间内完成。确定性是指对于每种情况下所应执行的操作,在算法中都有确切的规定,使算法的执行者或阅读者都能明确其含义及如何执行,并且在任何条件下,算法都只有一条执行路径。可行性是指算法中的所有操作都必须足够基本,都可以通过己经实现的基本操作运算有限次实现之。题目中的描述说明的是算法的可行性,本题选B。
单选题
138. 关于算法与数据结构的关系,( )是正确的。
- A. 算法的实现依赖于数据结构的设计
- B. 算法的效率与数据结构无关
- C. 数据结构越复杂,算法的效率越高
- D. 数据结构越简单,算法的效率越高
答案:A
解析:
本题考查数据结构与算法的关系。 算法(Algorithn)是对特定问题求解步骤的一种描述,它是指令的有限序列,其中每一条指令表示一个或多个操作。 一个算法具有5个重要特性:有穷性、确定性、可行性、输入和输出。 数据结构讨论“描述现实世界实体的数学模型(非数值计算)及其上的操作在计算机中如何表示和实现”,包括数据的逻辑结构、物理结构和基本运算。 设计算法步骤时可以不考虑数据结构,但算法在计算机上与采用的数据结构密切相关,本题选A。
单选题
139. 现需要对一个基本有序的数组进行排序。此时最适宜采用的算法为( )排算法,时间复杂度为(作答此空 )。
- A. O(n)
- B. O(nlgn)
- C. O(n^2)
- D. O(n^2lgn)
答案:A
解析:
本题考查基本算法的时间复杂度分析,要求考生对典型的算法能熟练掌握。 插入排序在输入数据基本有序的情况下,是其计算时间的最好情况,复杂度为O(n),其他情况下时间复杂度为O(n2)。快速排序在输入数据有序或者逆序的情况下,是其计算时间的最坏情况,复杂度为O(n2),其他情况下时间复杂度为O(nlgn)。而归并排序和堆排序算法在所有情况下的时间复杂度均为O(nlgn),本题选A。
单选题
140. 对数组A=(2,8,7,1,3,5,6,4)用快速排序算法的划分方法进行一趟划分后得到的数组A为( )(非递减排序,以最后一个元素为基准元素)。进行一趟划分的计算时间为( 作答此空)。
- A. O(1)
- B. O(lgn)
- C. O(n)
- D. O(nlgn)
答案:C
解析:
因为一趟划分的过程会与整个序列n个元素进行比较,因此一趟划分的时间复杂度为O(n),第二空选择C选项。
单选题
141. 归并排序算法在排序过程中,将待排序数组分为两个大小相同的子数组,分别对两个子数组采用归并排序算法进行排序,排好序的两个子数组采用时间复杂度为O(n)的过程合并为一个大数组。根据上述描述,归并排序算法采用了(作答此空)算法设计策略。归并排序算法的最好和最坏情况下的时间复杂度为( )。
- A. 分治
- B. 动态规划
- C. 贪心
- D. 回溯
答案:A
解析:
本题考查归并排序相关算法。 归并排序(Merge Sort)是建立在归并操作上的一种有效,稳定的排序算法,该算法是采用分治法(Divide and Conquer)的一个非常典型的应用。将已有序的子序列合并,得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为二路归并。归并排序是运用分治法相关策略,其时间复杂度是由外层的n循环,与内层的归并过程log2n结合起来得到Θ(nlgn),所以答案选A。
单选题
142. 以关键字比较为基础的排序算法在最坏情况下的计算时间下界为O(nlogn)。下面的排序算法中,在最坏的情况下,计算时间可以达到O(nlogn)的是 ( ) ;该算法采用的设计方法是 ( ) 。
- A. 分治法(问题2)
- B. 贪心法(问题2)
- C. 动态规划方法(问题2)
- D. 回溯法(问题2)
答案:A
解析:
直接插入排序、简单选择排序和冒泡排序最坏情况下计算时间可以达到O(n^2),而归并排序的时间最坏情况下可以达到O(nlogn)。而归并排序也是分治策略的一个典型应用,本题选A。
单选题
143. ()在其最好情况下的算法时间复杂度为O(n)。
- A. 插入排序
- B. 归并排序
- C. 快速排序
- D. 堆排序
答案:A
解析:
本题考查的是排序算法的时间复杂度。 无论原始序列中的元素如何排列,归并排序和堆排序算法的时间复杂度都是O(n1gn)。快速排序算法处理的最好情况指每次都是将待排序列划分为均匀的两部分,此时算法时间复杂度是O(n1gn),在原始序列已经有序(升序或降序)的情况下,快速排序的时间复杂度反而为O(n^2)。而插入排序是将一个新元素插入已经排列好的序列中,显然,在输入数据已经是升序的情况下,新元素只需插入到序列尾部,这就是插入排序的最好情况,此时计算时间为O(n) ,本题选A。
单选题
144. 给定n个整数构成的数组A={a1,a2,…,an}和整数x,判断A中是否存在两个元素ai和aj,使得ai+aj=x。为了求解该问题,首先用归并排序算法对数组A进行从小到大排序;然后判断是否存在ai+aj=x,具体如下列伪代码所示,则求解该问题时排序算法应用了( )算法设计策略,整个算法的时间复杂度为( ) i=1; j=n while i<j if ai+aj=x return true else if ai+aj>x j- -; else i++; return false;
- A. O(n)
- B. O(nlgn)
- C. O(n^2)
- D. O(lgn)
答案:B
解析:
分治算法的基本思想是将一个规模为N的问题分解为K个规模较小的子问题,这些子问题相互独立且与原问题性质相同。求出子问题的解,就可得到原问题的解,本题选B。
单选题
145. 对于具有n个元素的一个数据序列,若只需得到其中第k个元素之前的部分排序,最好采用(),使用分治(Divide and Conquer)策略的是(作答此空)算法。
- A. 冒泡排序
- B. 插入排序
- C. 快速排序
- D. 堆排序
答案:C
解析:
本题考查排序算法及特点。 对于希尔排序、直接插入排序,只有在排序过程后才能确保全部序列以及前k个元素的最终排列,快速排序采用分治算法,常用递归算法实现,该算法根据枢轴元素进行划分,第一趟划分结束后得到了两个子序列,一个序列中的元素均不大于另一个子序列中的元素,枢轴元素介于这两个子序列之间。若仅需得到最终序列的前k个元素,每次得到枢轴元素位置后再考虑下一步的排序过程,在算法的流程控制上比较复杂。对于只需得到最终序列的前k个元素,堆排序比较简单。本题选C。
单选题
146. 对 n 个元素的数组进行(),其平均时间复杂度和最坏情况下的时间复杂度都是O(nlogn)。
- A. 希尔排序
- B. 快速排序
- C. 堆排序
- D. 选择排序
答案:C
解析:
本题考查排序算法。 希尔排序的时间复杂度约为O(n14)。 快速排序在最坏情况下的时间复杂度为O(n2)。 选择排序的时间复杂度为O(n2)。 无论在什么情况下,堆排序的时间复杂度都是O(nlogn)。 本题选C。
单选题
147. 将两个长度为 n 的递增有序表归并成一个长度为 2n 的递增有序表,最少需要进行关键字比较( )次。
- A. I
- B. n-1
- C. n
- D. 2n
答案:C
解析:
当其中一个表的所有元素均小于另一个表的所有元素时(例如表 A 的最后一个元素小于表 B 的第一个元素),归并时只需依次比较两个表的当前首元素,共进行 n 次比较即可完成归并。此时无需进一步比较剩余元素,直接追加即可。本题选C。
单选题
148. 以下关于快速排序算法的描述中,错误的是( )。在快速排序过程中,需要设立基准元素并划分序列来进行排序。若序列由元素{12,25,30,45,52,67,85}构成,则初始排列为(/) 时,排序效率最高(令序列的第一个元素为基准元素)。
- A. 快速排序算法是不稳定的排序算法
- B. 快速排序算法在最坏情况下的时间复杂度为O(nlgn)
- C. 快速排序算法是一种分治算法
- D. 当输入数据基本有序时,快速排序算法具有最坏情况下的时间复杂度
答案:B
解析:
快速排序算法是一种经典的排序算法,其基本思想是选择一个基准元素(通常选择第一个元素或者最后一个元素),通过一趟排序将待排序序列分成两部分,一部分比基准元素小,一部分大于等于基准元素,此时基准元素在其排好序后的正确位置;然后再递归地排序划分的两部分,因此本质上快速排序是一种分治算法。 由于在排序的过程中,各元素与基准元素比较大小,若小于基准元素则与基准元素交换位置,因此该算法是不稳定的排序算法。 当每一趟排序进行后,选择的基准元素恰好最大或者最小时,就把序列分成极端不均衡的两部分,即一部分为空,另一部分为待排序序列的元素个数减1,此时算法处于最坏情况,其时间复杂度为O(n2)。 当输入数据基本有序或者所有元素值相等时,不论选择第一个元素还是最后一个元素作为基准元素,都恰好把序列分成极端不均衡的两部分,快速排序算法具有最坏情况下的时间复杂度。 本题选B。
单选题
149. 对n个元素的有序表A[1..n]进行二分(折半)查找(除2取商时向下取整),查找元素A[i] 时,最多与A中的( )个元素进行比较。
- A. n
- B. [log₂n]-1
- C. n/2
- D. [log₂n]+1
答案:D
解析:
比较次数上限:二分查找的判定树高度为 [log₂n] + 1,因此最坏情况下需比较 [log₂n] + 1 次。本题选D。
单选题
150. 以下关于哈希(Hash,散列)查找叙述中,正确的是( )。
- A. 哈希函数应尽可能复杂些,以消除冲突
- B. 构造哈希函数时应尽量使关键字的所有组成部分都能起作用
- C. 进行哈希查找时,不再需要与查找表中的元素进行比较
- D. 在哈希表中只能添加元素不能删除元素
答案:B
解析:
哈希表根据设定的哈希函数H(key)和所选中的处理冲突的方法,将一组关键字映象到一个有限的、地址连续的地址集(区间)上并以关键字在地址集中的“象”作为相应记录在表中的存储位置。所以在构造哈希函数使应尽量使关键字的所有组成部分起作用。本题选B。
单选题
151. 折半查找在有序数组A中查找特定的记录K:通过比较K和数组中的中间元素A[mid]进行,如果相等,则算法结束;如果K小于A[mid],则对数组的前半部分进行折半查找;否则对数组的后半部分进行折半查找。根据上述描述,折半查找算法采用了( )算法设计策略。对有序数组(3,14,27,39,42,55,70,85,93,98),成功查找和失败查找所需要的平均比较次数分别是(作答此空)(假设查找每个元素的概率是相同的)
- A. 29/10和29/11
- B. 30/10和30/11
- C. 29/10和39/11
- D. 30/10和40/11
答案:C
解析:
折半查找成功的过程,可以理解为对这10个元素分别查找成功。 对各个元素进行编号依次为1、2、3、......、10,此时: (1)1次查找成功的元素是(1+10)/2=5号元素,也就是42; (2)2次查找成功的元素可能是(1+4)/2=2或者(6+10)/2=8,也就是2号位置14,或者8号位置85; (3)3次查找成功的元素可能是1号元素、3号元素27、6号元素55或者9号元素93; (4)4次查找成功的元素可能是4号元素39、7号元素70或者10号元素98。 此时平均查找次数为(1+22+43+34)/10=29/10。 折半查找失败的过程,可以理解为对处于这10个元素之前的间隔位置的数进行了查找,对各个元素间隔进行编号依次为1、2、3、......、11,此时: (1)1号间隔位于3的左侧,此时需要分别与元素42、14、3比较后才会查找失败,比较次数为3; (2)2号位置位于3和14之间,此时需要分别与元素42、14、3比较后才会查找失败,比较次数为3; (3)3号位置位于14和27之间,此时需要分别与元素42、14、27比较后才会查找失败,比较次数为3; (4)4号位置位于27和39之间,此时需要分别与元素42、14、27、39比较后才会查找失败,比较次数为4; (5)5号位置位于39和42之间,此时需要分别与元素42、14、27、39比较后才会查找失败,比较次数为4; (6)6号位置位于42和55之间,此时需要分别与元素42、85、55比较后才会查找失败,比较次数为3; (7)7号位置位于55和77之间,此时需要分别与元素42、85、55、77比较后才会查找失败,比较次数为4; (8)8号位置位于77和85之间,此时需要分别与元素42、85、55、77比较后才会查找失败,比较次数为4; (9)9号位置位于85和93之间,此时需要分别与元素42、85、93比较后才会查找失败,比较次数为3; (10)10号位置位于93和98之间,此时需要分别与元素42、85、93、98比较后才会查找失败,比较次数为4; (11)11号位置位于98右侧,此时需要分别与元素42、85、93、98比较后才会查找失败,比较次数为4; 此时平均查找次数为(35+4*6)/11=39/11。 把成功查找出所有元素的比较次数加起来是29,然后除10,就是29/10。 找出11个中间数,进行失败查询。先把总的比较次数加起来是39,然后除11,就是39/11。 因此第二问选择C选项。
单选题
152. 类比二分搜索算法,设计k分搜索算法(k为大于2的整数)如下:首先检查n/k处(n为被搜索集合的元素个数)的元素是否等于要搜索的值,然后检查2n/k处的元素,…,这样,或者找到要搜索的元素,或者把集合缩小到原来的1/k;如果未找到要搜索的元素,则继续在得到的集合上进行k分搜索;如此进行,直到找到要搜索的元素或搜索失败。此k分搜索算法在最坏情况下搜索成功的时间复杂度为( ),在最好情况下搜索失败的时间复杂度为(作答此空)。
- A. O(logn)
- B. O(nlogn)
- C. O(logkn)
- D. O(nlogkn)
答案:C
解析:
k分搜索算法在最坏情况下搜索成功的时间复杂度为O(logk n),在最好情况下搜索失败的时间复杂度为O(logk n)。本题选C。
单选题
153. 设顺序存储的某线性表共有123个元素,按分块查找的要求等分为3块。若对索引表采用顺序查找方法来确定子块,且在确定的子块中也采用顺序查找方法,则在等概率的情况下,分块查找成功的平均查找长度为( )。
- A. 21
- B. 23
- C. 41
- D. 62
答案:B
解析:
分块查找的索引表采用顺序查找,块数为3,平均查找长度为 (3+1)/2 = 2。 每块含 123/3 = 41个元素,块内顺序查找的平均长度为 (41+1)/2 = 21。 总平均查找长度为 2 + 21 = 23,对应选项B。
单选题
154. 某一维数组中依次存放了数据元素12,23,30,38,41,52,54,76,85,在用折半(二分)查找方法(向上取整)查找元素54时,所经历“比较”运算的数据元素依次为()。
- A. 41, 52, 54
- B. 41, 76, 54
- C. 41, 76, 52, 54
- D. 41, 30, 76, 54
答案:B
解析:
本题考查数据结构基础知识。 设查找表的元素存储在一维数组r[1..n]二中,那么在表中的元素己经按关键字递增(或递减)的方式排序的情况下,进行折半查找的方法是:首先将待查元素的关键字(key)值与表r中间位置上(下标为mid )的记录的关键字进行比较,若相等,则查找成功。若key>r[mid].key,则说明待查记录只可能在后半个子表r[mid+1..n]中,下一步应在后半个子表中再进行折半查找;若key<r[mid].key,说明待查记录只可能在前半个子表r[ 1.mid-1」中,下一步应在r的前半个子表中进行折半查找,这样通过逐步缩小范围,直到查找成功或子表为空时失败为止。 在题中,以中间元素41为界将数组元素分为12, 23, 30, 38和52, 54,76, 85两部分,显然54在后半部分,该部分的中间元素为54(向下取整)或76(向上取整),在52,54构成的子查找表中,向上取整的中间元素为54,因此查找元素54所经历“比较”运算的数据元素依次为41,76,54。本题选B。
单选题
155. 在字符串的模式匹配过程中,如果模式串的每个字符依次和主串中一个连续的字符序列相等,则称为匹配成功。如果不能在主串中找到与模式串相同的子串,则称为匹配失败。在布鲁特-福斯模式匹配算法(朴素的或基本的模式匹配)中,若主串和模式串的长度分别为n和m(且n远大于m),且恰好在主串末尾的m个字符处匹配成功,则在上述的模式匹配过程中,字符的比较次数最多为()。
- A. n*m
- B. (n-m+1)*m
- C. (n-m-1)*m
- D. (n-m)*n
答案:B
解析:
朴素的模式匹配也称为“布鲁特-福斯算法”,其基本思想:从主串的第1个字符起与模式串的第1个字符进行比较,若相等,则继续逐字符进行后续比较,否则从主串第2个字符开始,直至模式串中每个字符依次和主串中一个连续的字符序列相等为止,此时称匹配成功。如果不能在主串中找到与模式串相同的子串,则匹配失败。
    若主串和模式串的长度分别为n和m(且n远大于m),且恰好在主串末尾的m个字符处匹配成功,则依据上述模式匹配的基本思想,该匹配过程中字符的比较次数最多为(n-m+1)*m。
     本题选B。
单选题
156. 邻接矩阵和邻接表是图(网)的两种基本存储结构,对于具有n个顶点、e条边的图,以下结论正确的是( )。
- A. 进行深度优先遍历运算所消耗的时间与采用哪一种存储结构无关
- B. 进行广度优先遍历运算所消耗的时间与采用哪一种存储结构无关
- C. 采用邻接表表示图时,查找所有顶点的邻接顶点的时间复杂度为O(n*e)
- D. 采用邻接矩阵表示图时,查找所有顶点的邻接顶点的时间复杂度为O (n^2)
答案:D
解析:
邻接矩阵的时间复杂度 查找所有顶点的邻接顶点的时间复杂度为 O(n²) 。邻接矩阵通过n×n的矩阵存储边信息,遍历所有顶点的邻接点需检查n²个元素 。 邻接表的时间复杂度 查找所有顶点的邻接顶点的时间复杂度为 O(n+e) 。邻接表通过链表存储边信息,遍历所有顶点的邻接点需遍历n个顶点表和e条边 。 遍历算法与存储结构的关系 深度优先遍历(DFS)和广度优先遍历(BFS)的时间复杂度与存储结构无关,主要取决于边数e 。 存储效率 稀疏图(e远小于n²)适合邻接表,节省空间;稠密图(e接近n²)适合邻接矩阵,便于快速判断边存在性 。 本题选D。
单选题
157. 某货车运输公司有一个中央仓库和n个运输目的地,每天要从中央仓库将货物运输到所有的运输目的地,到达每个运输目的地一次且仅一次,最后回到中央仓库。在两个地点i和j之间运输货物存在费用cij。为求解旅行费用总和最小的运输路径,设计如下算法:首先选择离中央仓库最近的运输目的地1,然后选择离运输目的地1最近的运输目的地2,……,每次在未访问过的运输目的地中选择离当前运输目的地最近的运输目的地,最后回到中央仓库。则该算法采用了( )算法设计策略,其时间复杂度为( )。
- A. 分治
- B. 动态规划
- C. 贪心
- D. 回溯
答案:C
解析:
由于每次选择下一个要访问的城市时都是基于与当前最近的城市来进行,是一种贪心的选择策略,因此采用的是贪心策略。本题选C。
单选题
158. 无向图中一个顶点的度是指图中与该顶点相邻接的顶点数。若无向图G中的顶点数为n,边数为e,则所有顶点的度数之和为( )。
- A. n*e
- B. n e
- C. 2n
- D. 2e
答案:D
解析:
在无向图中,一条边连接两个顶点,即如果存在一条边,那么与这条边相关的两个顶点的度都为加1,那么总的度就应该加2,因此,如果图中有n条边,那么所有顶点的度数之和就应该为2e。本题选D。
单选题
159. 在一个有向图G的拓扑序列中,顶点Vi排列在Vj之前,说明图G中( )。
- A. 一定存在弧
- B. 一定存在弧
- C. 可能存在vi到vj的路径,而不可能存在vj到vi的路径
- D. 可能存在vj到vi的路径,而不可能存在vi到vj的路径
答案:C
解析:
拓扑序列是拓扑排序的产出物。对一个有向无环图G进行拓扑排序,是将G中所有顶点排成一个线性序列,使得图中任意一对顶点u和v,若边(u,v)∈E(G),则u在线性序列中出现在v之前。由此可见,如果Vi排列在Vj之前,说明可能存在vi到vj的路径,而不可能存在vj到vi的路径。本题选C。
单选题
160. 从存储空间的利用率角度来看,以下关于数据结构中图的存储的叙述,正确的是( )。
- A. 有向图适合采用邻接矩阵存储,无向图适合采用邻接表存储
- B. 无向图适合采用邻接矩阵存储,有向图适合采用邻接表存储
- C. 完全图适合采用邻接矩阵存储
- D. 完全图适合采用邻接表存储
答案:C
解析:
本题主要考查图的存储结构,常见的图的存储结构有邻接矩阵存储和邻接表存储,其中在邻接矩阵存储方式中,矩阵中每个元素的值都表示两个点之间的边的信息,如果每两个点之间都有变的信息,那么矩阵中的所有元素都是有效元素,那么从存储空间的利用率角度来看,其利用率较高,而采用邻接表存储其存储空间利用率肯定低于邻接矩阵,因为采用邻接表存储,不仅要存储边的信息,还要存储节点信息,指针信息等。 这种情况下,这个图很显然是一个完全图,因此从存储空间的利用率角度来看,完全图适合采用邻接矩阵存储。本题选C。
单选题
161. 下面关于图(网)的叙述,正确的是( )。
- A. 连通无向网的最小生成树中,顶点数恰好比边数多1
- B. 若有向图是强连通的,则其边数至少是顶点数的2倍
- C. 可以采用AOV 网估算工程的工期
- D. 关键路径是AOE 网中源点至汇点的最短路径
答案:A
解析:
本题考查数据结构方面的基础知识。 在有向图中,若以顶点表示活动,用有向边表示活动之间的优先关系,则称这样的有向图为以顶点表示活动的网(Activity On Vertex Network, AOV网)。AOV不能估算工期。 若在带权有向图G中以顶点表示事件,以有向边表示活动,边上的权值表示该活动持续的时间,则这种带权有向图称为用边表示活动的网(Activity On Edge Network, AOE网)通常在AOE网中列出了完成预定工程计划所需进行的活动、每项活动的计划完成时间、要发生哪些事件以及这些事件和活动间的关系,从而可以分析该项工程是否实际可行并估计工程完成的最短时间,分析出哪些活动是影响工程进度的关键。进一步可以进行人力、物力的调度和分配,以达到缩短工期的目的。 项目工期是AOE中最长的路径,称之为关键路径(项目最短工期)。 强连通图:在有向图G中如果对于每一对顶点Vi,Vj,从顶点Vi到顶点Vj和从顶点Vj到顶点Vi都存在路径,则称图为强连通图,如果对于有n个顶点的强连通图,假设由V0到Vn-1依次连接,最后由Vn-1回到V0形成环路时,此时形成的强连通图,边数为n,因此B选项错误。 根据生成树的定义,有n个顶点的连通图的生成树恰好有n-1条边。本题选A。
单选题
162. 一个具有n(n>0)个顶点的连通无向图至少有( )条边。
- A. n+1
- B. n
- C. n/2
- D. n-1
答案:D
解析:
在无向图中,如果从一个顶点到另一个顶点有路径,则称这两个顶点是连通的。如果对于图中任意两个顶点都是连通的,则称该无向图是连通的。所以具有n(n>0)个顶点的连通无向图至少有n–1条边。本题选D。
单选题
163. 具有n个顶点、e条边的图采用邻接表存储结构,进行深度优先遍历和广度优先遍历运算的时间复杂度均为()。
- A. O(n^2)
- B. O(e^2)
- C. O(n*e)
- D. O(n+e)
答案:D
解析:
本题考查数据结构基础知识。 深度优先和广度优先遍历图的过程实质上是对某个顶点查找其邻接点的过程,其耗费的时间取决于所采用的存储结构。当图用邻接矩阵表示时,查找所有顶点的邻接点所需时间为O(n2)。若以邻接表作为图的存储结构,则需要O(e)的时间复杂度查找所有顶点的邻接点。因此,当以邻接表作为存储结构时,深度优先搜索遍历图的时间复杂度为O(n+e)。 本题选D。
单选题
164. 拓扑排序是指有向图中的所有顶点排成一个线性序列的过程,若在有向图中从顶点vi到vj有一条路径,则在该线性序列中,顶点vi必然在顶点vj之前。因此,若不能得到全部顶点的拓扑排序序列,则说明该有向图一定( )。
- A. 包含回路
- B. 是强连通图
- C. 是完全图
- D. 是有向树
答案:A
解析:
本题考查图数据结构。 对有向图进行拓扑排序的方法如下: (1)在AOV网中选择一个入度为0(没有前驱)的顶点且输出它。 (2)从网中删除该顶点及其与该顶点有关的所有边。 (3)重复上述两步,直至网中不存在入度为0的顶点为止。 执行的结果会有两种情况:一种是所有顶点己输出,此时整个拓扑排序完成,说明网中不存在回路;另一种是尚有未输出的顶点,剩余的顶点均有前驱顶点,表明网中存在回路,拓扑排序无法进行下去。本题选A。
单选题
165. 若采用邻接矩阵来存储简单有向图,则其某一个顶点i的入度等于该矩阵( )。
- A. 第i行中值为1的元素个数
- B. 所有值为1的元素总数
- C. 第i行及第i列中值为1的元素总个数
- D. 第i列中值为1的元素个数
答案:D
解析:
邻接矩阵中,顶点i的入度等于所有指向i的边数。邻接矩阵的行表示边的起点,列表示边的终点。因此,顶点i的入度应从所有行的第i列中统计值为1的个数,即第i列中值为1的元素个数。本题选D。
单选题
166. 简单无向图的邻接矩阵是对称的,可以对其进行压缩存储。若无向图G有n个节点。若无向图G 有n个节点,其邻接矩阵为A[1..n,1..n], 且压缩存储在B[1..k] 中,则k 的值至少为( ) 。若按行压缩存储对称矩阵的上三角元素,则当n等于10时,边(V6,V3) 的信息存储在B[( 作答此空)] 中。
- A. 18
- B. 19
- C. 20
- D. 21
答案:C
解析:
具有n个结点的简单无向图的邻接矩阵是对称矩阵,对称矩阵关于主对角线对称,因此只需存储上三角或下三角部分即可。比如,我们只存储上三角中的元素aij,其特点是j≤i且1≤i≤n,对于上三角中的元素aij,它和对应的aji相等,因此当访问的元素在上三角时,直接去访问和它对应的三角元素即可,这样,原来需要n*n个存储单元,现在只需要n(n+1)/2个存储单元了,由于简单无向图中没有自环,因此主对角线的元素无须存储,因此至少需要n(n-1)/2个存储单元。
若按行压缩存储对称矩阵的上三角元素,则第1行需要存储n-1个元素,第二行存储n-2个元素,第i行需要存储n-i个元素,元素aij(1≤i≤n-1且i<j≤n)存储在B[(i-1)n-i(i-1)/2+j-i]中,当n为10,与边(V6,V3)对应的矩阵元素a3,6,即其信息存储在B[20]中。
本题选C。
单选题
167. 若n2、n1、n0分别表示一个二叉树中度为2、度为1和叶子结点的数目(结点的度定义为结点的子树数目),则对于任何一个非空的二叉树,( )。
- A. n2一定大于n1
- B. n1一定大于n0
- C. n2一定大于n0
- D. n0一定大于n2
答案:D
解析:
根据二叉树的性质,我们知道n0=n2+1,因此在一棵二叉树中,叶子结点的数目一定是大于度为2的结点的个数。本题选D。
单选题
168. 已知一个二叉树的先序遍历序列为①、②、③、④、⑤,中序遍历序列为②、①、④、③、⑤,则该二叉树的后序遍历序列为( )。对于任意一棵二叉树,叙述错误的是( )。
- A. 由其后序遍历序列和中序遍历序列可以构造该二叉树的先序遍历序列
- B. 由其先序遍历序列和后序遍历序列可以构造该二叉树的中序遍历序列
- C. 由其层序遍历序列和中序遍历序列可以构造该二叉树的先序遍历序列
- D. 由其层序遍历序列和后序遍历序列不能构造该二叉树的中序遍历序列
答案:B
解析:
仅靠先序遍历与后序遍历仅能确定根节点,无法确定根节点的左右孩子,从而无法确定二叉树的各个节点,因此答案选B。
单选题
169. 在—棵度为3的树中,若有2个度为3的结点,有1个度为2的结点,则有( )个度为0的结点。
- A. 4
- B. 5
- C. 6
- D. 7
答案:C
解析:
根据树中节点数与分支数的关系公式,n0=1+n2+2n3,可以得到n0=6,答案选C。
单选题
170. 在常用的描述二叉排序树的存储结构中,关键字值最大的结点( )。
- A. 左指针一定为空
- B. 右指针一定为空
- C. 左右指针均为空
- D. 左右指针均不为空
答案:B
解析:
二叉排序树或者是一棵空树,或者是具有下列性质的二叉树:①若它的左子树不空,则左子树上所有结点的值均小于它的根结点的值; ②若它的右子树不空,则右子树上所有结点的值均大于它的根结点的值; ③它的左、右子树也分别是二叉排序树。所以关键字最大的结点可以有左子树,但一定没有右子树,否则该结点就不会是最大的结点。本题选B。
单选题
171. 设结点x和y是二叉树中任意的两个结点,在该二叉树的先序遍历序列中x在y之前,而在其后序遍历序列中x在y之后,则x和y的关系是( )。
- A. x是y的左兄弟
- B. x是y的右兄弟
- C. x是y的祖先
- D. x是y的后裔
答案:C
解析:
先序遍历为根左右,后续遍历为左右根,这个过程中只有根的位置在变化,因此可以得出x为y的祖先,答案选C。
单选题
172. 设一个包含N个顶点、 E条边的简单有向图采用邻接矩阵存储结构 (矩阵元素A[i][j]等于1/0分别表示顶点i与顶点j之间有/无弧),则该矩阵的元素数目为 (),其中非零元素数目为(作答此空)。
- A. N
- B. N+E
- C. E
- D. N–E
答案:C
解析(AI 生成):
邻接矩阵用 N 行 N 列表示 N 个顶点之间是否存在弧,元素总数为 N²;每条弧在矩阵中对应唯一一个 1,简单图无重弧,故非零元素恰为 E 个,选 C。N 是顶点数,N+E、N−E 与弧数没有对应关系。
单选题
173. 对于二维数组a[1..N,1..N]中的一个元素a[i,j](1≤i,j≤N),存储在a[i,j]之前的元素个数( )。
- A. 与按行存储或按列存储方式无关
- B. 在i=j时与按行存储或按列存储方式无关
- C. 在按行存储方式下比按列存储方式下要多
- D. 在按行存储方式下比按列存储方式下要少
答案:B
解析:
按行存储即先存储完第一行元素,再开始存储第二行元素,依次类推。按列存储即先存储完第一列元素,再开始存储第二列元素,依次类推。 因为按行存储和按列存储是两种不同的存储方式,因此在本题中,存储在a[i,j]之前的元素个数与存储方式的选择有关。另外,由于二维数组a的行和列都是n,是相等的,那么在i=j(即行等于列)的情况下,存储元素的个数也是与存储方式无关的。 本题选B。
单选题
174. 对于二维数组a[0..4,1..5] ,设每个元素占1个存储单元,且以列为主序存储,则元素a[2,2]相对于数组空间起始地址的偏移量是() 。
- A. 5
- B. 7
- C. 10
- D. 15
答案:B
解析:
本题考查数组元素的存储。 若二维数组A[L1...U1,L2..U2]以行为主序存储,每个元素占用d个存储单元,则元 素A[I,J]的存储位置相对于数组空间首地址的偏移量为 ((I一L1)×(U2一L2+ 1)+J一L2)× d 若二维数组A[L1..U1,L2..U2]以列为主序存储,每个元素占用d个存储单元,则元 素A[I,J]的存储位置相对于数组空间首地址的偏移量为 ((J-L2)×(U1一L1 +1)+ I一L1)× d 本题中d=1,L1=0.U1=4, L2=1.U2=5,代入后计算可得偏移量为7,本题答案选B。
单选题
175. 若循环队列以数组 Q[O..m-1] 作为其存储结构叭变量 rear 表示循环队列中队尾元素的实际位置,其移动按 rear=(rear+1) mod m 进行,变量 length 表示当前循环队列中的元素个数,则循环队列的队首元素的实际位置是( )。
- A. rear-length
- B. (rear-length+m) mod m
- C. (1+rear+m-length) mod m
- D. m-length
答案:C
解析:
按照循环队列的定义,因为元素移动按照rear=(rear+1)MOD m进行,则当数组Q[m-1]存放了元素之后,下一个入队的元素将存放到Q[0]中,因此队列的首元素的实际位置是(1+rear+m-length) mod m ,本题选C。
单选题
176. 对于一个长度大于1且不存在重复元素的序列,令其所有元素依次通过一个初始为空的队列后,再通过一个初始为空的栈。设队列和栈的容量都足够大,一个序列通过队列(栈)的含义是序列的每个元素都入队列(栈)且出队列(栈)一次且仅一次。对于该序列在上述队列和栈上的操作,正确的叙述是( )。
- A. 出队序列和出栈序列一定相同
- B. 出队序列和出栈序列一定互为逆序
- C. 入队序列与出队序列一定相同,入栈序列与出栈序列不一定相同
- D. 入栈序列与出栈序列一定互为逆序,入队序列与出队序列不一定互为逆序
答案:C
解析:
本题主要考查队列和栈的特性。队列具有先进先出的特点,而栈具有后进先出的特点。因此我们可以知道入队序列与出队序列一定相同,但入栈序列与出栈序列不一定相同。比如a,b,c这样一个序列,那么按照a,b,c的顺序入队列,那么其出队列的次序一定是a,b,c。而按照a,b,c的顺序入栈,那么可能是a入栈后就出栈,然后b入栈又出栈,然后C入栈出栈。也可能是等a,b,c都入栈后再出栈,那么出栈序列就是c,b,a。本题选C。
单选题
177. 若对一个链表最常用的操作是在末尾插入结点和删除尾结点,则采用仅设尾指针的单向循环链表(不含头结点)时,( )。
- A. 插入和删除操作的时间复杂度都为O(1)
- B. 插入和删除操作的时间复杂度都为O(n)
- C. 插入操作的时间复杂度为O(1),删除操作的时间复杂度为O(n)
- D. 插入操作的时间复杂度为O(n),删除操作的时间复杂度为O(1)
答案:C
解析:
若对一个链表最常用的操作是在末尾插入结点和删除尾结点,采用仅设尾指针的单向循环链表(不含头结点)时,插入操作的时间复杂度为O(1),删除操作的时间复杂度为O(n)。本题选C。
单选题
178. 对于线性表(由n个同类元素构成的线性序列),采用单向循环链表存储的特点之一是( )。
- A. 从表中任意结点出发都能遍历整个链表
- B. 对表中的任意结点可以进行随机访问
- C. 对于表中的任意一个结点,访问其直接前驱和直接后继结点所用时间相同
- D. 第一个结点必须是头结点
答案:A
解析:
采用单向循环链表存储的特点之一是从表中任意结点出发都能遍历整个链表,另外便于元素的元素节点的删除与插入。如需要对表中的任意节点进行随机访问需采用顺序存储结构。本题选A。
单选题
179. 以下关于线性表存储结构的叙述,正确的是( )。
- A. 线性表采用顺序存储结构时,访问表中任意一个指定序号元素的时间复杂度为常量级
- B. 线性表采用顺序存储结构时,在表中任意位置插入新元素的运算时间复杂度为常量级
- C. 线性表采用链式存储结构时,访问表中任意一个指定序号元素的时间复杂度为常量级
- D. 线性表采用链式存储结构时,在表中任意位置插入新元素的运算时间复杂度为常量级
答案:A
解析:
线性表采用顺序存储结构时,访问表中任意一个指定序号元素的时间复杂度为常量级,因为顺序存储结构访问元素时,能直接定位元素,这样,操作的时间复杂度为O(1)。而插入一个元素时,需要将其他的元素位置进行调整,因此任意位置插入新元素的时间复杂度为O(n)。 线性表采用链式存储结构时,访问表中的任意一个指定序号元素时,需要从起始位置,通过指针指向,直到到达指定位置,才能访问该元素,时间复杂度为O(n)。而插入一个新元素时,找到任意位置的时间复杂度为O(n),而插入可以直接通过改变指针指向进行插入,时间复杂度为O(1),因此任意位置插入新元素整个操作的时间复杂度为O(n)。 因此本题只有A选项是正确的。
单选题
180. 单向链表中往往含有一个头结点,该结点不存储数据元素,一般令链表的头指针指向该结点,而该结点指针域的值为第一个元素结点的指针。以下关于单链表头结点的叙述中,错误的是( )。
- A. 若在头结点中存入链表长度值,则求链表长度运算的时间复杂度为O(1)
- B. 在链表的任何一个元素前后进行插入和删除操作可用一致的方式进行处理
- C. 加入头结点后,代表链表的头指针不因为链表为空而改变
- D. 加入头结点后,在链表中进行查找运算的时间复杂度为O(1)
答案:D
解析:
选项A:头结点存储链表长度值后,可以直接访问得到长度,时间复杂度为O(1),正确。 选项B:头结点使得所有元素节点均有前驱,插入/删除操作无需单独处理头指针,可实现统一操作,正确。 选项C:头结点存在时,链表为空仅表示头结点指针域为空,头指针仍指向头结点本身,正确。 选项D:查找操作仍需遍历链表元素,时间复杂度为O(n)。头结点无法缩短查找的遍历过程,错误。本题选D。
单选题
181. 广义表中的元素可以是原子,也可以是表,因此广义表的适用存储结构是()。
- A. 链表
- B. 静态数组
- C. 动态数组
- D. 散列表
答案:A
解析:
本题考查数据结构基础知识。 链表是最灵活的存储结构,它允许同一个表中的结点类型可以不一致。静态数组是固定长度的数组,动态数组允许扩容,但是数组中的元素必须是相同类型的,这不适用于广义表。散列表的特点是元素的存储位置与其关键字值相关。本题选A。
单选题
182. 以下关于哈夫曼树的叙述,正确的是( )。
- A. 哈夫曼树一定是满二叉树,其每层结点数都达到最大值
- B. 哈夫曼树一定是平衡二叉树,其每个结点左右子树的高度差为-1、0或1
- C. 哈夫曼树中左孩子结点的权值小于父节点、右孩子节点的权值大于父节点
- D. 哈夫曼树中叶子节点的权值越小则距离树根越远、叶子结点的权值越大则距离树根越近
答案:D
解析:
给定n个权值作为n个叶子结点,构造一棵二叉树,若带权路径长度达到最小,称这样的二叉树为最优二叉树,也称为哈夫曼树。哈夫曼树是带权路径长度最短的树,权值较大的结点离根较近。所以D选项的说法正确。 在构造哈夫曼树的过程中不能保证一定是完全树或是平衡树,因此A、B选项错误,而对于哈夫曼树左右孩子结点的权值之和构造其父结点,因此父结点权值一定大于其左右孩子结点,因此C选项错误。
单选题
183. 给定一个有n个元素的有序线性表。若采用顺序存储结构,则在等概率前提下,删除其中的一个元素平均需要移动( )个元素。
- A. (n+1)/2
- B. n/2
- C. (n-1)/2
- D. 1
答案:C
解析:
本题考查线性表在顺序存储结构下的特点:
在表长为n的线性表中,共有n个可删除的元素,删除第一个元素a1时需要将后面的n-1个元素依次前移,删除最后一个元素ao时不需要移动元素。因此,等概率下删除元素时平均需要移动的元素个数为:(1+2+...+n-1)/n=(n-1)/2。本题选C。
单选题
184. 在对程序质量进行评审时,模块结构是一个重要的评审项,评审内容中不包括( )。
- A. 数据结构
- B. 数据流结构
- C. 控制流结构
- D. 模块结构与功能结构之间的对应关系
答案:A
解析:
模块结构评审时,主要包括以下方面的评审: 1、控制流结构:规定了处理模块与处理模块之间的流程关系。检查处理模块之间的控制转移关系与控制转移形式(调用方式)。 2、数据流结构:规定了数据模块是如何被处理模块进行加工的流程关系。检查处理模块与数据模块之间的对应关系;处理模块与数据模块之间的存取关系,如建立、删除、查询、修改等。 3、模块结构与功能结构之间的对应关系:包括功能结构与控制流结构的对应关系;功能结构与数据流结构的对应关系;每个模块的定义(包括功能、输入与输出数据)。 本题选A。
单选题
185. 在下列算法设计方法中,()在求解问题的过程中并不从整体最优上加以考虑,而是做出在当前看来是最好的选择。利用该设计方法可以解决 (作答此空)问题。
- A. 排序
- B. 检索
- C. 背包
- D. 0/1背包
答案:C
解析:
在下列算法设计方法中,贪心法在求解问题的过程中并不从整体最优上加以考虑,而是通过每一步选择当前最优的局部解来逼近整体最优解。该设计方法可以解决背包问题。
单选题
186. 计算机执行程序时,内存分为静态数据区、代码区、栈区和堆区。其中( )一般在进行函数调用和返回时由系统进行控制和管理,(作答此空)由用户在程序中根据需要申请和释放。
- A. 静态数据区
- B. 代码区
- C. 栈区
- D. 堆区
答案:D
解析:
在计算机执行程序时,内存划分为不同区域,每个区域有特定的用途和管理方式。 栈区:在进行函数调用和返回时由系统自动控制和管理。它用于存储局部变量、函数参数、返回地址等,分配和释放由编译器自动处理,遵循“先进后出”的原则。 堆区:由用户(程序员)在程序中根据需要手动申请和释放。它用于动态内存分配,如通过malloc或free等函数管理,空间较大但需谨慎处理以避免内存泄漏。 因此,第一个空应填“栈区”,第二个空应填“堆区”。
单选题
187. 在求解某问题时,经过分析发现该问题具有最优子结构和重叠子问题性质。则适用( ) 算法设计策略得到最优解。若了解问题的解空间,并以广度优先的方式搜索解空间,则采用的是(作答此空)算法策略。
- A. 动态规则
- B. 贪心
- C. 回溯
- D. 分支限界
答案:D
解析:
要想直接解决一个较大的问题,有时是相当困难的,分治法的设计思想是将一个难以解决的大问题分解成一些规模较小的相同问题,以便各个击破,分而治之。 动态规划法与分治法类似,其基本思想也是将带求解问题分解为若干个子问题,先求解子问题再从这些子问题的解得到原问题的解。与分治法不同的是,适合用动态规划法求解的问题,经分解得到的子问题往往不是独立的。若用分治法来解这类问题,则相同的子问题会被求解多次,以至于最后解决原问题需要耗费指数级时间。此时用一个中间表记录重复子问题的解,可以避免大量的重复计算。这就是动态规划法的基本思路。动态规划法的应用场景一般会出现最优子结构”的描述,并且针对重复子问题的计算通过记录查表,可以提高效率。本题第一空描述的是C选项动态规划法。 贪心法也经常用于解决最优化问题,与之不同的是,贪法在解决问题的策略上是仅根据当前已有的信息做出选择,而且一旦做出选择,无论未来如何都不会改变。也就是只考虑当前最优,不考虑全局最优。一般不涉及划分和求解重复子问题。 回溯法可以系统地搜索一个问题的所有解或任意解。 它在包含问题的解空间树中,按照深度优先的策略的策略,从根结点出发搜索解空间树。 分支限界法类似于回溯法,也是一种在问题的解空间树T 上搜索问题解的算法,但在一般情况下,分支限界法与回溯法的求解目标不同。分支限界法的求解目标是找出满足约束条件的一个解即可。由于求解目标不同,其探索方式与回溯法也不同,分支限界法以广度优先或以最小耗费优先的方式搜索解空间树。本题第二空描述的是D选项分支限界法。
单选题
188. 在有序数组 [5,15,20,22,24,26,28,29,30,40] 中使用二分查找算法查找关键字 30,查找过程中依次比较的中间元素是( )。
- A. 24 → 26 → 30
- B. 24 → 29 → 30
- C. 22 → 28 → 30
- D. 20 → 26 → 30
答案:B
解析:
初始范围:整个数组,索引 low=0 到 high=9。中间位置:mid = (0+9)//2 = 4 → 元素 24。比较 24 和 30:30 > 24 → 继续在右半部分(low=5,high=9)查找。 第二轮范围:索引 5 到 9(元素 26,28,29,30,40)。中间位置:mid = (5+9)//2 = 7 → 元素 29。比较 29 和 30:30 > 29 → 继续在右半部分(low=8,high=9)查找。 第三轮范围:索引 8 到 9(元素 30,40)。中间位置:mid = (8+9)//2 = 8 → 元素 30。比较 30 和 30:相等 → 查找成功,返回索引 8。
单选题
189. 贪心算法的主要缺陷是( )。
- A. 算法复杂度通常较高,运行效率低
- B. 占用存储空间较大
- C. 在求解某些问题时,可能无法得到全局最优解
- D. 对于任何问题,其计算结果都不准确
答案:C
解析:
贪心算法的核心思想是在每一步都采取当前状态下局部最优的选择,期望以此达到全局最优。然而,其最主要的缺陷在于在某些问题中,局部最优解的累积无法保证最终获得全局最优解。
单选题
190. 对于动态规划问题,dp[i][j] 一般代表( )。
- A. 从起点到位置 (i,j) 的最优解
- B. 位置 (i,j) 的原始输入值
- C. 从位置 (i,j) 到终点的最优解
- D. 状态转移方程的系数
答案:A
解析:
在动态规划中,dp[i][j] 通常定义为从起始状态到状态 (i,j) 的最优值(如最小代价、最大收益等)。
单选题
191. 下列伪代码的时间复杂度是( )。 for i from 0 to n-1 do j = 0 while j < n do j = j + 1 end while end for
- A. O(n)
- B. O(n²)
- C. O(log n)
- D. O(n log n)
答案:B
解析:
外层 for 循环执行 n 次,内层 while 循环每次执行 n 次(j 从 0 递增到 n-1),因此总操作次数为 n × n = n²,时间复杂度为 O(n²)。
单选题
192. 对于有向图 G,其边集为 {V1→V2, V1→V3, V1→V4, V2→V3}。从顶点 V1 开始进行深度优先遍历,可能的顶点访问序列有多少( )种。
- A. 3
- B. 4
- C. 5
- D. 6
答案:C
解析:
从顶点 V1 开始遍历,其邻接顶点有 V2、V3、V4。根据不同的访问顺序,所有可能的遍历序列如下: 先访问 V2:后续唯一确定(V2→V3→V4),序列为 V1, V2, V3, V4。 先访问 V3:之后可先选 V2 或 V4,得到两个序列:V1, V3, V2, V4 和 V1, V3, V4, V2。 先访问 V4:之后可先选 V2 或 V3,得到两个序列:V1, V4, V2, V3 和 V1, V4, V3, V2。 总计 5 种不同的顶点访问序列,因此选项 C 正确。
单选题
193. 给定字符频率:0.08、0.25、0.25、0.31、0.1,在哈夫曼编码中,以下正确的是( )。
- A. 频率为0.08的字符编码长度为1
- B. 频率为0.1的字符编码长度为2
- C. 频率为0.08和0.1的字符编码长度相同
- D. 频率为0.25和0.31的字符编码长度不同
答案:C
解析:
构建哈夫曼树时,频率最低的两个字符(0.08和0.1)首先被合并,因此它们在树中的深度相同,编码长度也相同(均为3)。其他选项与事实不符,选项A和B错误地指定了编码长度;选项D错误,因为频率0.25和0.31的字符编码长度相同(均为2)。
单选题
194. 若用n个权值构造一棵最优二叉树(哈夫曼树),则该二叉树的结点总数为( )。
- A. 2n
- B. 2n-1
- C. 2n+1
- D. 2n+2
答案:B
解析:
本题考查数据结构基础知识。 二叉树具有以下性质:度为2的结点(双分支结点)数比度为0(叶子结点)数正好少1。而根据最优二叉树(哈夫曼树)的构造过程可知,最优二叉树中只有度为2和0的结点,因此,其结点总数为2n-1。
单选题
195. 下面关于回溯法说法正确的是( )。
- A. 回溯法按广度优先策略搜索解空间树
- B. 回溯法在搜索过程中不能进行剪枝
- C. 回溯法是一种按深度优先策略搜索解空间树,并通过剪枝函数提高效率的算法
- D. 回溯法只能求解最优化问题,不能求解存在性问题
答案:C
解析(AI 生成):
回溯法从根出发按深度优先搜索解空间树,进入一个结点先判断是否满足约束,不满足即剪枝回退,从而跳过大量无效分支,C 正确。A 把深度优先误作广度优先;B 否认剪枝,与回溯法依靠限界函数提高效率的事实不符;D 缩小了适用范围。
单选题
196. 以下算法中,哪一个第一趟排序不能确定一个最小元素( )。
- A. 冒泡排序
- B. 简单选择排序
- C. 快速排序
- D. 堆排序
答案:C
解析:
冒泡排序反复比较相邻元素,逆序则交换,每一趟把最大(或最小)"冒"到一端。例如数组[5,3,8,1,9,2]第一趟排序的结果是[5,3,8,1,9,2]→ [3,5,1,8,2,9] → [3,1,5,2,8,9] → [1,3,2,5,8,9]。可以确定最小的元素1。 简单选择排序每趟从待排序区选出最小元素,放到已排序区末尾。例如,数组[5,3,8,1,9,2] → 找到最小值1 → 与第一个位置5交换→ [1,3,8,5,9,2]。 快速排序选一个基准值 pivot,把小于它的放左边,大于它的放右边,然后递归处理两边。例如针对数组[5,3,8,1,9,2] → 划分后 → [2,3,1] 5 [8,9]。最小值 1 确实在左边,但左边还有 2 和 3,1 的最终位置完全不确定,还需要继续递归。 堆排序堆顶是极值,每趟把堆顶与末尾交换,确定一个元素的最终位置。例如,[5,3,8,1,9,2] → 建小根堆 → [1,3,2,5,9,8]→ 堆顶1与末尾交换 → [8,3,2,5,9,1]→ 调整堆...。
单选题
197. 某算法的时间复杂度由递归式 T(n) = 2T(n/2) + nlogn 定义,其渐近紧致界为( )。
- A. Θ(n)
- B. Θ(n log n)
- C. Θ(n²)
- D. Θ(n log²n)
答案:D
解析:
把递归式展开成树来看:第0层工作量是nlogn,第1层两个子问题加起来是n(logn-1),第2层是n(logn-2)……每层工作量都比上一层少一个n,一共logn层,把这些层加起来就是 n×(logn + (logn-1) + (logn-2) + ... + 1),括号里是1到logn的求和,等于logn×(logn+1)/2,所以总工作量是 n × log²n / 2,去掉常数就是 Θ(n log²n)。
单选题
198. 下列排序算法中,所有情况下时间复杂度均为O(nlogn)且是稳定排序的是( )。
- A. 快速排序
- B. 堆排序
- C. 归并排序
- D. 希尔排序
答案:C
解析:
快排平均O(nlogn),但最坏O(n²)(如已排序数组),且不稳定(相同元素相对顺序可能改变)。 堆排始终O(nlogn),但不稳定(堆调整时跳着交换)。 归并排序分割和合并始终为O(nlogn),且合并时遇到相等元素先取左侧,保证稳定。 希尔排序时间复杂度依赖增量序列(最坏O(n²),平均O(n^1.3)),且不稳定(相隔记录交换)。
单选题
199. 某程序采用回溯法求解有序数组中子序列之和等于指定值的问题,其最坏情况下的时间复杂度最可能是( )。
- A. O(n)
- B. O(n²)
- C. O(2ⁿ)
- D. O(logn)
答案:C
解析:
回溯法(Backtracking)本质是穷举搜索。对于子序列求和问题,每个元素有“选”或“不选”两种状态,状态空间大小为2ⁿ,因此最坏需遍历所有子集,时间复杂度为O(2ⁿ)。
单选题
200. 以下算法中,时间复杂度为O(nlogn)的是( )。
- A. 冒泡排序(最坏情况)
- B. 快速排序(平均情况)
- C. 插入排序(最坏情况)
- D. 选择排序(平均情况)
答案:B
解析:
冒泡最坏O(n²)。 快排平均O(nlogn)。 插入最坏O(n²)。 选择排序始终O(n²)。
单选题
201. 若循环队列Q[0..m-1]用front、rear指示队头与队尾,约定rear指向即将插入位置,则队列长度公式为( )。
- A. (rear - front + m) % m
- B. (rear - front + 1 + m) % m
- C. rear - front
- D. rear - front + 1
答案:A
解析:
循环队列中,为了区分队空和队满,通常空出一个单元。约定rear指向下一个插入位置,则长度 = (rear - front + m) % m。多加了1,用于rear指向队尾元素的场景。 C/未考虑循环取模,导致负数或越界。
单选题
202. 某二叉树的前序遍历序列为 ABDEGHCF,中序遍历序列为 DBGEHACF,则该二叉树的后序遍历序列为( )。
- A. DGHEBFCA
- B. DBGEHACF
- C. DGHEBCFA
- D. DGEBHCFA
答案:A
解析:
前序根 A。中序左子树 DBGEH(A的左边),右子树 CF(A的右边)。 左子树前序 BDEGH,根 B。中序左 D,右 GEH。 右子树前序 C(根),中序左空,右 F。 递归构建树后,后序(左右根)为:左子树(D G E H B),右子树(F C),根 A。组合为 DGHEBFCA。
单选题
203. 对于B树(B-Tree)中阶数为m的树,以下说法正确的是( )。
- A. 每个结点最多有m棵子树
- B. 根结点至少有2棵子树
- C. 每个非根内结点至少有⌈m/2⌉-1个关键字
- D. 所有叶子结点必须在同一层
答案:D
解析:
B树的核心平衡条件之一是所有叶子结点位于同一层,确保查找效率稳定。选项A虽描述正确(每个结点最多m棵子树),但并非B树特有的区分性性质。选项B错误,根结点为叶子时子树数为0。选项C错误,正确表述应为至少⌈m/2⌉棵子树,对应至少⌈m/2⌉−1个关键字,但该表述本身不够严谨,且D为绝对无误选项。
单选题
204. 有向图的拓扑排序序列,以下说法错误的是( )。
- A. 若有向图存在环,则无法进行拓扑排序
- B. 拓扑排序序列可能不唯一
- C. 拓扑排序序列反映了顶点之间的依赖关系
- D. 拓扑排序可以从任意顶点开始
答案:D
解析:
拓扑排序每一步必须选择当前入度为0的顶点输出,入度非0表示存在前驱尚未输出,违反依赖顺序,故不可从任意顶点开始。选项A正确,拓扑排序仅适用于有向无环图。选项B正确,若当前存在多个入度为0的顶点,选择顺序不同可产生不同序列。选项C正确,拓扑序保持边的方向,反映任务依赖关系。
单选题
205. 字符串“abaabaab”的KMP算法中,部分匹配值(next数组,约定next[1]=0)的值为( )。(下标从1开始)
- A. 0 1 1 2 3 4 5 6
- B. 0 1 1 2 3 1 2 3
- C. 0 1 1 2 2 3 4 5
- D. 0 1 1 2 3 4 2 3
答案:C
解析:
对模式串“abaabaab”按KMP算法标准定义(失配时模式串指针回退位置)计算next数组,结果为 0 1 1 2 2 3 4 5。选项A、B、D中均含有不符合该模式串前后缀匹配规律的数字,经逐位推导均可排除。
单选题
206. 在平衡二叉树(AVL)中插入一个结点后导致失衡,需要进行旋转调整。若失衡结点为A,其左子树较高,且插入点位于A的左子树的右子树中,则应进行( )旋转。
- A. RR
- B. LL
- C. LR
- D. RL
答案:C
解析:
插入路径先向左(左子树较高)再向右(左子树的右子树),属于LR型失衡,需先对左子树根进行左旋,再对A进行右旋。选项A(RR)对应插入点在右子树的右子树,选项B(LL)对应插入点在左子树的左子树,选项D(RL)对应插入点在右子树的左子树。
单选题
207. 以下关于最小生成树(MST)的叙述,正确的是( )。
- A. Prim算法适合于边稠密的图
- B. Kruskal算法适合于边稀疏的图
- C. 图G的最小生成树是唯一的
- D. 最小生成树中的边权值之和一定最小
答案:D
解析:
最小生成树的定义即为所有生成树中边权值总和最小的树,此为确定性真理。选项A与B虽在多数教材中被作为算法选择原则(Prim适合稠密图,Kruskal适合稀疏图),但在算法优化后并非绝对,且二者均非定理性表述。选项C错误,存在等权值边时最小生成树可能不唯一。
单选题
208. 哈希表的装填因子α定义为( )。
- A. 表中记录数 / 表长度
- B. 表长度 / 表中记录数
- C. 表中记录数 / 关键字总数
- D. 关键字总数 / 表长度
答案:A
解析:
装填因子α = n / m,其中n为已存储的记录数,m为哈希表地址空间长度(槽位数)。选项B为该值的倒数。选项C与D将“关键字总数”这一无限域概念与表内已存记录数混淆。
单选题
209. 有n个顶点的强连通有向图,至少需要( )条边。
- A. n
- B. n−1
- C. n+1
- D. n(n−1)
答案:A
解析:
强连通图要求任意两点双向可达,n个顶点构成一个有向环即可满足,环的边数为n。选项B(n−1)为无向连通树的最小边数,有向树不具备强连通性。选项D为完全有向图的边数。
单选题
210. 快速排序采用分治策略,其分治过程的时间复杂度递推式为T(n)=2T(n/2)+O(n),该递推式的解为( )。
- A. O(n)
- B. O(nlogn)
- C. O(n²)
- D. O(logn)
答案:B
解析:
应用主定理(Master Theorem),a=2,b=2,f(n)=O(n),log_b a = 1,d=1,属于情况2,得T(n)=O(n log n)。选项A对应d=0的情形,选项C为最坏情况递推T(n)=T(n−1)+O(n)的解,选项D对应二分查找递推。
单选题
211. 基数排序(Radix Sort)的时间复杂度与( )有关。
- A. 关键字的位数和基数
- B. 关键字的比较次数
- C. 记录的移动次数
- D. 初始序列的有序性
答案:A
解析:
基数排序复杂度为O(d(n+r)),其中d为关键字位数,r为基数(桶数)。选项B错误,基数排序是非比较排序,比较次数为0。选项C虽与实现相关,但理论复杂度由d与r决定。选项D错误,基数排序与初始有序性无关。
单选题
212. 在一棵高度为h的完全二叉树中,节点总数的取值范围是( )。
- A. 2ʰ⁻¹ ~ 2ʰ
- B. 2ʰ⁻¹ ~ 2ʰ - 1
- C. 2ʰ⁻¹ - 1 ~ 2ʰ - 1
- D. 2ʰ⁻¹ + 1 ~ 2ʰ
答案:B
解析:
完全二叉树是除最后一层外,每一层都满的二叉树。高度为h时,前h-1层为满二叉树,节点数为2ʰ⁻¹ - 1。最后一层节点数最少为1(否则高度为h-1),最多为2ʰ⁻¹。因此总节点数最少为(2ʰ⁻¹ - 1) + 1 = 2ʰ⁻¹,最多为(2ʰ⁻¹ - 1) + 2ʰ⁻¹ = 2ʰ - 1。取值范围为[2ʰ⁻¹, 2ʰ - 1]。因此选B。
单选题
213. 具有n个顶点的无向完全图的边数为( )。
- A. n
- B. n(n-1)
- C. n(n-1)/2
- D. n²
答案:C
解析:
无向完全图中,任意两个顶点之间都有且仅有一条边。边数等于从n个顶点中任选2个的组合数 C(n,2) = n(n-1)/2。选项B是有向完全图的边数。因此选C。
单选题
214. Dijkstra算法用于求解( )。
- A. 图中所有顶点之间的最短路径
- B. 图中单源点到其余各顶点的最短路径
- C. 图中的最小生成树
- D. 图中各顶点间的关键路径
答案:B
解析:
Dijkstra算法是解决单源最短路径问题的经典算法,用于计算一个顶点到图中其他所有顶点的最短路径(权值非负)。选项A是Floyd算法的功能;选项C是Prim/Kruskal算法的功能;选项D是关键路径法(CPM)的功能。因此选B。
单选题
215. 在堆排序中,构建初始堆(大根堆)的时间复杂度为( )。
- A. O(n)
- B. O(nlogn)
- C. O(logn)
- D. O(n²)
答案:A
解析:
建堆过程从最后一个非叶子节点开始,依次向上调整(堆化),每个节点调整的复杂度与树高相关,但整体建堆的复杂度为O(n)。而堆排序的总体时间复杂度为O(nlogn),其中O(n)是建堆,O(nlogn)是n次删除堆顶的调整。选项B是堆排序整体的时间复杂度,选项D是冒泡/选择排序的时间复杂度。因此选A。
单选题
216. 在折半查找的判定树中,根节点的左子树和右子树的节点数( )。
- A. 一定相等
- B. 相差不超过1
- C. 左子树总比右子树多1
- D. 没有固定关系
答案:B
解析:
折半查找的判定树是一棵平衡二叉搜索树。当元素个数n为奇数时,左右子树节点数相等;当n为偶数时,左右子树节点数相差1。因此B正确。A过于绝对;C仅当n为偶数且取右中位时成立,并非一般规律。
单选题
217. 【问题1】 【代码】 #include <stdio.h> void selectSort(int data[ ],int n) //对 data[0]data[n-1]中的n个整数按非递减有序的方式进行排列 { int i,j,k; int temp; for(i=0;i<n-1;i++){ for(k=i,j=i+1;(1);(2)) //k表示data[i]data[n-1]中最小元素的下标 if(data[j]<data[k]) (3) if(k!=i) { //将本趟找出的最小元素与data[i]交换 temp=data[i];(4); data[k]=temp; } } } int main() { int arr[ ]={79,85,93,65,44,70,100,57}; int i,m; m=sizeof(arr)/sizeof(int); //计算数组元素的个数,用m表示 (5); //调用selectSort对数组arr进行非递减排序 for(i=0;i <m;i++) //按非递减顺序输出所有的数组元素 printf(“%d\t”,arr[i]); printf(“\n”); return 0; }
材料: 阅读以下说明和代码,填补代码中的空缺,将解答填入答题纸的对应栏内。 【说明】 对n个元素进行简单选择排序的基本方法是:第一趟从第1个元素开始,在n个元素中选出最小者,将其交换至第一个位置,第二趟从第2个元素开始,在剩下的n-1个元素中选出最小者,将其交换至第二个位置,依此类推,第i趟从n-i+1个元素中选出最小元素,将其交换至第i个位置,通过n-1趟选择最终得到非递减排序的有序序列。
参考答案:
(1)j<n或者j<=n-1 (2)j++ (3)k=j (4)data[i]=data[k] (5)selectSort(arr,m)此处m也可以填8或者sizeof(arr)/sizeof(int), arr可以改成&arr[0]
解析(AI 生成):
简单选择排序每趟在 data[i]~data[n-1] 中找最小元素下标 k,故内层条件为 j<n、步进 j++,遇到更小者令 k=j;找到后与 data[i] 交换,需要 data[i]=data[k],外层共 n-1 趟。主函数传入数组名与长度即可:selectSort(arr,m),arr 也可写成 &arr[0]。
问答题
218. 【问题1】(12分) 请将图中填空(1)~(6)补充完整。
材料: 试题四(16分) 阅读以下说明C函数和问题,回答问题1和问题2将解答填入答题纸的对应栏内。 【说明】 当数组中的元素已经排列有序时,可以采用折半查找(二分查找)法查找一个元素。下面的函数biSearch(int r[],int low,int high,int key)用非递归方式在数组r中进行二分查找,函数biSearch_rec(int r[],int low,int high,int key)采用递归方式在数组r中进行二分查找,函数的返回值都为所找到元素的下标;若找不到,则返回-1。 【C函数1】 int biSearch(int r[],int low,int high,int key) //r[low..high] 中的元素按非递减顺序排列 //用二分查找法在数组r中查找与key相同的元素 //若找到则返回该元素在数组r的下标,否则返回-1 { int mid; while((1)) { mid = (low+high)/2 ; if (key ==r[mid]) return mid; else if (key<r[mid]) (2); else (3); }/while/ return -1; }/biSearch/ 【C 函数 2】 int biSearch_rec(int r[],int low,int high,int key) //r[low..high]中的元素按非递减顺序排列 //用二分查找法在数组r中查找与key相同的元素 //若找到则返回该元素在数组r的下标,否则返回-1 { int mid; if((4)) { mid = (low+high)/2 ; if (key ==r[mid]) return mid; else if (key<r[mid]) return biSearch_rec((5),key); else return biSearch_rec((6),key); }/if/ return -1; }/biSearch_rec/
参考答案:
(1)low<=high (2)high=mid-1 (3)low=mid+1 (4)low<=high (5)r,low,mid-1 (6)r,mid+1,high
解析(AI 生成):
递归折半查找的框架是:区间有效(low<=high)才继续;取 mid 比较后,若 r[mid] 偏大则目标在左半区,令 high=mid-1 并递归左半区;偏小则令 low=mid+1 递归右半区;区间为空即查找失败。要点是每层重判 low<=high,递归边界随 mid 同步收缩。
问答题
219. 【问题2】(3分) 折半查找(二分查找)法对待排序元素要求是什么。
材料: 试题四(16分) 阅读以下说明C函数和问题,回答问题1和问题2将解答填入答题纸的对应栏内。 【说明】 当数组中的元素已经排列有序时,可以采用折半查找(二分查找)法查找一个元素。下面的函数biSearch(int r[],int low,int high,int key)用非递归方式在数组r中进行二分查找,函数biSearch_rec(int r[],int low,int high,int key)采用递归方式在数组r中进行二分查找,函数的返回值都为所找到元素的下标;若找不到,则返回-1。 【C函数1】 int biSearch(int r[],int low,int high,int key) //r[low..high] 中的元素按非递减顺序排列 //用二分查找法在数组r中查找与key相同的元素 //若找到则返回该元素在数组r的下标,否则返回-1 { int mid; while((1)) { mid = (low+high)/2 ; if (key ==r[mid]) return mid; else if (key<r[mid]) (2); else (3); }/while/ return -1; }/biSearch/ 【C 函数 2】 int biSearch_rec(int r[],int low,int high,int key) //r[low..high]中的元素按非递减顺序排列 //用二分查找法在数组r中查找与key相同的元素 //若找到则返回该元素在数组r的下标,否则返回-1 { int mid; if((4)) { mid = (low+high)/2 ; if (key ==r[mid]) return mid; else if (key<r[mid]) return biSearch_rec((5),key); else return biSearch_rec((6),key); }/if/ return -1; }/biSearch_rec/
参考答案:
解析(AI 生成):
折半查找要求线性表必须采用顺序存储(数组),且元素按关键字有序排列,通常为升序。只有有序才能依据中间元素的比较结果把查找区间折半;链式存储无法随机定位中点,故不适用。
问答题
220. 【问题1】(8分) 根据说明和C代码,填充C代码中的空(1)~(4)。
材料: 案例四(15分)
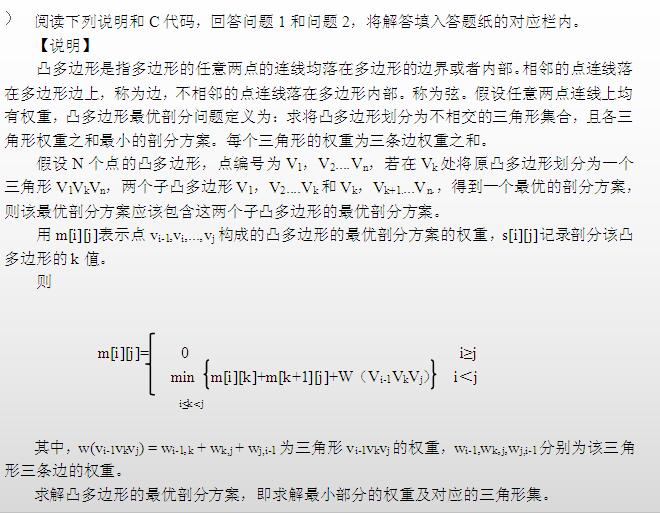
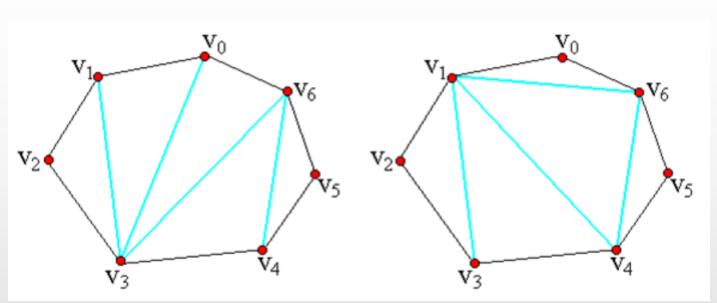
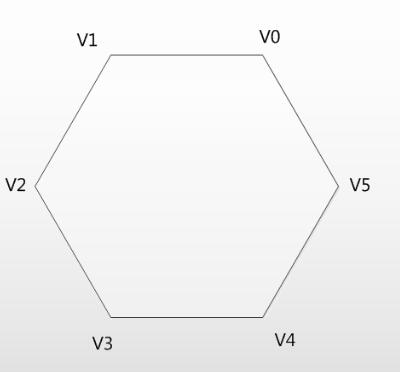
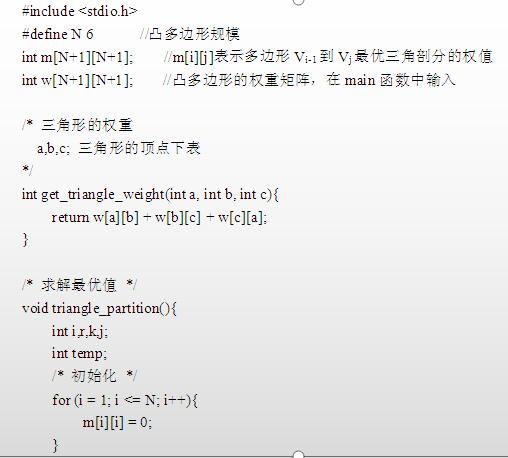
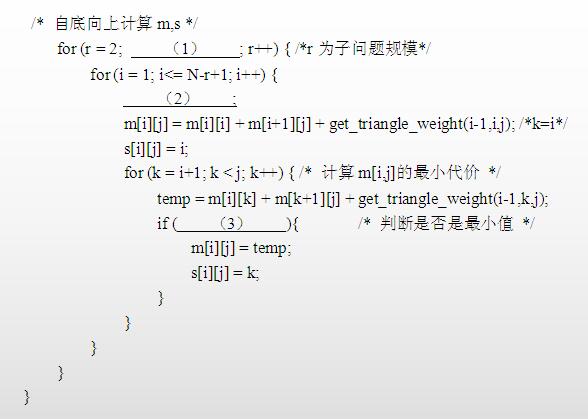
11
参考答案:
【问题1】 (1)r<=N (2),j,=,i+r,-1; (3)temp,<,m[i][j] (4)s[i][j],+,1,,,j
解析:
此题采用动态规划的方法,基本思想是首先求出所有3个点组成的多边形权重,然后保存起来。让再求出4个点组成的多边形权重然后保存起来,这个时候就能用前面已经计算得到的3个点组成的多边形的权重的最小值了,避免的重复求解。然后是5个点,6个点依次类推。直到计算完所有的点为止。
问答题
221. 【问题2】(7分) 根据说明和C代码,该算法采用的设计策略为 (5) ,算法的时间复杂度为 (6) ,空间复杂度为 (7) (用O表示)。
材料: 案例四(15分)
参考答案:
【问题2】 (5)动态规划(6)O(n^3) (7)O(n^2)
解析(AI 生成):
该算法用二维表保存各子问题的最优值,按区间长度从小到大填表,由子问题最优解推出原问题最优解,属动态规划。三重循环分别枚举区间长度、起点与分割点,时间O(n^3);表规模为n^2,空间O(n^2)。
问答题
222. 【问题1】 根据以上说明和C代码,填充(1)~(4)。
材料: 试题四 阅读下列说明和C代码,回答问题,将解答填入答题纸的对应栏内。 【说明】 采用归并排序对n个元素进行递增排序时,首先将n个元素的数组分成各含n/2个元素的两个子数组,然后用归并排序对两个子数组进行递归排序,最后合并两个已经排序的子数组得到排序结果。 下面的C代码是对上述归并算法的实现,其中的常量和变量说明如下: arr:待排序数组 P,q,r:一个子数组的位置从P到q,另一个子数组的位置从q+1到r begin,end:待排序数组的起止位量 left,right:临时存放待合并的两个子数组 n1,n2:两个子数组的长度 i,j,k:循环变量 mid:临耐变量 【C代码】 #inciude #inciude #define MAX 65536 void merge(int arr[],int p,int q,int r) { int *left, right; int n1,n2,i,j,k; n1=q-p+1; n2=r-q; if((left=(int)malloc((n1+1)sizeof(int)))=NULL) { perror("malloc error"); exit(1); } if((right=(int)malloc((n2+1)*sizeof(int)))=NULL) { perror("malloc error"); exit(1); } for(i=0;i<n1;i++){ left[i]= (1) ; } left[i]=MAX; for(i=0; i<n2; i++){ right[i]=arr[q+i+1] } right[i]=MAX; i=0; j=0; for(k=p; k<=r ; k++) { if(left[i]> right[j]) { (2) ; j++; }else { arr[k]=left[i]; i++; } } } void mergeSort(int arr[],int begin,int end){ int mid; if( begin<end ){ mid= (3) ; (4) ; mergeSort(arr,mid+1,end) ; merge(arr,begin,mid,end); } }
参考答案:
问题一 (1)arr[p+i] (2)arr[k]=right[j] (3)(begin+end)/2 (4)mergeSort(arr,begin,mid)
解析(AI 生成):
归并排序先把左半段复制到辅助数组,再比较左右两段取较小者写回原数组;mid由(begin+end)/2取得,随后递归排序左半段。四个空依次对应左段复制、右段搬移、中点划分与左半递归。
问答题
223. 【问题2】 根据题干说明和以上C代码,算法采用了(5)算法设计策略。其空间复杂度为(6)(用O符号表示)。
材料: 试题四 阅读下列说明和C代码,回答问题,将解答填入答题纸的对应栏内。 【说明】 采用归并排序对n个元素进行递增排序时,首先将n个元素的数组分成各含n/2个元素的两个子数组,然后用归并排序对两个子数组进行递归排序,最后合并两个已经排序的子数组得到排序结果。 下面的C代码是对上述归并算法的实现,其中的常量和变量说明如下: arr:待排序数组 P,q,r:一个子数组的位置从P到q,另一个子数组的位置从q+1到r begin,end:待排序数组的起止位量 left,right:临时存放待合并的两个子数组 n1,n2:两个子数组的长度 i,j,k:循环变量 mid:临耐变量 【C代码】 #inciude #inciude #define MAX 65536 void merge(int arr[],int p,int q,int r) { int *left, right; int n1,n2,i,j,k; n1=q-p+1; n2=r-q; if((left=(int)malloc((n1+1)sizeof(int)))=NULL) { perror("malloc error"); exit(1); } if((right=(int)malloc((n2+1)*sizeof(int)))=NULL) { perror("malloc error"); exit(1); } for(i=0;i<n1;i++){ left[i]= (1) ; } left[i]=MAX; for(i=0; i<n2; i++){ right[i]=arr[q+i+1] } right[i]=MAX; i=0; j=0; for(k=p; k<=r ; k++) { if(left[i]> right[j]) { (2) ; j++; }else { arr[k]=left[i]; i++; } } } void mergeSort(int arr[],int begin,int end){ int mid; if( begin<end ){ mid= (3) ; (4) ; mergeSort(arr,mid+1,end) ; merge(arr,begin,mid,end); } }
参考答案:
问题二 (5)分治、(6)O(n)
解析(AI 生成):
归并排序把序列二分为两个子序列,分别递归排序后再合并,是典型的分治策略。合并需要一个与原数组等长的辅助数组暂存结果,递归深度为logn但辅助空间不随层数叠加,故空间复杂度为O(n)。
问答题
224. 【问题3】 两个长度分别为n1和n2的已经排好序的子数组进行归并,根据上述C代码,则元素之间比较次数为(7)。
材料: 试题四 阅读下列说明和C代码,回答问题,将解答填入答题纸的对应栏内。 【说明】 采用归并排序对n个元素进行递增排序时,首先将n个元素的数组分成各含n/2个元素的两个子数组,然后用归并排序对两个子数组进行递归排序,最后合并两个已经排序的子数组得到排序结果。 下面的C代码是对上述归并算法的实现,其中的常量和变量说明如下: arr:待排序数组 P,q,r:一个子数组的位置从P到q,另一个子数组的位置从q+1到r begin,end:待排序数组的起止位量 left,right:临时存放待合并的两个子数组 n1,n2:两个子数组的长度 i,j,k:循环变量 mid:临耐变量 【C代码】 #inciude #inciude #define MAX 65536 void merge(int arr[],int p,int q,int r) { int *left, right; int n1,n2,i,j,k; n1=q-p+1; n2=r-q; if((left=(int)malloc((n1+1)sizeof(int)))=NULL) { perror("malloc error"); exit(1); } if((right=(int)malloc((n2+1)*sizeof(int)))=NULL) { perror("malloc error"); exit(1); } for(i=0;i<n1;i++){ left[i]= (1) ; } left[i]=MAX; for(i=0; i<n2; i++){ right[i]=arr[q+i+1] } right[i]=MAX; i=0; j=0; for(k=p; k<=r ; k++) { if(left[i]> right[j]) { (2) ; j++; }else { arr[k]=left[i]; i++; } } } void mergeSort(int arr[],int begin,int end){ int mid; if( begin<end ){ mid= (3) ; (4) ; mergeSort(arr,mid+1,end) ; merge(arr,begin,mid,end); } }
参考答案:
问题三 (7)n1+n2
解析(AI 生成):
归并两个长度分别为n1、n2的有序子数组时,每比较一次就有一个元素被写入结果,直到其中一段取完,剩余元素直接搬移不再比较,因此元素之间的比较次数为n1+n2。
问答题
225. 试题四(共9分) 阅读以下说明和C 函数,将应填入_(n)处的语句或语句成分写在答题纸的对应栏内。 【说明1】 函数 deldigit(char*s)的功能是将字符串s中的数字字符去掉,使剩余字符按原次序构成一个新串,并保存在原串空间中。其思路是∶先申请一个与s等长的临时字符串空间并令t指向它,将非数字字符按次序暂存入该空间,最后再复制给s。 【C函数】 void deldigit (char *s) { char *t=(char *)malloc((1));/申请串空间/ int i,k= 0; if (!t) return; for(i = 0;i< strlen(s);i++) if(!(*(s+i)>='0'&& *(s+i)<='9')){ t[k++] =(2); } (3)='\0";/设置串结束标志/strcpy(s,t);free(t); strcpy(s,t); free(t); }
参考答案:
(1)strlen(s)+1 (2)s[i]或*(s+i) (3)t[k]或*(t+k)
解析(AI 生成):
申请空间要容纳原串全部字符再加串结束符,故为strlen(s)+1;循环中把非数字字符依次存入t,填s[i];循环结束后在t的有效长度处补'\0',即t[k]。空间不足会丢失结束标志,导致strcpy越界。
问答题
226. 【问题1】(8分) 根据说明和C代码,填充C代码中的空(1)~(4)。
材料: 试题四(15分) 阅读下列说明和C代码,回答问题,将解答填入答题纸的对应栏内。 【说明】 计算一个整数数组a的最长递增子序列长度的方法描述如下: 假设数组a的长度为n,用数组b的元素b[i]记录以a[i](0%E2%89%A4i%EF%BC%9Cn%E2%80%9D)为结尾元素的最长递增子序列的长度为
;其中b[i]满足最优子结构,可递归定义为:
【C代码】 下面是算法的C语言实现。 (1)常量和变量说明 a:长度为n的整数数组,待求其最长递增子序列 b:长度为n的数组,b[i]记录以a[i](0%E2%89%A4i%3Cn)为结尾元素的最长递增子序列的长 度,其中0≤i<n len:最长递增子序列的长度 i,j:循环变量 temp:临时变量 (2)C程序 #include <stdio.h> int maxL(int*b, int n) { int i, temp=0; for(i=0; (1); i++) { if(b[i]>temp) temp=b[i]; } return temp; } int main() { int n, a[100], b[100], i, j, len; scanf("%d", &n); for(i=0; i<n; i++) { scanf("%d", &a[i]); } b[0]=1; for(i=1; i<n; i++) { for(j=0, len=0; (2) ; j++) { if( a[j]<=a[i]&& (3)) len=b[j]; } (4) ; } Printf("len:%d\n", maxL(b,n)); printf("\n"); }
参考答案:
(1)i<n (2)j<i (3)len<b[j] (4)b[i]=len+1
解析(AI 生成):
b[i]表示以第i个元素结尾的最长递增子序列长度。外层i遍历到n,内层只考察ja[j]且b[j]更大则更新len,最后b[i]=len+1,即以自身结尾的长度加一。
问答题
227. 【问题2】(7分) 根据说明和C代码,算法采用了 (5) 设计策略,时间复杂度为 (6) (用O符号表示)。
材料: 试题四(15分) 阅读下列说明和C代码,回答问题,将解答填入答题纸的对应栏内。 【说明】 计算一个整数数组a的最长递增子序列长度的方法描述如下: 假设数组a的长度为n,用数组b的元素b[i]记录以a[i](0%E2%89%A4i%EF%BC%9Cn%E2%80%9D)为结尾元素的最长递增子序列的长度为
参考答案:
(5)动态规划法 (6)O(n^2)
解析(AI 生成):
以b[i]记录以i结尾的最长递增子序列长度,当前状态由前面所有状态推出,具有最优子结构和重叠子问题,属动态规划。双重循环比较约n(n-1)/2次,时间复杂度为O(n^2)。
问答题
228. 【问题1】(8分) 根据说明和 C代码,填充C代码中的空 (1)~ (4)。
材料: 试题四(共15分) 阅读下列说明和C代码,回答问题1至问题3,将解答写答题纸的对应栏内。 【说明】 生物学上通常采用编辑距离来定义两个物种DNA序列的相似性,从而刻画物种之间的进化关系。具体来说,编辑距离是指将一个字符串变换为另一个字符所需要的最小操作次数。操作有三种,分别为:插入一个字符、删除一个字符以及将一个字符修改为另一个字符。 用字符数组str1和str2分别表示长度分别为len1和len2的字符串,定义二维数组d记录求解编辑距离的子问题最优解,则该二维数组可以递归定义为:
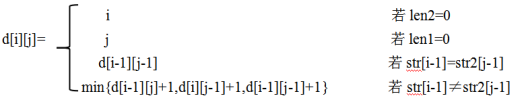
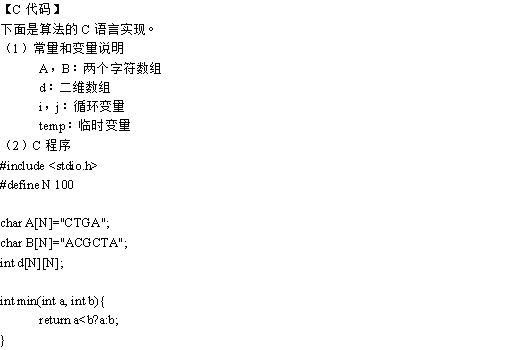
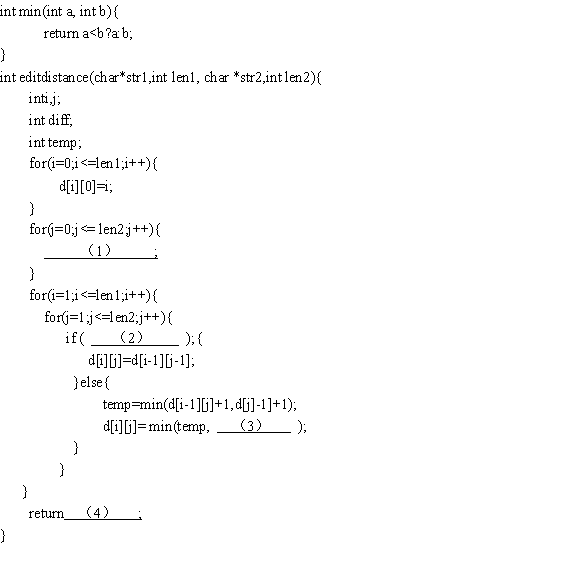
参考答案:
(1)d[0][j]=j (2)str1[i-1]==str2[j-1] (3)d[i-1][j-1]+1 (4) d[len1][len2]
解析(AI 生成):
d[i][j]表示str1前i个字符与str2前j个字符的编辑距离。首行初始化为j,表示全部插入;两字符相同时由d[i-1][j-1]转移,不同时取替换后加1;答案取d[len1][len2]。
问答题
229. 【问题2】 (4分) 根据说明和C代码,算法采用了(5)设计策略,时间复杂度为(6)(用O符号表示,两个字符串的长度分别用m和n表示)。
材料: 试题四(共15分) 阅读下列说明和C代码,回答问题1至问题3,将解答写答题纸的对应栏内。 【说明】 生物学上通常采用编辑距离来定义两个物种DNA序列的相似性,从而刻画物种之间的进化关系。具体来说,编辑距离是指将一个字符串变换为另一个字符所需要的最小操作次数。操作有三种,分别为:插入一个字符、删除一个字符以及将一个字符修改为另一个字符。 用字符数组str1和str2分别表示长度分别为len1和len2的字符串,定义二维数组d记录求解编辑距离的子问题最优解,则该二维数组可以递归定义为:
参考答案:
动态规划法 O(m*n)
解析(AI 生成):
编辑距离逐行逐列递推,每个状态只依赖左、上、左上三个已求状态,具有最优子结构,属动态规划。需填m×n的二维表,每格常数时间,故时间复杂度为O(m*n)。
问答题
230. 【问题3】(3分) 已知两个字符串A="CTGA"和B="ACGCTA",根据说明和C代码,可得出这两个字符串的编辑距离为(7)。
材料: 试题四(共15分) 阅读下列说明和C代码,回答问题1至问题3,将解答写答题纸的对应栏内。 【说明】 生物学上通常采用编辑距离来定义两个物种DNA序列的相似性,从而刻画物种之间的进化关系。具体来说,编辑距离是指将一个字符串变换为另一个字符所需要的最小操作次数。操作有三种,分别为:插入一个字符、删除一个字符以及将一个字符修改为另一个字符。 用字符数组str1和str2分别表示长度分别为len1和len2的字符串,定义二维数组d记录求解编辑距离的子问题最优解,则该二维数组可以递归定义为:
参考答案:
4
解析(AI 生成):
编辑距离是插入、删除、替换的最少次数。两串最长公共子序列为CGA,长度3,故编辑距离为4+6-2×3=4,与按d[i][j]逐格递推填表所得结果一致。
问答题
231. 【问题1】8分 根据【说明】和【C代码】,填充C代码中的空缺处。
材料: 试题四(共15分) 阅读下列说明和C代码,回答下列问题。 【说明】 设有n个货物要装入若干个容量为C的集装箱以便运输,这n个货物的体积分别为{s1,s2,...,sn},且有s1≤c(1≤i≤n)。为节省运输成本,用尽可能少的集装箱来装运这n个货物。 下面分别采用最先适宜策略和最优适宜策略来求解该问题。 最先适宜策略(firstfit)首先将所有的集装箱初始化为空,对于所有货物,按照所给的次序,每次将一个货物装入第一个能容纳它的集装箱中。 最优适宜策略(bestfit)与最先适宜策略类似,不同的是,总是把货物装到能容纳它且目前剩余容量最小的集装箱,使得该箱子装入货物后闲置空间最小。 【C代码】 下面是这两个算法的C语言核心代码。 1.变量说明 n:货物数 C:集装箱容量 s:数组,长度为n,其中每个元素表示货物的体积,下标从0开始 B:数组,长度为n,b[i]表示第i+1个集装箱当前已经装入货物的体积,下标从0开始 i,j:循环变量 k:所需的集装箱数 min:当前所用的各集装箱装入了第i个货物后的最小剩余容量 m:当前所需要的集装箱数 temp:临时变量 2.函数firstfit int firstfit { int i, j; k=0; for(i=0; i<n; i++){ b[i]=0; } for i=0; i<n; i++) { ______; while (C-b [j]<s [i]){ j++; } ______; k=k>(j+1)? k: (j+1); } return k; } 3.函数bestfit int bestfit { int i, j ,min, m, temp; k=0; for (i=0; i<n; i++) { b[i]=0; } for (i=0; i<n; i++) { min=C; m=k+1; for (j=0; j<k+1; j++) { temp=C-b [j]-s [i]; if(temp>0 && temp<min) { ______; m=j; } } ______; k=k>(m+1)? k: (m+1); } return k; }
参考答案:
j=0 b[j]=b[j]+s[i]及其等价形式 min=temp b[m]=b[m]+s[i]及其等价形式
解析(AI 生成):
空(1)把工作下标置0,开始新一轮处理;空(2)、(4)把s[i]累加到对应的b[j]、b[m]上,实现按组求和;空(3)用temp暂存当前最小值,供后续比较替换。按边扫描边累加、边比较取优的思路填空即可。
问答题
232. 试题四(15分) 阅读下列函数说明和C代码,将应填入_(n) 处的字句写在答题纸的对应栏内。 【说明】 函数 int Toplogical(LinkedWDigraph G)的功能是对图 G中的顶点进行拓扑排序,并返回关键路径的长度。其中图G表示一个具有n个顶点的AOE-网,图中顶点从1~n依次编号,图 G的存储结构采用邻接表表示,其数据类型定义如下∶ typedef struct Gnode{ /* 邻接表的表结点类型 / int adjvex; / 邻接顶点编号 / int weight; / 弧上的权值 / struct Gnode nextarC;n / 指示下一个弧的结点 / }Gnode; typedef struct Adjlist{ / 邻接表的头结点类型 / char vdata; / 顶点的数据信息 / struct Gnode Firstadj; / 指向邻接表的第一个表结点 / }Adjlist; typedef struct LinkedWDigraph{ / 图的类型/ int n, e; / 图中顶点个数和边数 */ struct Adjlist head; / 指向图中第一个顶点的邻接表的头结点 */ }LinkedwDigraph; 例如,某AOE-网如图4-1所示,其邻接表存储结构如图4-2所示。 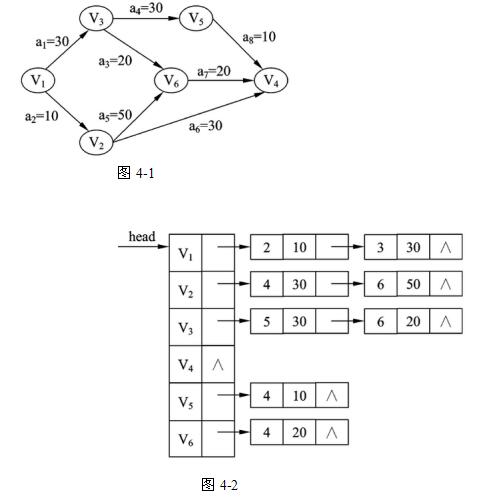 【函数】 int Toplogical (LinkedWDigraph G) { Gnode *p; int j,w,top = 0; int *Stack,*ve,*indegree; ve =(int )malloc((G.n+1) sizeof(int)); indegree =(int *)malloc((G.n+1)*sizeof(int)); /存储网中各顶点的入度/ Stack =(int *)malloc((G.n+1)sizeof(int))); /存储入度为0的顶点的编号/ if(!ve | | !indegree || !Stack)exit (0); for (j= 1;j<= G.n; j++){ ve[ j]= 0;indegree [ j]= 0; }/for/ for(j=1;j<= G.n;j++){/ 求网中各顶点的入度 / p= G.head[ j].Firstadj; while (p){ (1) ;p = p-nextarc; }/while/ }/for/ for (j=l;j<= G.n;j++)/*求网中入度为0的顶点并保存其编号*/ if (!indegree[j])Stack[++top] = j; while(top > 0){ w= (2) ; printf("%c ",G.head[w].vdata); p = G.head[w].Firstadj; while(p) { (3) ; if(!indegree[p→adjvex]) Stack[++top] = p-adjvex; if( (4) ) ve[p→adjvex] = ve[w]+ p→weight; p = p→nextarC; }/ while / }/ while */ return (5) ; }/Toplogical/
材料: 试题四(15分) 阅读下列函数说明和C代码,将应填入_(n) 处的字句写在答题纸的对应栏内。 【说明】 函数 int Toplogical(LinkedWDigraph G)的功能是对图 G中的顶点进行拓扑排序,并返回关键路径的长度。其中图G表示一个具有n个顶点的AOE-网,图中顶点从1~n依次编号,图 G的存储结构采用邻接表表示,其数据类型定义如下∶ typedef struct Gnode{ /* 邻接表的表结点类型 / int adjvex; / 邻接顶点编号 / int weight; / 弧上的权值 / struct Gnode nextarC;n / 指示下一个弧的结点 / }Gnode; typedef struct Adjlist{ / 邻接表的头结点类型 / char vdata; / 顶点的数据信息 / struct Gnode Firstadj; / 指向邻接表的第一个表结点 / }Adjlist; typedef struct LinkedWDigraph{ / 图的类型/ int n, e; / 图中顶点个数和边数 */ struct Adjlist head; / 指向图中第一个顶点的邻接表的头结点 */ }LinkedwDigraph; 例如,某AOE-网如图4-1所示,其邻接表存储结构如图4-2所示。
参考答案:
(1)indegree【p→adjvex】++,及其等价形式 (2)Stack【top--】,及其等价形式 (3)indegree【p→adjvex】--,及其等价形式 (4)ve【w】+p→weight>ve【p→adjvex】,及其等价形式 (5)ve【w】,及其等价形式
解析(AI 生成):
先按弧统计各顶点入度,入度为0者入栈;拓扑排序弹栈取顶点w,沿其出边把邻接点入度减1,减为0则入栈;同时用ve[w]+权值更新邻接点的最早发生时间并取较大者,最大ve值即关键路径长度。
问答题
233. 【问题1】(8分) 根据以上说明和C代码,填充C代码中的空(1)~(4)。
材料: 试题四(共15分) 阅读下列说明和C代码,回答问题1至问题3,将解答写在答题纸的对应栏内。 【说明】 某工程计算中要完成多个矩阵相乘(链乘)的计算任务。 两个矩阵相乘要求第一个矩阵的列数等于第二个矩阵的行数,计算量主要由进行乘法运算的次数决定。采用标准的矩阵相乘算法,计算AmnBnp,需要mnp次乘法运算。 矩阵相乘满足结合律,多个矩阵相乘,不同的计算顺序会产生不同的计算量。以矩阵A110100,A21005,A3550三个矩阵相乘为例,若按(A1A2)A3计算,则需要进行101005+10550=7500次乘法运算;若按A1*(A2A3)计算,则需要进行100550+1010050=75000次乘法运算。可见不同的计算顺序对计算量有很大的影响。 矩阵链乘问题可描述为:给定n个矩阵<A1,A2,….An>,矩阵Ai的维数为pi-1Pi,其中i = 1,2,….n。确定一种乘法顺序,使得这n个矩阵相乘时进行乘法的运算次数最少。 由于可能的计算顺序数量非常庞大,对较大的n,用蛮力法确定计算顺序是不实际的。经过对问题进行分析,发现矩阵链乘问题具有最优子结构,即若A1A2…An的一个最优计算顺序从第k个矩阵处断开,即分为A1A2*….Ak和Ak+1Ak+2…An两个子问题,则该最优解应该包含A1A2*…Ak的一个最优计算顺序和Ak+1Ak+2*…An的一个最优计算顺序。据此构造递归式,
其中,cost[i][j]表示Ai+1Ai+2...Aj+1的最优计算的计算代价。最终需要求解cost[0][n-1]。 【C代码】 算法实现采用自底向上的计算过程。首先计算两个矩阵相乘的计算量,然后依次计算3个矩阵、4个矩阵、…、n个矩阵相乘的最小计算量及最优计算顺序。下面是算法的C语言实现。 (1)主要变量说明 n:矩阵数 seq[]:矩阵维数序列 cost[][]:二维数组,长度为nn,其中元素cost[i][j]表示Ai+1Ai+2*…Aj+1的最优计算的计算代价 trace[][]:二维数组,长度为nn,其中元素trace[i][j]表示Ai+1Ai+2*Aj+1的最优计算对应的划分位置,即k (2)函数cmm define N 100 intcost[N][N]; inttrace[N][N]; int cmm(int n,int seq[]){ int tempCost; int tempTrace; int i,j,k,p; int temp; for(i=0;i<n;i++){ cost[i][i] =0;} for(p=1;p<n;p++){ for(i=0; (1) ;i++){ (2); tempCost = -1; for(k = i;k<j;k++){ temp = (3) ; if(tempCost==-1||tempCost>temp){ tempCost = temp; (4) ; } } cost[i][j] = tempCost; trace[i][j] = tempTrace; } } return cost[0][n-1]; }
参考答案:
(1)i<n-p (2)j=i+p (3)cost[i][k]+cost[k+1][j]+seq[i]* seq[k+1]* seq[j+1] (4)tempTrace=k
解析:
本题考查矩阵连乘最优调度问题,是一种动态规划算法。 第一问: 1.上述算法中,第一循环是给n个cost[i][j]赋初值0;第二个循环是外循环,其循环变量P是矩阵连乘的规模,(p=1时)先计算出所有规模为2的cost[i,i+1],(p=2是)再计算出所有规模为3的cost[i,i+2],…,最后计算出来的即为我们所求的cost[1,n-1],所以(1)填写i<n-p;
问答题
234. 【问题 1】(8分) 根据题干说明,填充 C 代码中的空(1)-(4)。
材料: 试题四(15分) 阅读下列说明和 C 代码,回答问题 1至问题 3,将解答写在答题纸的对应栏内。 【说明】 n 皇后问题描述为:在一个n×n 的棋盘上摆放 n 个皇后,要求任意两个皇后不能冲突, 即任意两个皇后不在同一行、同一列或者同一斜线上。 算法的基本思想如下: 将第i个皇后摆放在第i行,i 从1开始,每个皇后都从第1列开始尝试。尝试时判断在该列摆放皇后是否与前面的皇后有冲突,如果没有冲突,则在该列摆放皇后,并考虑摆放下一个皇后;如果有冲突,则考虑下一列。如果该行没有合适的位置,回溯到上一个皇后,考虑在原来位置的下一个位置上继续尝试摆放皇后……直到找到所有合理摆放方案。 【C代码】 下面是算法的C语言实现。 (1)常量和变量说明 n: 皇后数,棋盘规模为n×n queen[]: 皇后的摆放位置数组,queen[i]表示第i个皇后的位置,1≤queen[i]≤n (2)C程序 #include <stdio.h> #define n 4 int queen[n+1]; void Show() { /输出所有皇后摆放方案/ int i; printf("("); for(int i = 1; i <= n; i++) { printf(" %d",queen[i]); } printf(")\n"); } int Place(int j) { /检查当前列能否放置皇后,不能放返回0,能返回1/ int i; for(i = 1; i < j; i++) { /检查与已摆放的皇后是否在同一列或同一斜线上/ if( (1) || abs(queen[i] - queen[j]) == (j - i)) { return 0; } } return (2) ; } void Nqueen(int j) { int i; for(i = 1; i <= n; i++) { queen[j] = i; if( (3) ) { if(j == n) { /如果所有皇后都摆放好,则输出当前摆放方案/ Show(); } else { /否则继续摆放下一个皇后/ (4) ; } } } } int main() { Nqueen(1); return 0; }
参考答案:
1.queen[i]==queen[j]或其他等价形式 2.1 3.Place(j)&&j<=n或Place(j)或其他等价形式 4.Nqueen(j+1)
解析(AI 生成):
queen[i]存第i行皇后所在列号。同列冲突为queen[i]==queen[j],同对角线为行列差的绝对值相等,无冲突返回1;逐列试放,Place(j)成立且未越界时递归Nqueen(j+1)进入下一行。
问答题
235. 【问题2】(3分) 根据题干说明和 C 代码,算法采用的设计策略为 (5) 。
材料: 试题四(15分) 阅读下列说明和 C 代码,回答问题 1至问题 3,将解答写在答题纸的对应栏内。 【说明】 n 皇后问题描述为:在一个n×n 的棋盘上摆放 n 个皇后,要求任意两个皇后不能冲突, 即任意两个皇后不在同一行、同一列或者同一斜线上。 算法的基本思想如下: 将第i个皇后摆放在第i行,i 从1开始,每个皇后都从第1列开始尝试。尝试时判断在该列摆放皇后是否与前面的皇后有冲突,如果没有冲突,则在该列摆放皇后,并考虑摆放下一个皇后;如果有冲突,则考虑下一列。如果该行没有合适的位置,回溯到上一个皇后,考虑在原来位置的下一个位置上继续尝试摆放皇后……直到找到所有合理摆放方案。 【C代码】 下面是算法的C语言实现。 (1)常量和变量说明 n: 皇后数,棋盘规模为n×n queen[]: 皇后的摆放位置数组,queen[i]表示第i个皇后的位置,1≤queen[i]≤n (2)C程序 #include <stdio.h> #define n 4 int queen[n+1]; void Show() { /输出所有皇后摆放方案/ int i; printf("("); for(int i = 1; i <= n; i++) { printf(" %d",queen[i]); } printf(")\n"); } int Place(int j) { /检查当前列能否放置皇后,不能放返回0,能返回1/ int i; for(i = 1; i < j; i++) { /检查与已摆放的皇后是否在同一列或同一斜线上/ if( (1) || abs(queen[i] - queen[j]) == (j - i)) { return 0; } } return (2) ; } void Nqueen(int j) { int i; for(i = 1; i <= n; i++) { queen[j] = i; if( (3) ) { if(j == n) { /如果所有皇后都摆放好,则输出当前摆放方案/ Show(); } else { /否则继续摆放下一个皇后/ (4) ; } } } } int main() { Nqueen(1); return 0; }
参考答案:
回溯法
解析(AI 生成):
逐行放置皇后,每行从第1列起试探,与已放皇后冲突就换列;本行所有列都不行则退回上一行改写其列号。这种“试探—冲突—回退”的系统搜索即回溯法。
问答题
236. 【问题 3】(4分) 当 n=4 时,有 (6) 种摆放方式,分别为 (7) 。
材料: 试题四(15分) 阅读下列说明和 C 代码,回答问题 1至问题 3,将解答写在答题纸的对应栏内。 【说明】 n 皇后问题描述为:在一个n×n 的棋盘上摆放 n 个皇后,要求任意两个皇后不能冲突, 即任意两个皇后不在同一行、同一列或者同一斜线上。 算法的基本思想如下: 将第i个皇后摆放在第i行,i 从1开始,每个皇后都从第1列开始尝试。尝试时判断在该列摆放皇后是否与前面的皇后有冲突,如果没有冲突,则在该列摆放皇后,并考虑摆放下一个皇后;如果有冲突,则考虑下一列。如果该行没有合适的位置,回溯到上一个皇后,考虑在原来位置的下一个位置上继续尝试摆放皇后……直到找到所有合理摆放方案。 【C代码】 下面是算法的C语言实现。 (1)常量和变量说明 n: 皇后数,棋盘规模为n×n queen[]: 皇后的摆放位置数组,queen[i]表示第i个皇后的位置,1≤queen[i]≤n (2)C程序 #include <stdio.h> #define n 4 int queen[n+1]; void Show() { /输出所有皇后摆放方案/ int i; printf("("); for(int i = 1; i <= n; i++) { printf(" %d",queen[i]); } printf(")\n"); } int Place(int j) { /检查当前列能否放置皇后,不能放返回0,能返回1/ int i; for(i = 1; i < j; i++) { /检查与已摆放的皇后是否在同一列或同一斜线上/ if( (1) || abs(queen[i] - queen[j]) == (j - i)) { return 0; } } return (2) ; } void Nqueen(int j) { int i; for(i = 1; i <= n; i++) { queen[j] = i; if( (3) ) { if(j == n) { /如果所有皇后都摆放好,则输出当前摆放方案/ Show(); } else { /否则继续摆放下一个皇后/ (4) ; } } } } int main() { Nqueen(1); return 0; }
参考答案:
两种 2413,3142
解析(AI 生成):
n=4时四皇后只有两种摆放方式,用queen[i]表示第i行皇后的列号,即2413与3142,二者互为镜像;其他排列必在某两行同列或同对角线冲突,故不成立。
问答题
237. 【问题1】(8分) 根据说明和C代码,填充C代码中的空(1)~(4)。
材料: 试题四(15分) 阅读下列说明和C代码,回答问题,将解答填入答题纸的对应栏内。 【说明】 计算一个整数数组a的最长递增子序列长度的方法描述如下: 假设数组a的长度为n,用数组b的元素b[i]记录以a[i](0%E2%89%A4i%EF%BC%9Cn%E2%80%9D)为结尾元素的最长递增子序列的长度为
;其中b[i]满足最优子结构,可递归定义为:
【C代码】 下面是算法的C语言实现。 (1)常量和变量说明 a:长度为n的整数数组,待求其最长递增子序列 b:长度为n的数组,b[i]记录以a[i](0%E2%89%A4i%3Cn)为结尾元素的最长递增子序列的长 度,其中0≤i<n len:最长递增子序列的长度 i,j:循环变量 temp:临时变量 (2)C程序 #include <stdio.h> int maxL(int*b, int n) { int i, temp=0; for(i=0; (1); i++) { if(b[i]>temp) temp=b[i]; } return temp; } int main() { int n, a[100], b[100], i, j, len; scanf("%d", &n); for(i=0; i<n; i++) { scanf("%d", &a[i]); } b[0]=1; for(i=1; i<n; i++) { for(j=0, len=0; (2) ; j++) { if( a[j]<=a[i]&& (3)) len=b[j]; } (4) ; } Printf("len:%d\n", maxL(b,n)); printf("\n"); }
参考答案:
(1)i<n (2)j<i (3)len<b[j] (4)b[i]=len+1
解析(AI 生成):
b[i]表示以第i个元素结尾的最长递增子序列长度。外层i遍历至n,内层只枚举ja[j]且b[j]更长时更新len,最终b[i]=len+1,即以自身结尾长度加一。
问答题
238. 【问题2】(7分) 根据说明和C代码,算法采用了 (5) 设计策略,时间复杂度为 (6) (用O符号表示)。
材料: 试题四(15分) 阅读下列说明和C代码,回答问题,将解答填入答题纸的对应栏内。 【说明】 计算一个整数数组a的最长递增子序列长度的方法描述如下: 假设数组a的长度为n,用数组b的元素b[i]记录以a[i](0%E2%89%A4i%EF%BC%9Cn%E2%80%9D)为结尾元素的最长递增子序列的长度为
参考答案:
(5)动态规划法 (6)O(n^2)
解析(AI 生成):
当前状态由之前所有状态递推得到,具备最优子结构与重叠子问题,属动态规划。内外两层循环共约n(n-1)/2次比较,时间复杂度为O(n^2)。
问答题
239. 【问题 1】(8分) 根据说明,填充 C 代码中的空(1)~(4)。
材料: 试题四(15分) 阅读下列说明和 C 代码,回答问题 1至问题 2,将解答写在答题纸的对应栏内。 【说明】 某公司购买长钢条,将其切割后进行出售。切割钢条的成本可以忽略不计,钢条的 长度为整英寸。已知价格表 P,其中中 Pi(i=1,2,...,m)表示长度为 i 英寸的钢条的价格。现要求解使销售收益最大的切割方案。 求解此切割方案的算法基本思想如下: 假设长钢条的长度为 n 英寸,最佳切割方案的最左边切割段长度为 i 英寸,则继续求解剩余长度为 n-i 英寸钢条的最佳切割方案。考虑所有可能的 i,得到的最大收益 rn对应的切割方案即为最佳切割方案。rn的递归定义如下: rn =max1≤ i ≤n(pi +rn-i) 对此递归式,给出自顶向下和自底向上两种实现方式: 【C代码】 /*常量和变量说明 n:长钢条的长度 P[]:价格数组 */ #define LEN 100 int Top_Down_Cut_Rod(int P[], int n){/自顶向下/ int r = 0; int i; if (n == 0){ return 0; } for (i = 1; (1); i++){ int tmp = P[i] + Top_Down_Cut_Rod(p, n - i); r = (r >= tmp) ? r : tmp; } return r; } int Bottom_Up_Cut_Rod(int p[], int n){ /自底向上/ int r[LEN] = { 0 }; int temp = 0; int i, j; for (j = 1; j <= n; j++){ temp = 0; for (i = 1; (2); i++){ temp = (3); } (4); } return r[n]; }
参考答案:
(1)i<=n (2)i<=j (3)temp>=p[i]+r[j-i]?temp:p[i]+r[j-i]或其等效形式 (4)r[j]=temp
解析(AI 生成):
r[j]表示规模为j时的最优收益,枚举第一段长度i(i≤j且i≤n),收益为p[i]+r[j-i],用temp保存最大值,最后r[j]=temp,属于动态规划的自底向上递推。
问答题
240. 【问题1】(8分) 根据说明和C代码,填充C代码中的空。。
材料: 试题四(共15分) 阅读下列说明和C代码,回答问题1至问题3,将解答写在答题纸的对应栏内。 【说明】 设有m台完全相同的机器运行n个独立的任务,运行任务i所需要的时间为ti,要求确定一个调度方案是的完成所有任务所需要的时间最短。 假设任务已经按照其运行时间从大到小排序,算法基于最长运行时间作业优先的策略;按顺序先把每个1务分配到一台机器上,然后将剩余的任务一次放入最先空闲的机器。 【C代码】 下面是算法的C语言实现。 常量和变量说明 m:机器数。 n:任务数。 t[]:输入数组,长度为n,其中每个元素表示任务的运行时间,下标从0开始。 s[][]:二维数组,长度为m*n,下标从0开始,其中元素s[i][j]表示机器i运行的任务j的编号。 d[]:数组,长度为m其中元素d[i]表示机器i的运行时间,下标从0开始。 count[]:数组,长度为m,下标从0开始,其中元素count[i]表示机器i运行的任务数。 i:循环变量。 j:循环变量。 k:临时变量。 max:完成所有任务的时间。 min:临时变量。 函数schedule void schedule12{ int i,j,k max=0; for(i=0;i<m;i++){ d[i]=0; for(j=0;j<n;j++){ s[i][j]=0; } } for(i=0;i<m;i++){ //分配前m个任务 s[i][0]=i; (1); count[i]=1; } for((2);i<n;i++){ //分配后n-m个任务 int min=d[0]; k=0; for(j=1;j<n;j++){ //确定空闲机器 if(min>d[j]){ min=d[j]; k=j; //机器k空闲 } } (3); count[k]=count[k]+1; d[k]=d[k]+t[i]; for(i=0;i<m;i++){ //确定完成所有任务所需要的时间 if((4)){ max=d[i]; } } } }
参考答案:
1.(1)d[i]= t[i] ,,(2)i=m , ,,(3)s[k][count[k]]=i ,,(4)Max<d[i]
解析:
本题考查算法的设计和分析技术中的贪心算法。 贪心算法(Greedy algorithm)是一种对某些求最优解问题的更简单、更迅速的设计技术。用贪婪法设计算法的特点是一步一步地进行,常以当前情况为基础根据某个优化测度作最优选择,而不考虑各种可能的整体情况,它省去了为找最优解要穷尽所有可能而必须耗费的大量时间,它采用自顶向下,以迭代的方法做出相继的贪心选择,每做一次贪心选择就将所求问题简化为一个规模更小的子问题,通过每一步贪心选择,可得到问题的一个最优解,虽然每一步上都要保证能获得局部最优解,但由此产生的全局解有时不一定是最优的,所以贪婪法不要回溯。 【问题1】 根据上述思想和题中的说明,首先将s[][]和d[]数组初始化为0,然后要做的就是按要求“算法基于最长运行时间作业优先的策略,按顺序先把每个任务分配到一台机器上”,可以推断(1)处为d[i] = t[i],此后需将剩下的n-m个任务按顺序分配给空闲的机器,故(2)处将i初始化为以m为起始的任务,即i=m,(3)处所在的位置是分配后n-m个任务,在这个过程中,必须要对s矩阵的内容进行修改,但目前已经出的代码没有这个内容,所以此处必然是对s的修改。从对s矩阵的注释可以了解到,s[i][j]表示机器i运行的任务j的编号,此时涉及任务的机器号为k,而待分配的任务i是机器的第count[k]个任务,即s[k][count[k]]=i,(4)处已经完成了任务的运行,此处需要统计所有机器所运行任务的最长时间,对于每个机器i的运行时间为d[i],存在d[i]大于当前的最大时间Max,就将当前机器的运行时间d[i]赋给Max,即Max<d[i]。
问答题
241. 【问题2】(3分) 根据说明和C代码,该问题采用了(5)算法设计策略,时间复杂度为(6)(用O符号表示)
材料: 试题四(共15分) 阅读下列说明和C代码,回答问题1至问题3,将解答写在答题纸的对应栏内。 【说明】 设有m台完全相同的机器运行n个独立的任务,运行任务i所需要的时间为ti,要求确定一个调度方案是的完成所有任务所需要的时间最短。 假设任务已经按照其运行时间从大到小排序,算法基于最长运行时间作业优先的策略;按顺序先把每个1务分配到一台机器上,然后将剩余的任务一次放入最先空闲的机器。 【C代码】 下面是算法的C语言实现。 常量和变量说明 m:机器数。 n:任务数。 t[]:输入数组,长度为n,其中每个元素表示任务的运行时间,下标从0开始。 s[][]:二维数组,长度为m*n,下标从0开始,其中元素s[i][j]表示机器i运行的任务j的编号。 d[]:数组,长度为m其中元素d[i]表示机器i的运行时间,下标从0开始。 count[]:数组,长度为m,下标从0开始,其中元素count[i]表示机器i运行的任务数。 i:循环变量。 j:循环变量。 k:临时变量。 max:完成所有任务的时间。 min:临时变量。 函数schedule void schedule12{ int i,j,k max=0; for(i=0;i<m;i++){ d[i]=0; for(j=0;j<n;j++){ s[i][j]=0; } } for(i=0;i<m;i++){ //分配前m个任务 s[i][0]=i; (1); count[i]=1; } for((2);i<n;i++){ //分配后n-m个任务 int min=d[0]; k=0; for(j=1;j<n;j++){ //确定空闲机器 if(min>d[j]){ min=d[j]; k=j; //机器k空闲 } } (3); count[k]=count[k]+1; d[k]=d[k]+t[i]; for(i=0;i<m;i++){ //确定完成所有任务所需要的时间 if((4)){ max=d[i]; } } } }
参考答案:
2.(5)贪心 ,,(6)O(mn)
解析:
【问题2】 根据以上分析,(5)处采用了贪心算法的策略,而时间复杂度由算法中的两个嵌套for循环和两个非嵌套for循环确定,即为O(mn)。
问答题
242. 【问题3】(4分) 考虑实例m=3(编号0~2),n=7(编号0~6),各任务的运行时间为{16,14,6,5,4,3,2}。则在机器0、1和2上运行的任务分别为(7)、(8)和(9)(给出任务编号)。从任务开始运行到完成所需要的时间为(10)。
材料: 试题四(共15分) 阅读下列说明和C代码,回答问题1至问题3,将解答写在答题纸的对应栏内。 【说明】 设有m台完全相同的机器运行n个独立的任务,运行任务i所需要的时间为ti,要求确定一个调度方案是的完成所有任务所需要的时间最短。 假设任务已经按照其运行时间从大到小排序,算法基于最长运行时间作业优先的策略;按顺序先把每个1务分配到一台机器上,然后将剩余的任务一次放入最先空闲的机器。 【C代码】 下面是算法的C语言实现。 常量和变量说明 m:机器数。 n:任务数。 t[]:输入数组,长度为n,其中每个元素表示任务的运行时间,下标从0开始。 s[][]:二维数组,长度为m*n,下标从0开始,其中元素s[i][j]表示机器i运行的任务j的编号。 d[]:数组,长度为m其中元素d[i]表示机器i的运行时间,下标从0开始。 count[]:数组,长度为m,下标从0开始,其中元素count[i]表示机器i运行的任务数。 i:循环变量。 j:循环变量。 k:临时变量。 max:完成所有任务的时间。 min:临时变量。 函数schedule void schedule12{ int i,j,k max=0; for(i=0;i<m;i++){ d[i]=0; for(j=0;j<n;j++){ s[i][j]=0; } } for(i=0;i<m;i++){ //分配前m个任务 s[i][0]=i; (1); count[i]=1; } for((2);i<n;i++){ //分配后n-m个任务 int min=d[0]; k=0; for(j=1;j<n;j++){ //确定空闲机器 if(min>d[j]){ min=d[j]; k=j; //机器k空闲 } } (3); count[k]=count[k]+1; d[k]=d[k]+t[i]; for(i=0;i<m;i++){ //确定完成所有任务所需要的时间 if((4)){ max=d[i]; } } } }
参考答案:
3.(7)0 ,,(8)1、5 (9)2、3、4、6 (10)17
解析:
【问题3】 根据题中算法的思想将任务的前三个任务分给三个机器,再将接下来的任务分给最先空闲的机器,故可知机器0运行任务0,机器1运行任务1、5,机器3运行任务2、3、4、6;且运行的最长时间为17。
问答题
243. 【问题3】3分 考虑实例n=10,C=10,各个货物的体积为{4,2,7,3,5,4,2,3,6,2}。该实例在最先适宜和最优适宜策略下所需的集装箱数分别为______和______。考虑一般的情况,这两种求解策略能否确保得到最优解?______(能或否)。
材料: 试题四(共15分) 阅读下列说明和C代码,回答下列问题。 【说明】 设有n个货物要装入若干个容量为C的集装箱以便运输,这n个货物的体积分别为{s1,s2,...,sn},且有s1≤c(1≤i≤n)。为节省运输成本,用尽可能少的集装箱来装运这n个货物。 下面分别采用最先适宜策略和最优适宜策略来求解该问题。 最先适宜策略(firstfit)首先将所有的集装箱初始化为空,对于所有货物,按照所给的次序,每次将一个货物装入第一个能容纳它的集装箱中。 最优适宜策略(bestfit)与最先适宜策略类似,不同的是,总是把货物装到能容纳它且目前剩余容量最小的集装箱,使得该箱子装入货物后闲置空间最小。 【C代码】 下面是这两个算法的C语言核心代码。 1.变量说明 n:货物数 C:集装箱容量 s:数组,长度为n,其中每个元素表示货物的体积,下标从0开始 B:数组,长度为n,b[i]表示第i+1个集装箱当前已经装入货物的体积,下标从0开始 i,j:循环变量 k:所需的集装箱数 min:当前所用的各集装箱装入了第i个货物后的最小剩余容量 m:当前所需要的集装箱数 temp:临时变量 2.函数firstfit int firstfit { int i, j; k=0; for(i=0; i<n; i++){ b[i]=0; } for i=0; i<n; i++) { ______; while (C-b [j]<s [i]){ j++; } ______; k=k>(j+1)? k: (j+1); } return k; } 3.函数bestfit int bestfit { int i, j ,min, m, temp; k=0; for (i=0; i<n; i++) { b[i]=0; } for (i=0; i<n; i++) { min=C; m=k+1; for (j=0; j<k+1; j++) { temp=C-b [j]-s [i]; if(temp>0 && temp<min) { ______; m=j; } } ______; k=k>(m+1)? k: (m+1); } return k; }
参考答案:
1.j=0 b[j]=b[j]+s[i]及其等价形式 min=temp b[m]=b[m]+s[i]及其等价形式 2.贪心、贪心、O(n^2)、O(n^2) 3.5,4,否
解析:
- 结合问题1的分析结果,根据题干所给出的C代码,采用最先适宜策略的函数firstfit采用了贪心算法设计策略。该函数共有两个for循环,且其中1个for循环内部嵌套了一个while循环,其时间复杂度为O(n2)。 采用最优适宜策略的函数bestfit也采用了贪心算法设计策略。该函数有1个for循环和1个两重for循环,其时间复杂度也为O(n2)。
- 依题意,集装箱容量C=10,10个货物的体积分别为{4,2,7,3,5,4,2,3,6,2},采用函数firstfit的最先适宜策略所需的集装箱数5个,每个集装箱的装箱情况分别为(4,2,3)、(7,2)、(5,4)、(3,6)、(2)。采用函数bestfit的最优适宜策略所需的集装箱数4个,每个集装箱的装箱情况分别为(4,2,4)、(7,3)、(5,2,3)、(6,2)。 考虑更一般的情况,以上两种求解策略不能确保得到最优解。例如,当将这10个货物中第1个给出的货物向后移动两个位置,即所给出的货物次序调整为{2,7,4,3,5,4,2,3,6,2},采用函数bestit的最优适宜策略所需的集装箱数将变为5个,每个集装箱的装箱情况分别为(2,7)、(4,3,2)、(5,4)、(3,6)、(2)。
问答题